Analyse
Un signal robots.txt commun pour refuser l'entraînement des IA : ce que soutiennent OpenAI, Google, Microsoft et Anthropic
Un brouillon propose le jeton robots.txt __usage_ai-training pour refuser l'entraînement des IA : ce qu'il couvre, ce qu'il exclut, les dates de Microsoft.
Au 31 octobre 2026, la proposition est un groupe robots.txt nommé __usage_ai-training, décrit dans un brouillon de l'IETF daté du 30 octobre. Selon SiliconANGLE, Google, Microsoft, Anthropic et OpenAI soutiennent une norme à venir sur cette base. Ce n'est pas encore une norme : le brouillon est individuel et non approuvé par l'IETF, et le signal est une préférence que les exploitants de robots respectent volontairement.
L'essentiel
- Ce que c'est : un groupe robots.txt ordinaire dont le nom est
__usage_ai-training. Aucune nouvelle directive n'est ajoutée. - Ce que ça couvre : l'usage d'un contenu pour l'entraînement des IA. Ni l'exploration, ni la recherche, ni l'ancrage ne sont concernés.
- Où en est-on : un brouillon individuel. Microsoft confirme ses propres dates (1er février 2027). Google suivrait en 2027 et OpenAI dans les prochains mois, selon la presse. Meta ne s'est pas engagée.
- Limites : il exprime une préférence. Le respect est volontaire et rien ne garantit l'exclusion de l'entraînement.
Que soutiennent exactement ces entreprises ?
Le texte s'intitule « Machine-Readable Training Preference Signal » (draft-kelley-aipref-training-preference-signal-00) et a pour auteur Kevin Kelley, d'Anthropic. Il est daté du 30 octobre 2026 et expire le 3 mai 2027. C'est un « Individual Internet-Draft » visant le statut Standards Track, et le brouillon précise qu'il n'est pas approuvé par l'IETF (IETF Datatracker).
Selon SiliconANGLE (30 octobre 2026), Google, Microsoft, Anthropic et OpenAI soutiennent une norme à venir. Une seule entrée robots.txt bloquerait tous les robots qui collectent des données d'entraînement pour des modèles génératifs. Elle ne s'appliquerait pas aux modèles qui font « exclusivement des tâches non génératives ». Meta a exprimé son soutien à l'idée mais ne s'est pas engagée (SiliconANGLE).
Seul le calendrier de Microsoft est confirmé par une source primaire que nous avons lue.
Comment l'écrire dans robots.txt ?
L'exemple du brouillon lui-même :
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Disallow exprime une préférence contre l'usage du contenu pour l'entraînement, et Allow une préférence pour. Les règles sont celles de la RFC 9309, et la correspondance la plus longue l'emporte. La section 4.2 du brouillon indique qu'un groupe générique User-Agent: * ne vaut pas pour ce jeton : le groupe doit donc être écrit explicitement.
Le sens suit la définition d'« AI Training » du groupe de travail AI Preferences de l'IETF (IETF AI Preferences).
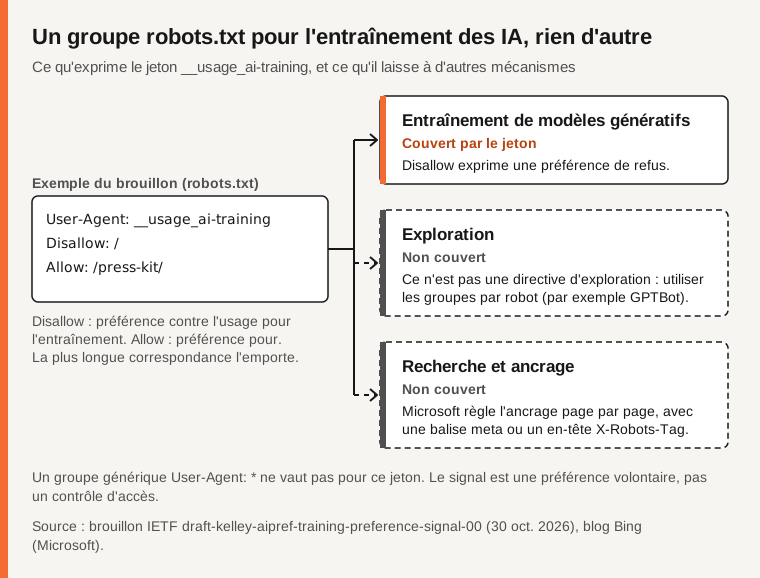
Source : brouillon IETF (30 octobre 2026), blog Bing, vérifié le 2026-10-31.
Que couvre-t-il, et que ne couvre-t-il pas ?
Il faut distinguer trois choses : l'entraînement (modifier les paramètres appris d'un modèle génératif), la recherche (indexation et classement) et l'ancrage (utiliser une page pour répondre à une question).
Le brouillon précise que le jeton n'est « pas une directive pour le comportement d'exploration » (« not a directive for crawling behavior »). Pour limiter l'exploration, il renvoie aux groupes par robot, comme GPTBot. Des accords privés peuvent prévaloir (section 4.5).
Microsoft trace la même ligne sur le blog Bing. Il distingue « AI Training » de « AI Grounding », et l'indexation et le classement de la recherche classique ne sont pas de l'ancrage. L'entraînement passe par le jeton __usage_ai-training, avec Allow par défaut et Disallow pour refuser. L'ancrage n'a pas de réglage robots.txt : il se règle page par page, avec une balise meta (name="Bingbot") ou un en-tête X-Robots-Tag, avec des valeurs comme ai-grounding:disallow ou ai-grounding:disallowextended. Les deux réglages sont indépendants, et un réglage de page prévaut sur robots.txt (blog Bing).
Microsoft ajoute que ces préférences ne changent pas l'éligibilité aux résultats Bing classiques, et qu'un robots.txt qui bloque Bingbot bloque toujours l'exploration : le réglage gouverne l'usage, pas l'accès. Refuser l'ancrage peut réduire la visibilité de la marque dans les expériences d'IA. Il ne garantit ni inclusion, ni trafic, ni paiement, et ne crée pas de licence.
Pour OpenAI, la presse indique que le jeton ne remplace pas les contrôles existants. La documentation existante d'OpenAI dit que refuser GPTBot signale que le contenu ne doit pas servir à entraîner ses modèles de fondation génératifs, que OAI-SearchBot gère la recherche séparément, et que ChatGPT-User, qui agit à la demande d'un utilisateur, peut ne pas suivre robots.txt (OpenAI).
Le signal n'a pas de force juridique par lui-même, qui dépend du droit de chaque pays. Il n'efface pas les contenus déjà utilisés.
Quand sera-t-il effectif ?
Du côté de Microsoft, selon son blog : des réglages temporaires d'ancrage arrivent dans Bing Webmaster Tools le 15 décembre 2026, seulement pour les sites qui utilisent NoArchive ou NoCache à cette date. Les nouvelles préférences d'entraînement et d'ancrage commencent à s'appliquer au fil des explorations le 1er février 2027. Le 1er mars 2027, NoArchive et NoCache ne sont plus lus comme préférences d'entraînement ou d'ancrage. Les réglages temporaires d'ancrage prennent fin le 30 septembre 2027.
Pour les autres, seule la presse s'exprime. Selon SiliconANGLE, Google suivra « l'an prochain » (2027) et OpenAI prévoit des contrôles similaires « dans les prochains mois ». Nous n'avons trouvé aucune déclaration de mise en œuvre d'Anthropic dans les sources lues, donc nous n'en affirmons aucune.
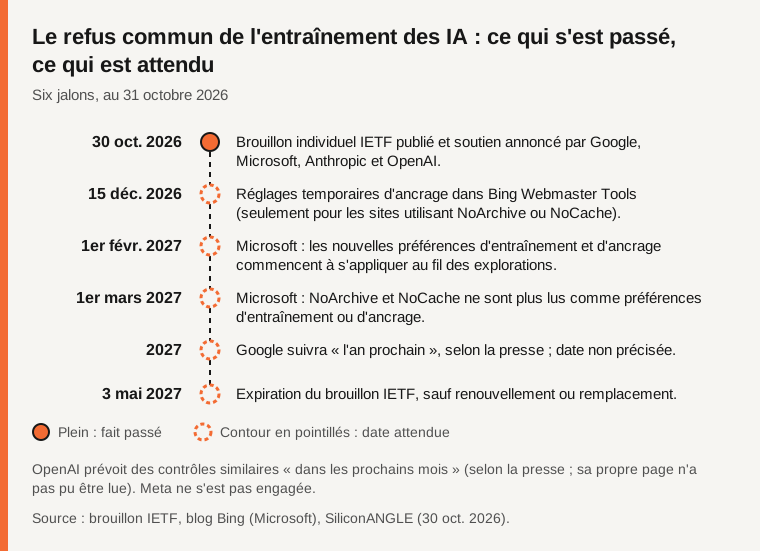
Source : brouillon IETF, blog Bing, SiliconANGLE, vérifié le 2026-10-31. Les faits passés sont pleins, les dates attendues en contour.
Tableau comparatif
| Entreprise | Position au 31 oct. 2026 | Calendrier | Source |
|---|---|---|---|
| Microsoft | Documente le jeton __usage_ai-training et des réglages d'ancrage séparés | 1er févr. 2027 : les préférences commencent à s'appliquer | Blog Bing |
| Soutient la norme à venir, selon la presse | « L'an prochain » (2027), selon la presse | SiliconANGLE | |
| OpenAI | Soutient ; prévoit des contrôles similaires, qui ne remplacent pas les existants, selon la presse | « Dans les prochains mois », selon la presse | SiliconANGLE |
| Anthropic | Soutient, selon la presse ; son employé est l'auteur du brouillon | Aucune déclaration de mise en œuvre trouvée | SiliconANGLE, brouillon IETF |
| Meta | A exprimé son soutien à l'idée, sans engagement | Aucun | SiliconANGLE |
Questions fréquentes
Faut-il changer mon robots.txt dès maintenant ?
Rien dans les sources lues ne promet un respect immédiat. Le jeton ne remplace pas les règles par robot comme GPTBot, donc les groupes existants restent pertinents. Ceci n'est pas un conseil juridique.
Le signal bloque-t-il l'exploration ?
Non. La section 4.4 du brouillon dit qu'il n'est pas une directive pour le comportement d'exploration. Pour limiter l'exploration, utilisez les groupes par robot.
Est-ce une norme ?
Pas encore. C'est un Internet-Draft individuel, non approuvé par l'IETF, sans statut formel, qui expire le 3 mai 2027.
Méthode et limites
Cet article s'appuie sur le brouillon de l'IETF, le blog Bing, SiliconANGLE et la documentation des robots d'OpenAI, consultés le 31 octobre 2026. La page d'annonce d'OpenAI citée par la presse a renvoyé une erreur 403 et n'a pas été lue : ce que nous rapportons des plans d'OpenAI vient de SiliconANGLE et de la documentation existante. Le « l'an prochain » de Google et le « dans les prochains mois » d'OpenAI viennent aussi de la presse, pas d'une page d'entreprise que nous avons lue. Ceci n'est pas un conseil juridique.
Sources
- IETF : Machine-Readable Training Preference Signal (brouillon) (vérifié le 2026-10-31)
- Microsoft, blog Bing : des préférences plus claires pour l'entraînement et l'ancrage (vérifié le 2026-10-31)
- SiliconANGLE : Google, Anthropic et d'autres soutiennent une nouvelle norme de refus d'exploration par les IA, 30 octobre 2026 (vérifié le 2026-10-31)
- OpenAI : documentation des robots (vérifié le 2026-10-31)
- IETF : groupe de travail AI Preferences, brouillon de vocabulaire (vérifié le 2026-10-31)
Une erreur dans cet article ? Signalez-la · Notre politique de corrections
