Análise
Um só sinal no robots.txt para recusar o treinamento de IA: o que OpenAI, Google, Microsoft e Anthropic apoiam
Um rascunho propõe o token de robots.txt __usage_ai-training para recusar o treinamento de IA. O que cobre, o que não cobre e quando a Microsoft começa.
Em 31 de outubro de 2026, a proposta é um grupo de robots.txt chamado __usage_ai-training, descrito em um rascunho da IETF datado de 30 de outubro. Segundo a SiliconANGLE, Google, Microsoft, Anthropic e OpenAI apoiam, com base nele, um padrão futuro. Ainda não é um padrão: o rascunho é individual e não é endossado pela IETF, e o sinal é uma preferência que os operadores de robôs seguem de forma voluntária.
O essencial
- O que é: um grupo comum de robots.txt cujo nome é
__usage_ai-training. Nenhuma diretiva nova é adicionada. - O que cobre: o uso de conteúdo para treinamento de IA. Não controla a exploração, a busca nem o grounding (ancoragem).
- Em que pé está: um rascunho individual. A Microsoft confirma suas próprias datas (1º de fevereiro de 2027). O Google, segundo a imprensa, seguirá em 2027 e a OpenAI nos próximos meses. A Meta não se comprometeu.
- Limites: expressa uma preferência. O cumprimento é voluntário e nada garante a exclusão do treinamento.
O que exatamente essas empresas apoiam?
O texto é o "Machine-Readable Training Preference Signal" (draft-kelley-aipref-training-preference-signal-00), de Kevin Kelley, da Anthropic. Ele é datado de 30 de outubro de 2026 e expira em 3 de maio de 2027. É um "Individual Internet-Draft" com o status visado de Standards Track, e o rascunho afirma que não é endossado pela IETF (IETF Datatracker).
Segundo a SiliconANGLE (30 de outubro de 2026), Google, Microsoft, Anthropic e OpenAI apoiam um padrão futuro. Uma única entrada de robots.txt bloquearia todos os robôs que coletam dados de treinamento para modelos generativos. Ela não se aplicaria a modelos que fazem "exclusivamente tarefas não generativas". A Meta manifestou apoio à ideia, mas não se comprometeu (SiliconANGLE).
Apenas o calendário da Microsoft é confirmado por uma fonte primária que lemos.
Como escrevê-lo no robots.txt?
O exemplo do próprio rascunho:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Disallow expressa uma preferência contra o uso do conteúdo para treinamento, e Allow, uma preferência a favor. As regras são as da RFC 9309, e a correspondência mais longa prevalece. A seção 4.2 do rascunho diz que um grupo genérico User-Agent: * não vale para este token, então o grupo precisa ser escrito de forma explícita.
O sentido segue a definição de "AI Training" do grupo de trabalho AI Preferences da IETF (IETF AI Preferences).
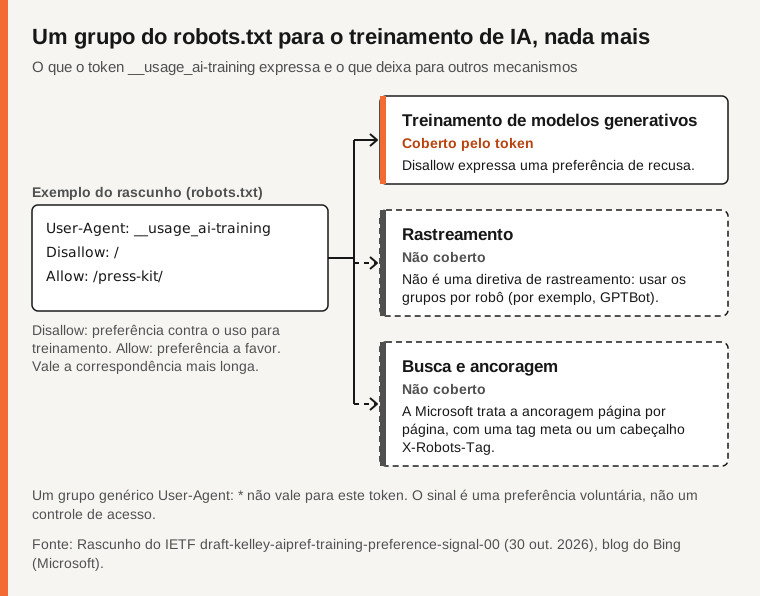
Fonte: rascunho da IETF (30 de outubro de 2026), blog do Bing, verificado em 31-10-2026.
O que ele cobre e o que não cobre?
É preciso separar três coisas: treinamento (modificar os parâmetros aprendidos de um modelo generativo), busca (indexação e classificação) e grounding (usar uma página para responder a uma pergunta).
O rascunho afirma que o token "não é uma diretiva de comportamento de exploração" ("not a directive for crawling behavior"). Para limitar a exploração, ele remete a grupos por robô, como GPTBot. Acordos privados podem prevalecer (seção 4.5).
A Microsoft traça a mesma linha no blog do Bing. Ela distingue "AI Training" de "AI Grounding", e a indexação e a classificação da busca clássica não são grounding. O treinamento usa o token __usage_ai-training, com Allow como padrão e Disallow como recusa. O grounding não tem configuração no robots.txt: é definido página por página com uma tag meta (name="Bingbot") ou um cabeçalho X-Robots-Tag, com valores como ai-grounding:disallow ou ai-grounding:disallowextended. As duas configurações são independentes, e uma configuração de página prevalece sobre o robots.txt (blog do Bing).
A Microsoft acrescenta que essas preferências não alteram a elegibilidade para os resultados clássicos do Bing, e que um robots.txt que bloqueia o Bingbot continua bloqueando a exploração: a configuração rege o uso, não o acesso. Recusar o grounding pode reduzir a visibilidade da marca em experiências de IA. Não garante inclusão, tráfego nem pagamento e não cria licença.
Para a OpenAI, a imprensa diz que o token não substitui os controles existentes. A documentação já existente da OpenAI diz que recusar o GPTBot indica que o conteúdo não deve treinar seus modelos de fundação generativos, que o OAI-SearchBot trata a busca separadamente e que o ChatGPT-User, que age a pedido de um usuário, pode não seguir o robots.txt (OpenAI).
O sinal não tem força jurídica por si só, o que depende da lei de cada país. Ele não apaga conteúdos já utilizados.
Quando ele passa a valer?
Do lado da Microsoft, segundo o blog: em 15 de dezembro de 2026 chegam configurações temporárias de grounding no Bing Webmaster Tools, somente para sites que usam NoArchive ou NoCache nessa data. As novas preferências de treinamento e de grounding começam a ser aplicadas ao longo das explorações em 1º de fevereiro de 2027. Em 1º de março de 2027, NoArchive e NoCache deixam de ser lidos como preferências de treinamento ou de grounding. As configurações temporárias de grounding terminam em 30 de setembro de 2027.
Para os demais, só a imprensa fala. Segundo a SiliconANGLE, o Google seguirá "no ano que vem" (2027) e a OpenAI prevê controles semelhantes "nos próximos meses". Não encontramos nenhuma declaração de implementação da Anthropic nas fontes que lemos, por isso não afirmamos nenhuma.
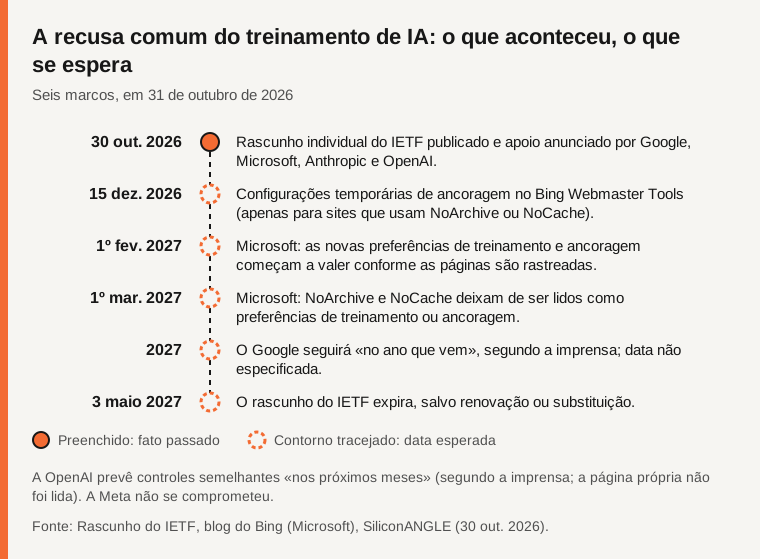
Fonte: rascunho da IETF, blog do Bing, SiliconANGLE, verificado em 31-10-2026. Os fatos passados aparecem preenchidos; as datas esperadas, apenas com contorno.
Tabela comparativa
| Empresa | Posição em 31 de out. de 2026 | Calendário | Fonte |
|---|---|---|---|
| Microsoft | Documenta o token __usage_ai-training e configurações de grounding separadas | 1º de fev. de 2027: as preferências começam a ser aplicadas | Blog do Bing |
| Apoia o padrão futuro, segundo a imprensa | "No ano que vem" (2027), segundo a imprensa | SiliconANGLE | |
| OpenAI | Apoia; prevê controles semelhantes, que não substituem os existentes, segundo a imprensa | "Nos próximos meses", segundo a imprensa | SiliconANGLE |
| Anthropic | Apoia, segundo a imprensa; seu funcionário é o autor do rascunho | Nenhuma declaração de implementação encontrada | SiliconANGLE, rascunho da IETF |
| Meta | Manifestou apoio à ideia, sem compromisso | Nenhum | SiliconANGLE |
Perguntas frequentes
Preciso mudar meu robots.txt agora?
Nada nas fontes que lemos promete cumprimento imediato. O token não substitui as regras por robô, como GPTBot, então os grupos existentes continuam relevantes. Isto não é aconselhamento jurídico.
O sinal bloqueia a exploração?
Não. A seção 4.4 do rascunho diz que ele não é uma diretiva de comportamento de exploração. Para limitar a exploração, use grupos por robô.
Isso é um padrão?
Ainda não. É um Internet-Draft individual, não endossado pela IETF, sem status formal, que expira em 3 de maio de 2027.
Método e limites
Este artigo se baseia no rascunho da IETF, no blog do Bing, na SiliconANGLE e na documentação de robôs da OpenAI, lidos em 31 de outubro de 2026. A página de anúncio da OpenAI citada pela imprensa retornou um erro 403 e não foi lida: o que relatamos sobre os planos da OpenAI vem da SiliconANGLE e da documentação existente. O "no ano que vem" do Google e o "nos próximos meses" da OpenAI também vêm da imprensa, não de uma página de empresa que lemos. Isto não é aconselhamento jurídico.
Fontes
- IETF: Machine-Readable Training Preference Signal (rascunho) (verificado em 31-10-2026)
- Microsoft, blog do Bing: preferências mais claras para treinamento e grounding (verificado em 31-10-2026)
- SiliconANGLE: Google, Anthropic e outros apoiarão um novo padrão de recusa de exploração por IA, 30 de outubro de 2026 (verificado em 31-10-2026)
- OpenAI: documentação de robôs (verificado em 31-10-2026)
- IETF: grupo de trabalho AI Preferences, rascunho de vocabulário (verificado em 31-10-2026)
Encontrou um erro neste artigo? Avise-nos · Nossa política de correções
