Analyse
Ein robots.txt-Signal gegen KI-Training: was OpenAI, Google, Microsoft und Anthropic unterstützen
Ein Entwurf schlägt ein robots.txt-Token vor, __usage_ai-training, um KI-Training abzulehnen. Was es abdeckt, was nicht und wann Microsoft startet.
Stand 31. Oktober 2026 ist der Vorschlag eine robots.txt-Gruppe namens __usage_ai-training, beschrieben in einem IETF-Entwurf vom 30. Oktober. Laut SiliconANGLE unterstützen Google, Microsoft, Anthropic und OpenAI auf dieser Grundlage einen kommenden Standard. Es ist noch kein Standard: Der Entwurf ist ein Einzelentwurf und nicht von der IETF gebilligt, und das Signal ist eine Präferenz, der Crawler-Betreiber freiwillig folgen.
Das Wesentliche
- Was es ist: eine gewöhnliche robots.txt-Gruppe mit dem Namen
__usage_ai-training. Es kommt keine neue Direktive hinzu. - Was es abdeckt: die Nutzung von Inhalten für das KI-Training. Es steuert weder das Crawling noch die Suche noch das Grounding.
- Wo es steht: ein Einzelentwurf. Microsoft bestätigt seine eigenen Termine (1. Februar 2027). Laut Presse folgt Google 2027 und OpenAI in den kommenden Monaten. Meta hat sich nicht festgelegt.
- Grenzen: Es drückt eine Präferenz aus. Die Beachtung ist freiwillig, und nichts garantiert den Ausschluss vom Training.
Was genau unterstützen diese Unternehmen?
Der Text heißt „Machine-Readable Training Preference Signal“ (draft-kelley-aipref-training-preference-signal-00) und stammt von Kevin Kelley von Anthropic. Er ist auf den 30. Oktober 2026 datiert und läuft am 3. Mai 2027 ab. Es ist ein „Individual Internet-Draft“ mit dem Ziel Standards Track, und der Entwurf stellt klar, dass er von der IETF nicht gebilligt ist (IETF Datatracker).
Laut SiliconANGLE (30. Oktober 2026) unterstützen Google, Microsoft, Anthropic und OpenAI einen kommenden Standard. Ein einziger robots.txt-Eintrag würde alle Crawler blockieren, die Trainingsdaten für generative Modelle sammeln. Er würde nicht für Modelle gelten, die „ausschließlich nicht generative Aufgaben“ erledigen. Meta äußerte Unterstützung für die Idee, hat sich aber nicht festgelegt (SiliconANGLE).
Nur der Zeitplan von Microsoft ist durch eine von uns gelesene Primärquelle bestätigt.
Wie schreibt man es in die robots.txt?
Das Beispiel des Entwurfs selbst:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Disallow drückt eine Präferenz gegen die Nutzung des Inhalts für das Training aus, Allow eine Präferenz dafür. Es gelten die Regeln der RFC 9309, und die längste Übereinstimmung gewinnt. Abschnitt 4.2 des Entwurfs stellt klar, dass eine allgemeine Gruppe User-Agent: * für dieses Token nicht gilt, die Gruppe muss also ausdrücklich geschrieben werden.
Die Bedeutung folgt der Definition von „AI Training“ der IETF-Arbeitsgruppe für KI-Präferenzen (IETF AI Preferences).
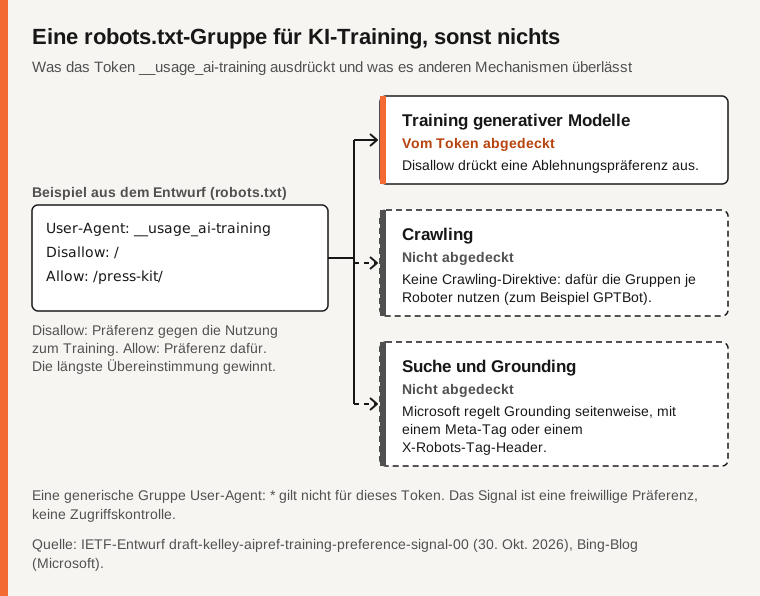
Quelle: IETF-Entwurf (30. Oktober 2026), Bing-Blog, geprüft am 31.10.2026.
Was deckt es ab, und was nicht?
Drei Dinge sind auseinanderzuhalten: Training (die gelernten Parameter eines generativen Modells ändern), Suche (Indexierung und Ranking) und Grounding (eine Seite nutzen, um eine Frage zu beantworten).
Der Entwurf stellt klar, dass das Token „keine Direktive für das Crawling-Verhalten“ ist. Um das Crawling zu begrenzen, verweist er auf Gruppen je Crawler wie GPTBot. Private Vereinbarungen können Vorrang haben (Abschnitt 4.5).
Microsoft zieht im Bing-Blog dieselbe Linie. Es unterscheidet „AI Training“ von „AI Grounding“, und die Indexierung und das Ranking der klassischen Suche sind kein Grounding. Das Training nutzt das Token __usage_ai-training, mit Allow als Standard und Disallow als Ablehnung. Für das Grounding gibt es keine robots.txt-Einstellung: Es wird Seite für Seite mit einem Meta-Tag (name="Bingbot") oder einem X-Robots-Tag-Header gesetzt, mit Werten wie ai-grounding:disallow oder ai-grounding:disallowextended. Die beiden Einstellungen sind unabhängig, und eine Einstellung auf Seitenebene hat Vorrang vor der robots.txt (Bing-Blog).
Microsoft fügt hinzu, dass diese Präferenzen die Eignung für klassische Bing-Ergebnisse nicht ändern und dass eine robots.txt, die Bingbot blockiert, das Crawling weiterhin blockiert: Die Einstellung regelt die Nutzung, nicht den Zugriff. Das Ablehnen des Groundings kann die Sichtbarkeit der Marke in KI-Erlebnissen verringern. Es garantiert weder Aufnahme noch Traffic noch Bezahlung und schafft keine Lizenz.
Zu OpenAI: Laut Presse ersetzt das Token die bestehenden Kontrollen nicht. Die vorhandene Dokumentation von OpenAI besagt, dass das Ablehnen von GPTBot signalisiert, dass Inhalte nicht zum Training der generativen Foundation-Modelle dienen sollen, dass OAI-SearchBot die Suche getrennt behandelt und dass ChatGPT-User, der auf Anfrage eines Nutzers handelt, robots.txt möglicherweise nicht befolgt (OpenAI).
Das Signal hat von sich aus keine rechtliche Wirkung, diese hängt vom Recht des jeweiligen Landes ab. Es löscht keine bereits verwendeten Inhalte.
Wann wird es wirksam?
Auf Seiten von Microsoft, laut dessen Blog: Vorübergehende Grounding-Einstellungen kommen am 15. Dezember 2026 in die Bing Webmaster Tools, nur für Websites, die an diesem Tag NoArchive oder NoCache verwenden. Die neuen Trainings- und Grounding-Präferenzen gelten ab dem 1. Februar 2027 im Zuge der Crawls. Am 1. März 2027 werden NoArchive und NoCache nicht mehr als Trainings- oder Grounding-Präferenzen gelesen. Die vorübergehenden Grounding-Einstellungen enden am 30. September 2027.
Zu den anderen spricht nur die Presse. Laut SiliconANGLE folgt Google „im nächsten Jahr“ (2027), und OpenAI plant ähnliche Kontrollen „in den kommenden Monaten“. In den von uns gelesenen Quellen fanden wir keine Umsetzungserklärung von Anthropic, daher behaupten wir keine.
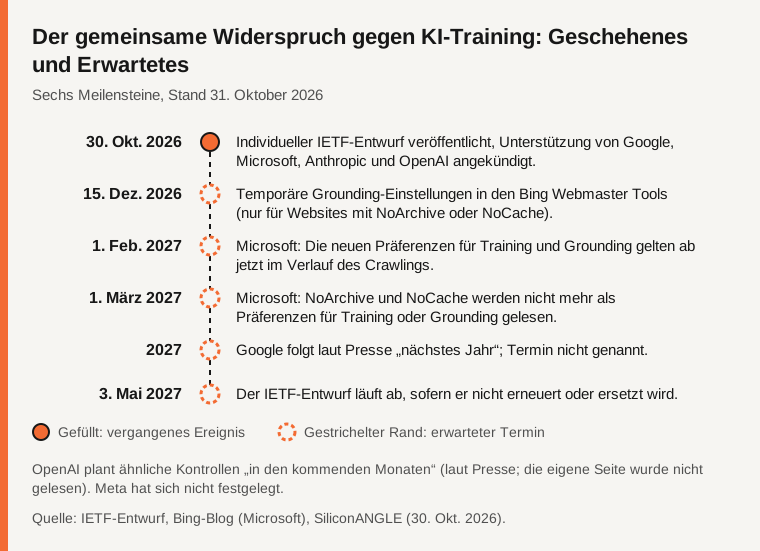
Quelle: IETF-Entwurf, Bing-Blog, SiliconANGLE, geprüft am 31.10.2026. Vergangene Fakten sind gefüllt dargestellt, erwartete Termine als Umriss.
Vergleichstabelle
| Unternehmen | Position am 31. Oktober 2026 | Zeitplan | Quelle |
|---|---|---|---|
| Microsoft | Dokumentiert das Token __usage_ai-training und getrennte Grounding-Einstellungen | 1. Febr. 2027: Präferenzen beginnen zu gelten | Bing-Blog |
| Unterstützt den kommenden Standard, laut Presse | „Im nächsten Jahr“ (2027), laut Presse | SiliconANGLE | |
| OpenAI | Unterstützt ihn; plant ähnliche Kontrollen, die bestehende nicht ersetzen, laut Presse | „In den kommenden Monaten“, laut Presse | SiliconANGLE |
| Anthropic | Unterstützt ihn, laut Presse; ein Mitarbeiter ist der Autor des Entwurfs | Keine Umsetzungserklärung gefunden | SiliconANGLE, IETF-Entwurf |
| Meta | Äußerte Unterstützung für die Idee, keine Festlegung | Keiner | SiliconANGLE |
Häufig gestellte Fragen
Muss ich meine robots.txt jetzt ändern?
In den von uns gelesenen Quellen wird keine sofortige Beachtung versprochen. Das Token ersetzt die Regeln je Crawler wie GPTBot nicht, bestehende Gruppen bleiben also relevant. Das ist keine Rechtsberatung.
Blockiert das Signal das Crawling?
Nein. Abschnitt 4.4 des Entwurfs stellt klar, dass es keine Direktive für das Crawling-Verhalten ist. Um das Crawling zu begrenzen, nutzen Sie Gruppen je Crawler.
Ist es ein Standard?
Noch nicht. Es ist ein Individual Internet-Draft, nicht von der IETF gebilligt, ohne formalen Status, der am 3. Mai 2027 abläuft.
Methode und Grenzen
Dieser Artikel stützt sich auf den IETF-Entwurf, den Bing-Blog, SiliconANGLE und die Bot-Dokumentation von OpenAI, gelesen am 31. Oktober 2026. Die von der Presse genannte Ankündigungsseite von OpenAI lieferte einen 403-Fehler und wurde nicht gelesen: Was wir zu den Plänen von OpenAI berichten, stammt von SiliconANGLE und aus der bestehenden Dokumentation. Auch das „im nächsten Jahr“ von Google und das „in den kommenden Monaten“ von OpenAI stammen aus der Presse, nicht von einer Unternehmensseite, die wir gelesen haben. Das ist keine Rechtsberatung.
Quellen
- IETF: Machine-Readable Training Preference Signal (Entwurf) (geprüft am 31.10.2026)
- Microsoft, Bing-Blog: klarere Präferenzen für Training und Grounding (geprüft am 31.10.2026)
- SiliconANGLE: Google, Anthropic und andere unterstützen einen neuen Opt-out-Standard gegen KI-Crawling, 30. Oktober 2026 (geprüft am 31.10.2026)
- OpenAI: Bot-Dokumentation (geprüft am 31.10.2026)
- IETF: Arbeitsgruppe AI Preferences, Vokabular-Entwurf (geprüft am 31.10.2026)
Einen Fehler in diesem Artikel entdeckt? Melden Sie ihn · Unsere Korrekturrichtlinie
