Analisi
Un solo segnale robots.txt per rifiutare l'addestramento delle IA: cosa sostengono OpenAI, Google, Microsoft e Anthropic
Una bozza propone un solo token robots.txt, __usage_ai-training, per rifiutare l'addestramento IA. Cosa copre, cosa no e quando parte Microsoft.
Al 31 ottobre 2026, la proposta è un gruppo robots.txt chiamato __usage_ai-training, descritto in una bozza IETF datata 30 ottobre. Secondo SiliconANGLE, Google, Microsoft, Anthropic e OpenAI sostengono su questa base uno standard in arrivo. Non è ancora uno standard: la bozza è individuale e non approvata dall'IETF, e il segnale è una preferenza che gli operatori dei crawler seguono volontariamente.
L'essenziale
- Che cos'è: un normale gruppo robots.txt il cui nome è
__usage_ai-training. Non viene aggiunta alcuna nuova direttiva. - Che cosa copre: l'uso dei contenuti per l'addestramento delle IA. Non controlla né la scansione, né la ricerca, né il grounding.
- A che punto siamo: una bozza individuale. Microsoft conferma le proprie date (1° febbraio 2027). Secondo la stampa, Google seguirà nel 2027 e OpenAI nei prossimi mesi. Meta non si è impegnata.
- Limiti: esprime una preferenza. Il rispetto è volontario e nulla garantisce l'esclusione dall'addestramento.
Che cosa sostengono esattamente queste aziende?
Il testo è «Machine-Readable Training Preference Signal» (draft-kelley-aipref-training-preference-signal-00), di Kevin Kelley di Anthropic. È datato 30 ottobre 2026 e scade il 3 maggio 2027. È un «Individual Internet-Draft» destinato allo Standards Track, e la bozza precisa di non essere approvata dall'IETF (IETF Datatracker).
Secondo SiliconANGLE (30 ottobre 2026), Google, Microsoft, Anthropic e OpenAI sostengono uno standard in arrivo. Una sola voce robots.txt bloccherebbe tutti i crawler che raccolgono dati di addestramento per modelli generativi. Non si applicherebbe ai modelli che svolgono «esclusivamente compiti non generativi». Meta ha espresso sostegno all'idea ma non si è impegnata (SiliconANGLE).
Solo il calendario di Microsoft è confermato da una fonte primaria che abbiamo letto.
Come si scrive in robots.txt?
L'esempio della bozza stessa:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Disallow esprime una preferenza contraria all'uso del contenuto per l'addestramento, e Allow una preferenza favorevole. Le regole sono quelle della RFC 9309, e vince la corrispondenza più lunga. La sezione 4.2 della bozza precisa che un gruppo generico User-Agent: * non si applica a questo token: il gruppo va quindi scritto esplicitamente.
Il significato segue la definizione di «AI Training» del gruppo di lavoro IETF sulle preferenze IA (IETF AI Preferences).
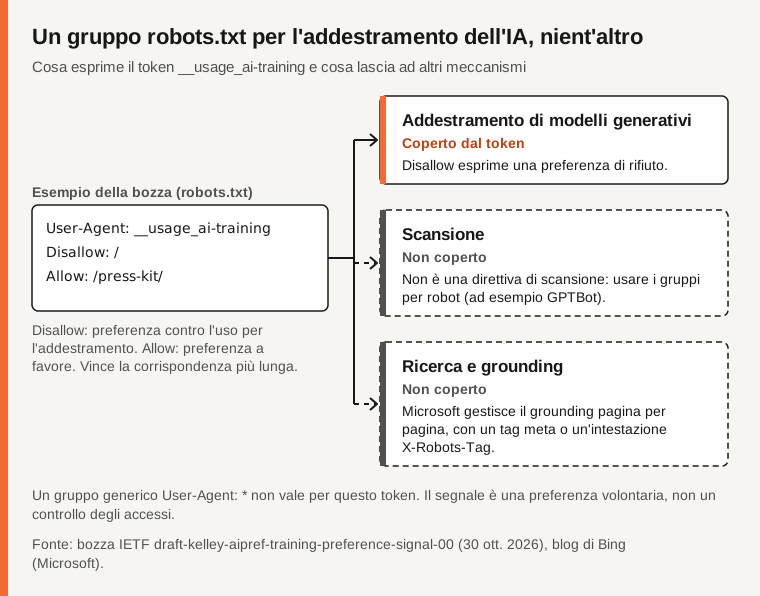
Fonte: bozza IETF (30 ottobre 2026), blog Bing, verificato il 2026-10-31.
Che cosa copre, e che cosa no?
Occorre tenere distinte tre cose: addestramento (modificare i parametri appresi di un modello generativo), ricerca (indicizzazione e classifica) e grounding (usare una pagina per rispondere a una domanda).
La bozza precisa che il token «non è una direttiva sul comportamento di scansione». Per limitare la scansione rimanda ai gruppi per singolo crawler, come GPTBot. Accordi privati possono prevalere (sezione 4.5).
Microsoft traccia la stessa linea sul blog di Bing. Distingue «AI Training» da «AI Grounding», e l'indicizzazione e la classifica della ricerca classica non sono grounding. L'addestramento usa il token __usage_ai-training, con Allow come impostazione predefinita e Disallow come rifiuto. Il grounding non ha alcuna impostazione robots.txt: si regola pagina per pagina con un tag meta (name="Bingbot") o un'intestazione X-Robots-Tag, con valori come ai-grounding:disallow o ai-grounding:disallowextended. Le due impostazioni sono indipendenti, e un'impostazione a livello di pagina prevale su robots.txt (blog Bing).
Microsoft aggiunge che queste preferenze non cambiano l'idoneità ai risultati Bing classici, e che un robots.txt che blocca Bingbot continua a bloccare la scansione: l'impostazione governa l'uso, non l'accesso. Rifiutare il grounding può ridurre la visibilità del marchio nelle esperienze IA. Non garantisce alcuna inclusione, traffico o pagamento e non crea alcuna licenza.
Per OpenAI, secondo la stampa il token non sostituisce i controlli esistenti. La documentazione già esistente di OpenAI indica che rifiutare GPTBot segnala che il contenuto non deve addestrare i suoi modelli di fondazione generativi, che OAI-SearchBot gestisce la ricerca separatamente e che ChatGPT-User, che agisce su richiesta di un utente, può non seguire robots.txt (OpenAI).
Il segnale non ha forza giuridica di per sé, che dipende dal diritto di ciascun paese. Non cancella i contenuti già utilizzati.
Quando sarà effettivo?
Dal lato di Microsoft, secondo il suo blog: le impostazioni temporanee di grounding arrivano in Bing Webmaster Tools il 15 dicembre 2026, solo per i siti che a quella data usano NoArchive o NoCache. Le nuove preferenze di addestramento e di grounding iniziano ad applicarsi con il procedere delle scansioni il 1° febbraio 2027. Il 1° marzo 2027, NoArchive e NoCache non sono più letti come preferenze di addestramento o di grounding. Le impostazioni temporanee di grounding terminano il 30 settembre 2027.
Per gli altri parla solo la stampa. Secondo SiliconANGLE, Google seguirà «l'anno prossimo» (2027) e OpenAI prevede controlli simili «nei prossimi mesi». Nelle fonti che abbiamo letto non abbiamo trovato alcuna dichiarazione di attuazione da parte di Anthropic, quindi non ne affermiamo nessuna.
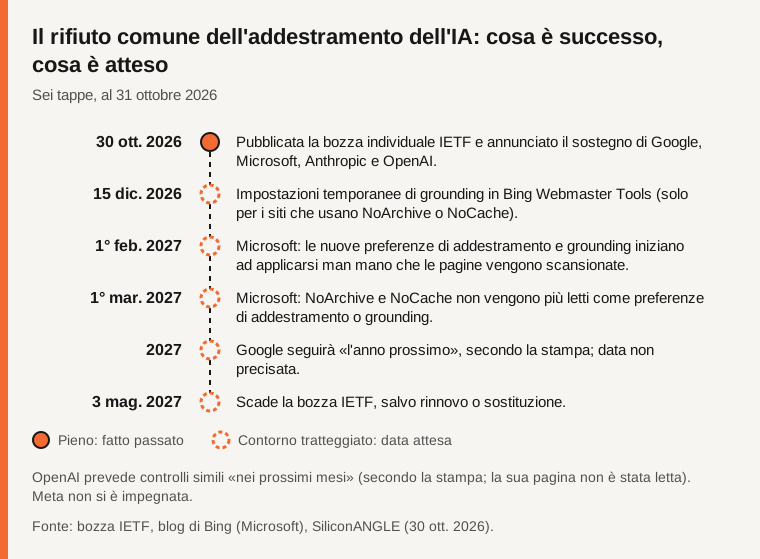
Fonte: bozza IETF, blog Bing, SiliconANGLE, verificato il 2026-10-31. I fatti passati sono pieni, le date attese solo a contorno.
Tabella di confronto
| Azienda | Posizione al 31 ott. 2026 | Calendario | Fonte |
|---|---|---|---|
| Microsoft | Documenta il token __usage_ai-training e impostazioni di grounding separate | 1° feb. 2027: le preferenze iniziano ad applicarsi | Blog Bing |
| Sostiene lo standard in arrivo, secondo la stampa | «L'anno prossimo» (2027), secondo la stampa | SiliconANGLE | |
| OpenAI | Lo sostiene; prevede controlli simili, che non sostituiscono quelli esistenti, secondo la stampa | «Nei prossimi mesi», secondo la stampa | SiliconANGLE |
| Anthropic | Lo sostiene, secondo la stampa; un suo dipendente è l'autore della bozza | Nessuna dichiarazione di attuazione trovata | SiliconANGLE, bozza IETF |
| Meta | Ha espresso sostegno all'idea, nessun impegno | Nessuno | SiliconANGLE |
Domande frequenti
Devo modificare subito il mio robots.txt?
Nulla nelle fonti che abbiamo letto promette un rispetto immediato. Il token non sostituisce le regole per singolo crawler come GPTBot, quindi i gruppi esistenti restano rilevanti. Questa non è una consulenza legale.
Il segnale blocca la scansione?
No. La sezione 4.4 della bozza precisa che non è una direttiva sul comportamento di scansione. Per limitare la scansione, usare i gruppi per singolo crawler.
È uno standard?
Non ancora. È un Internet-Draft individuale, non approvato dall'IETF, senza stato formale, che scade il 3 maggio 2027.
Metodo e limiti
Questo articolo si basa sulla bozza IETF, sul blog di Bing, su SiliconANGLE e sulla documentazione dei bot di OpenAI, letti il 31 ottobre 2026. La pagina dell'annuncio di OpenAI citata dalla stampa ha restituito un errore 403 e non è stata letta: quanto riportiamo sui piani di OpenAI proviene da SiliconANGLE e dalla documentazione esistente. Anche il «l'anno prossimo» di Google e il «nei prossimi mesi» di OpenAI provengono dalla stampa, non da una pagina aziendale che abbiamo letto. Questa non è una consulenza legale.
Fonti
- IETF: Machine-Readable Training Preference Signal (bozza) (verificato il 2026-10-31)
- Microsoft, blog Bing: preferenze più chiare per addestramento e grounding (verificato il 2026-10-31)
- SiliconANGLE: Google, Anthropic e altri sosterranno un nuovo standard di opt-out dalla scansione IA, 30 ottobre 2026 (verificato il 2026-10-31)
- OpenAI: documentazione dei bot (verificato il 2026-10-31)
- IETF: gruppo di lavoro AI Preferences, bozza sul vocabolario (verificato il 2026-10-31)
Avete notato un errore in questo articolo? Segnalatelo · La nostra politica sulle correzioni
