Analyse
OpenAI ouvre GPT-Rosalind-6, son modèle de biologie, aux seuls clients agréés
GPT-Rosalind-6 reprend les poids de GPT-6 Astra, refuse moins en biologie à double usage et n'est ouvert qu'aux clients agréés.
Au 1er novembre 2026, OpenAI a publié l'addendum à la carte système de GPT-Rosalind-6, un modèle de raisonnement pour la biologie, la découverte de médicaments et la médecine translationnelle, proposé sous le nom « GPT-Rosalind-6 Research » à des clients agréés uniquement. Selon OpenAI, il utilise les mêmes poids que GPT-6 Astra : ce qui change, c'est la frontière de refus sur la biologie à double usage et la porte d'accès. Nous n'avons pas testé le modèle.
L'essentiel
- Ce que c'est : les mêmes poids que GPT-6 Astra, sans données d'entraînement ni post-entraînement ajoutés, selon OpenAI. Il refuse moins en biologie à double usage.
- Qui y accède : des clients agréés (scientifiques qualifiés, instituts, entreprises, partenaires gouvernementaux), pas le grand public.
- Ce qu'OpenAI mesure : des gains internes par rapport à GPT-Rosalind-5.5 sur trois benchmarks de sciences de la vie.
- Ce qui reste ouvert : les tests indépendants, un prix officiel et le nombre d'organisations agréées.
Qu'annonce OpenAI exactement ?
Le 30 octobre 2026, OpenAI a publié un addendum à la carte système sur son Deployment Safety Hub. Il décrit GPT-Rosalind-6 comme un modèle de raisonnement de pointe pour la biologie, la découverte de médicaments et la médecine translationnelle.
L'affirmation centrale : OpenAI n'a ajouté ni données d'entraînement ni post-entraînement pour cette version. Autrement dit, les poids sont ceux de GPT-6 Astra, le modèle de raisonnement phare d'OpenAI.
Le modèle n'est pas dans l'onglet de chat ordinaire. i-SCOOP rapporte un identifiant d'API, gpt-6-rosalind, et un accès par Codex, l'espace de travail de ChatGPT et l'API.
Qui peut y accéder, et à quelles conditions ?
L'accès se fait en « trusted access » uniquement. Les candidats doivent démontrer une mission légitime en sciences de la vie, un cas d'usage crédible, une gouvernance de recherche et opérationnelle, et la capacité de contrôler qui utilise le modèle. Les candidats non gouvernementaux passent par une vérification d'entreprise et un contrôle de conformité. Les gouvernements disposent d'une voie distincte pour des entités choisies en biosécurité, préparation de santé publique et biodéfense.
Les clients agréés doivent appliquer un accès au moindre privilège et des contrôles du risque interne, et faire relire les sorties par des personnes qualifiées avant qu'elles n'informent des expériences, des publications ou des décisions importantes. OpenAI peut restreindre ou révoquer l'accès. L'accès au modèle et la rétention des données sont approuvés séparément.
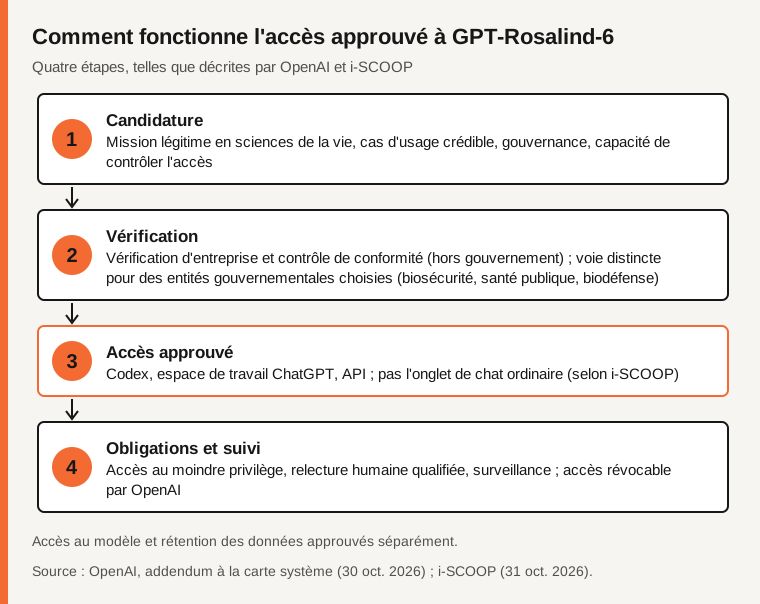
Source : OpenAI, addendum à la carte système (30 octobre 2026) ; i-SCOOP (31 octobre 2026).
Que disent les mesures d'OpenAI ?
Ce sont des mesures internes d'OpenAI, au budget de raisonnement maximal. Les scores de GPT-Rosalind-5.5 sont recalculés sur les mêmes versions des benchmarks : ils diffèrent donc de ses chiffres de lancement.
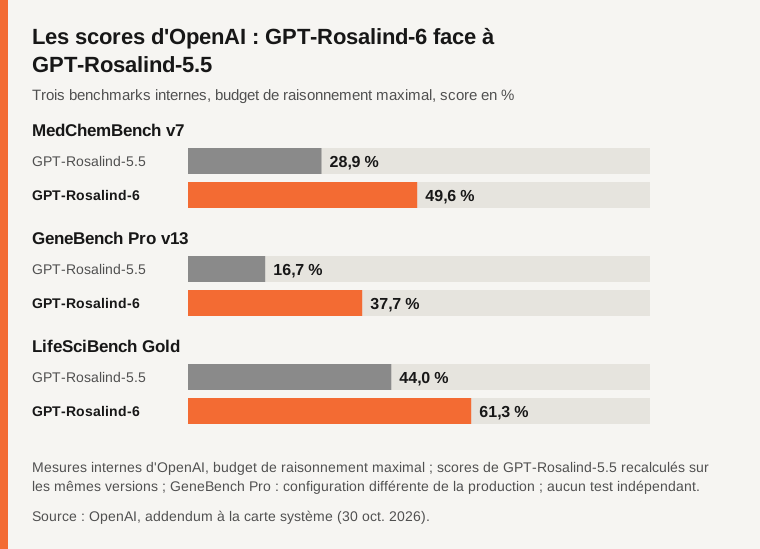
Source : OpenAI, addendum à la carte système (30 octobre 2026). Mesures internes ; GeneBench Pro utilise une configuration propre au benchmark, différente de la production.
Sur TroubleshootingBench, OpenAI annonce 59,0 % (491 sur 832) pour un seuil indicatif « High » de 36,4 %. Aucun de ses quatre tests de capacité « Critical » n'atteint le seuil indicatif. OpenAI précise que ces seuils sont des estimations préliminaires et que sa notation de biosécurité est encore mise à jour.
Qu'est-ce qui change par rapport à GPT-6 Astra ?
Pas les poids. OpenAI dit que le modèle est conçu pour refuser moins que ses modèles ChatGPT généraux en biologie à double usage, tout en refusant ou en répondant avec prudence quand une demande aiderait sensiblement à fabriquer une arme biologique. Sur son test de connaissances « biorisk », le taux de refus est de 9,4 %, contre 29,2 % pour GPT-6 Astra et 1,8 % pour GPT-Rosalind-5.5.
Dans son cadre Preparedness, OpenAI classe le modèle « High » pour le risque biologique et chimique (sous « Critical »), « Critical » pour la cybersécurité (repris d'Astra) et sous « High » pour l'auto-amélioration de l'IA. Aux tests de jailbreak cyber, blocage en temps réel désactivé, le taux de succès est de 14,3 % (Astra : 15,7 % ; plus bas = mieux). OpenAI décrit ses comparaisons de sécurité comme descriptives.
Rien de tout cela ne montre que le modèle accélère la découverte réelle de médicaments : ce sont des benchmarks, pas des résultats de laboratoire.
Qu'est-ce qui n'est pas établi ?
Le nombre d'organisations agréées est inconnu. Nous n'avons trouvé aucun test indépendant du modèle. Sur le prix, une analyse tierce (FourWeekMBA, 31 octobre) lit une ligne gpt-6-rosalind à 15 $ en entrée et 75 $ en sortie par million de jetons, soit environ 1,5 fois GPT-6 Astra (10 $ et 50 $), mais i-SCOOP indique qu'aucun prix officiel n'était publié ce jour-là. Nous tenons ce chiffre pour non confirmé. Le red-teaming de biosécurité a été fait sur GPT-Rosalind-5.5 ; la répétition pour Rosalind-6 est en cours.
Tableau comparatif
| Point | Ce que disent les sources au 1er novembre 2026 | Source |
|---|---|---|
| Nature | Modèle de raisonnement pour la biologie, la découverte de médicaments, la médecine translationnelle | OpenAI |
| Accès | Trusted access uniquement ; clients agréés ; pas l'onglet de chat ordinaire | OpenAI, i-SCOOP |
| Poids | Identiques à GPT-6 Astra ; ni données d'entraînement ni post-entraînement ajoutés | OpenAI |
| Refus (test biorisk) | 9,4 % (5.5 : 1,8 % ; Astra : 29,2 %) | OpenAI |
| Mesures internes | MedChemBench 49,6 %, GeneBench Pro 37,7 %, LifeSciBench Gold 61,3 % | OpenAI |
| Prix | Non confirmé : 15 $ / 75 $ par million de jetons selon un tiers ; aucun prix officiel | FourWeekMBA, i-SCOOP |
Questions fréquentes
GPT-Rosalind-6 est-il accessible au grand public ?
Non. Seuls des clients agréés peuvent l'utiliser, après candidature et vérification. Il n'est pas dans l'onglet de chat ordinaire.
Est-ce un nouveau modèle entraîné pour la biologie ?
Selon OpenAI, aucun nouvel entraînement n'a eu lieu : elle n'a ajouté ni données d'entraînement ni post-entraînement. Les poids sont ceux de GPT-6 Astra, et les changements portent sur le comportement de refus et l'accès.
Les résultats sont-ils vérifiés de façon indépendante ?
Non. Les chiffres sont des mesures internes d'OpenAI. Nous n'avons trouvé aucun test indépendant.
Méthode et limites
Nous avons lu l'addendum à la carte système d'OpenAI le 1er novembre 2026, ainsi que trois articles secondaires (i-SCOOP, FourWeekMBA, AI Weekly). Nous n'avons pas testé le modèle et n'avons pas lu la page de prix d'OpenAI. Plusieurs tableaux de l'addendum (ProtocolQA, virologie, scores Critical de Rosalind-6) n'ont pas été lus. Ce n'est ni un conseil d'achat ni un conseil d'investissement.
Sources
- OpenAI : addendum à la carte système de GPT-Rosalind-6 (vérifié le 2026-11-01)
- i-SCOOP : GPT-6 Rosalind et l'accès de confiance (vérifié le 2026-11-01)
- FourWeekMBA : OpenAI facture Rosalind-6 à 1,5 fois Astra sur les mêmes poids, analyse tierce (vérifié le 2026-11-01)
- AI Weekly : OpenAI livre GPT-Rosalind-6 à des utilisateurs de confiance (vérifié le 2026-11-01)
Une erreur dans cet article ? Signalez-la · Notre politique de corrections
