Analyse
Anthropic publie FlashProve, un prototype de recherche open source qui prouve qu'une réponse vient d'un modèle engagé, avec pour limites le décodage glouton, 1 024 jetons et un modèle ouvert
Anthropic publie FlashProve, un prototype qui vérifie qu'une réponse vient d'un modèle engagé. Décodage glouton, 1 024 jetons, modèle ouvert, non maintenu.
- Nouvelles technologies IA
- #Anthropic
- #FlashProve
- #inférence prouvable
- #preuves à divulgation nulle
- #open source
- #sécurité de l'IA
Le 2 novembre 2026, la Frontier Red Team d'Anthropic a publié un billet et du code open source pour FlashProve, un prototype de recherche d'inférence prouvable : vérifier par cryptographie qu'une réponse vient d'un modèle engagé (committed), pas d'un modèle substitué. C'est de la recherche, pas un produit. Nous n'avons lu les sources que par résumés automatiques et n'avons rien exécuté. Ceci n'est ni un conseil juridique ni un conseil de sécurité.
L'essentiel
- Ce que c'est : selon Anthropic, un prototype à base de zkSNARK qui permet de vérifier qu'une réponse vient d'un modèle engagé, sans accès à ses poids. Code sous licence Apache 2.0 ; les poids ne sont pas inclus.
- Où il en est : le dépôt est marqué non maintenu ; TechCrunch rapporte qu'aucun déploiement n'est prévu.
- Les limites : décodage glouton, 1 024 jetons, un modèle ouvert (Llama 4 Maverick, pas Claude), et environ 70 à 95 fois le temps GPU d'un service vLLM.
- Non établi : comment une empreinte est reliée à l'identité annoncée d'un modèle commercial, et l'adoption.
Que publie Anthropic ?
Le billet d'Anthropic et le dépôt (anthropics/FlashProve, v0.16.0) couvrent le code, les preuves Lean et la documentation. TechCrunch rapporte qu'Anthropic décrit le billet comme un état d'avancement intermédiaire. Anthropic dit que l'objectif de sa feuille de route, un prototype d'inférence prouvable, a été atteint par un projet distinct, rebaptisé « inference verification » ; FlashProve est la voie purement cryptographique, sans matériel de confiance (via The Decoder et CellCog). Anthropic ajoute que Claude a amélioré le travail sur les zkSNARK et rédigé la spécification du protocole, Lean servant à énoncer des garanties que des humains peuvent auditer.
Comment ça marche, en trois temps
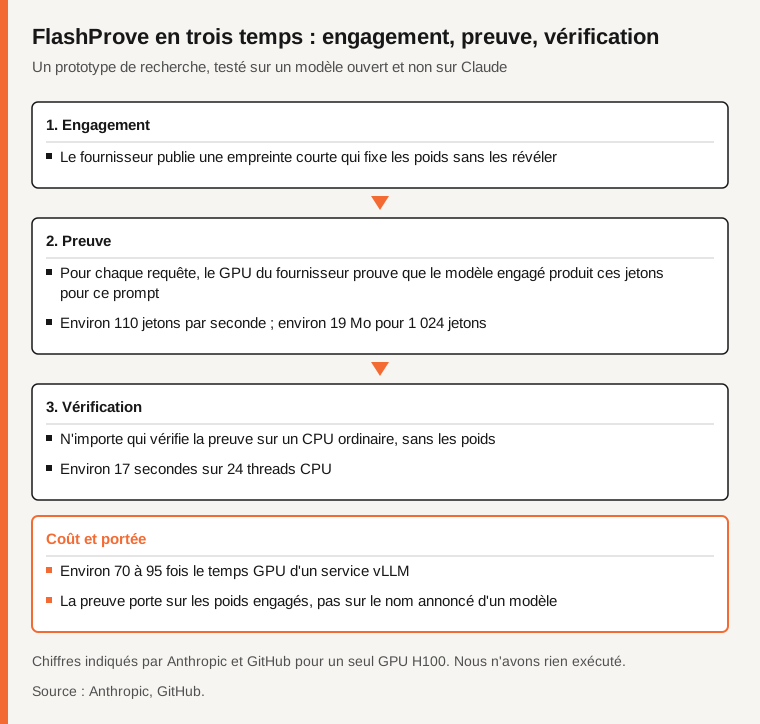
Selon Anthropic et GitHub :
- Engagement : le fournisseur publie une empreinte courte qui fixe un jeu de poids sans le révéler.
- Preuve : pour chaque requête, son GPU prouve que le modèle engagé produit ces jetons de sortie pour ce prompt.
- Vérification : n'importe qui vérifie la preuve sur un CPU ordinaire, sans les poids.
Sur un seul GPU H100, les sources donnent environ 110 jetons par seconde de génération de preuve, une preuve d'environ 19 Mo pour 1 024 jetons et environ 17 secondes de vérification sur 24 threads CPU. Le prouveur exige un H100 de 80 Go dédié et environ 330 Go de RAM (GitHub).
Source : Anthropic, GitHub.
Ce que la preuve établit, et ce qu'elle n'établit pas
CellCog rapporte qu'un fournisseur qui sert un autre modèle ne peut pas produire de preuve valide pour le modèle engagé ; GitHub indique que cette solidité est prouvée en Lean, avec une probabilité d'erreur bornée, pas nulle. Le modèle testé est Llama 4 Maverick de Meta, via une conversion en 4 bits d'un tiers : FlashProve prouve un modèle ouvert, pas Claude.
La preuve montre la cohérence avec une empreinte. Dans les pages lues, ni Anthropic ni GitHub ne détaillent comment une empreinte est reliée à l'identité publique d'un modèle commercial. GitHub ajoute que l'identifiant d'engagement doit venir d'une partie de confiance du vérifieur, pas du serveur.
Anthropic suggère que des régulateurs vérifient que les fournisseurs ne servent que des modèles approuvés. TechCrunch ajoute : empêcher un laboratoire de remplacer en secret un modèle moins coûteux.
Les limites annoncées
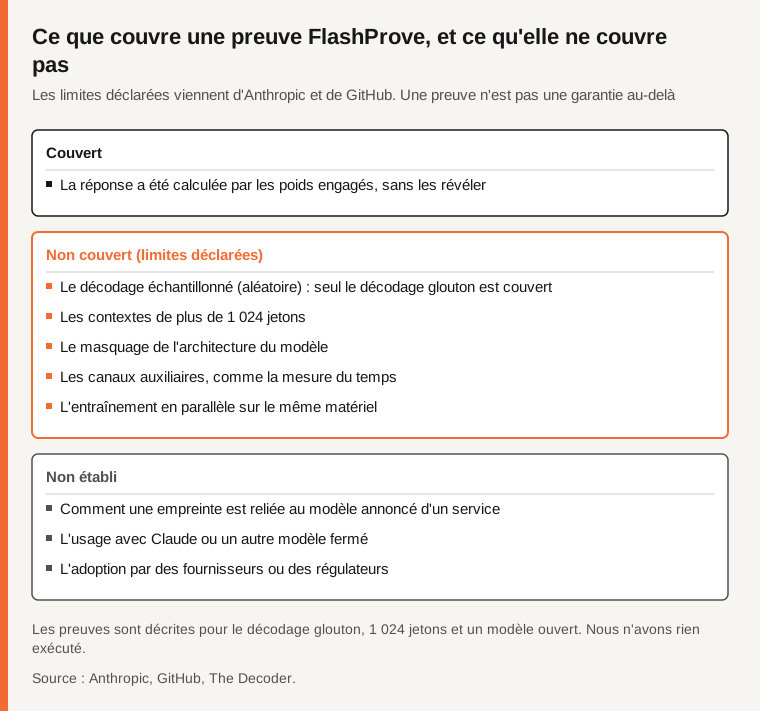
- Décodage glouton uniquement : l'échantillonnage aléatoire, typique des chatbots, n'est pas couvert (Anthropic, The Decoder).
- Poids en arithmétique entière : jugés proches de l'inférence en virgule flottante par des tests, sans couvrir des prompts d'attaque (Anthropic).
- 1 024 jetons, très en deçà des fenêtres actuelles ; l'extension est un travail futur (Anthropic).
- Pas entièrement caché : l'architecture est visible, et des valeurs de poids sont masquées sauf une liste déclarée (GitHub).
- Hors périmètre : canaux auxiliaires comme la mesure du temps, et entraînement en parallèle sur le même matériel (Anthropic).
- Vérification : le code rapide C++/GPU n'est pas vérifié formellement, et les énoncés Lean doivent être audités à la main (Anthropic).
Source : Anthropic, GitHub, The Decoder.
Qu'est-ce qui n'est pas établi ?
Comment une empreinte est reliée au modèle annoncé d'un service ; le décodage échantillonné et les longs contextes ; les modèles fermés comme Claude ; une vérification indépendante des performances ; l'adoption par des fournisseurs ou des régulateurs ; si le code fonctionne comme décrit.
Tableau comparatif
| Point | Ce que disent les sources | Statut |
|---|---|---|
| Modèle testé | Llama 4 Maverick, ouvert, 4 bits | Déclaré par Anthropic |
| Surcoût | Environ 70 à 95 fois le temps GPU d'un service vLLM | Déclaré par Anthropic |
| Système antérieur | VerInf : 14,3 heures, 93,6 Go pour 1 000 jetons | Rapporté par CellCog |
| Déploiement | Aucun prévu | Rapporté par TechCrunch |
| Empreinte vers modèle annoncé | Non détaillé | Non établi |
Questions fréquentes
FlashProve prouve-t-il que Claude est bien Claude ?
Non. Il a été testé sur un modèle ouvert. L'usage avec des modèles fermés comme Claude n'est pas établi.
Peut-on l'utiliser aujourd'hui ?
Le code est open source, mais non maintenu, le prouveur exige un H100 de 80 Go et aucun déploiement n'est prévu. Nous ne l'avons pas exécuté.
Pourquoi 1 024 jetons et décodage glouton ?
Anthropic donne les deux comme limites ; les contextes plus longs sont un travail futur. Les pages lues n'indiquent pas d'autre raison.
Méthode et limites
Nous avons lu le billet d'Anthropic et le dépôt GitHub par résumés automatiques le 4 novembre 2026, ainsi que TechCrunch, The Decoder et CellCog (seconde main). Nous n'avons pas lu le rapport technique d'Anthropic ni utilisé MarkTechPost ou RuntimeWire. Nous ne jugeons pas la cryptographie.
Sources
- Anthropic, Progress on provable inference for large language models, résumé automatique
- GitHub, anthropics/FlashProve, résumé automatique
- TechCrunch, Russell Brandom, résumé automatique
- The Decoder, résumé automatique
- CellCog, seconde main, résumé automatique
Une erreur dans cet article ? Signalez-la · Notre politique de corrections
