Analisi
Anthropic pubblica FlashProve, un prototipo di ricerca open source che dimostra che una risposta viene da un modello vincolato, con i limiti della decodifica greedy, di 1.024 token e di un modello aperto
Anthropic pubblica FlashProve, un prototipo che verifica che una risposta viene da un modello vincolato. Decodifica greedy, 1.024 token, modello aperto.
- Nuove tecnologie di IA
- #Anthropic
- #FlashProve
- #inferenza dimostrabile
- #prove a conoscenza zero
- #open source
- #sicurezza dell'IA
Il 2 novembre 2026 la Frontier Red Team di Anthropic ha pubblicato un post e codice open source per FlashProve, un prototipo di ricerca di inferenza dimostrabile: verificare in modo crittografico che una risposta viene da un modello vincolato (committed), non da un sostituto. È ricerca, non un prodotto. Abbiamo letto le fonti solo tramite riassunti automatici e non abbiamo eseguito nulla. Questo non è un consiglio legale né di sicurezza.
L'essenziale
- Che cos'è: secondo Anthropic, un prototipo basato su zkSNARK che permette di verificare che una risposta viene da un modello vincolato senza accedere ai suoi pesi. Codice con licenza Apache 2.0; i pesi non sono inclusi.
- A che punto è: il repository è segnato come non mantenuto; TechCrunch riferisce che non è previsto alcun dispiegamento.
- I limiti: decodifica greedy, 1.024 token, un modello aperto (Llama 4 Maverick, non Claude) e circa 70-95 volte il tempo GPU di un servizio vLLM.
- Non accertato: come un'impronta è collegata all'identità dichiarata di un modello commerciale, e l'adozione.
Che cosa pubblica Anthropic?
Il post di Anthropic e il repository (anthropics/FlashProve, v0.16.0) comprendono il codice, le prove in Lean e la documentazione. TechCrunch riferisce che Anthropic descrive il post come un resoconto intermedio dei progressi. Anthropic dice che l'obiettivo della sua tabella di marcia, un prototipo di inferenza dimostrabile, è stato raggiunto da un progetto distinto, ribattezzato «inference verification»; FlashProve è la via puramente crittografica, senza hardware di fiducia (tramite The Decoder e CellCog). Anthropic aggiunge che Claude ha migliorato il lavoro sugli zkSNARK e redatto la specifica del protocollo, e che Lean serve a enunciare garanzie che le persone possano verificare.
Come funziona, in tre passaggi
Secondo Anthropic e GitHub:
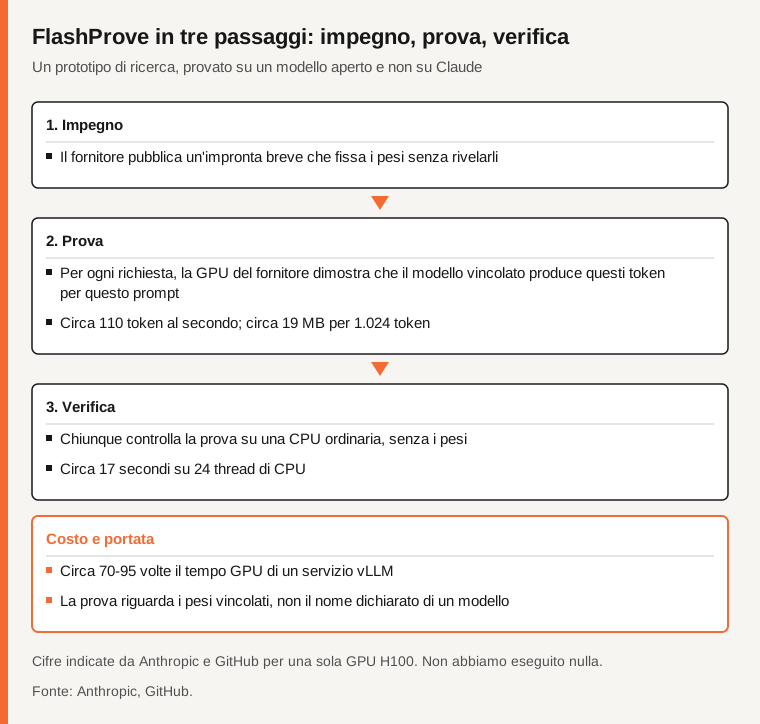
- Impegno: il fornitore pubblica un'impronta breve che fissa un insieme di pesi senza rivelarlo.
- Prova: per ogni richiesta, la sua GPU dimostra che il modello vincolato genera questi token di output per questo prompt.
- Verifica: chiunque controlla la prova su una CPU ordinaria, senza i pesi.
Su una sola GPU H100, le fonti indicano circa 110 token al secondo di generazione della prova, una prova di circa 19 MB per 1.024 token e circa 17 secondi di verifica su 24 thread di CPU. Il dimostratore richiede una H100 da 80 GB dedicata e circa 330 GB di RAM (GitHub).
Fonte: Anthropic, GitHub.
Che cosa stabilisce la prova, e che cosa no
CellCog riferisce che un fornitore che serve un altro modello non può produrre una prova valida per quello vincolato; GitHub indica che questa solidità è dimostrata in Lean, con una probabilità di errore limitata, non nulla. Il modello provato è Llama 4 Maverick di Meta, tramite una conversione a 4 bit di terzi: FlashProve dimostra un modello aperto, non Claude.
La prova mostra la coerenza con un'impronta. Nelle pagine lette, né Anthropic né GitHub spiegano come un'impronta sia collegata all'identità pubblica di un modello commerciale. GitHub aggiunge che l'identificatore dell'impegno deve venire da una parte di cui il verificatore si fida, non dal server.
Anthropic suggerisce che i regolatori verifichino che i fornitori servano solo modelli approvati. TechCrunch aggiunge l'impedire a un laboratorio di sostituire in segreto un modello meno costoso.
I limiti dichiarati
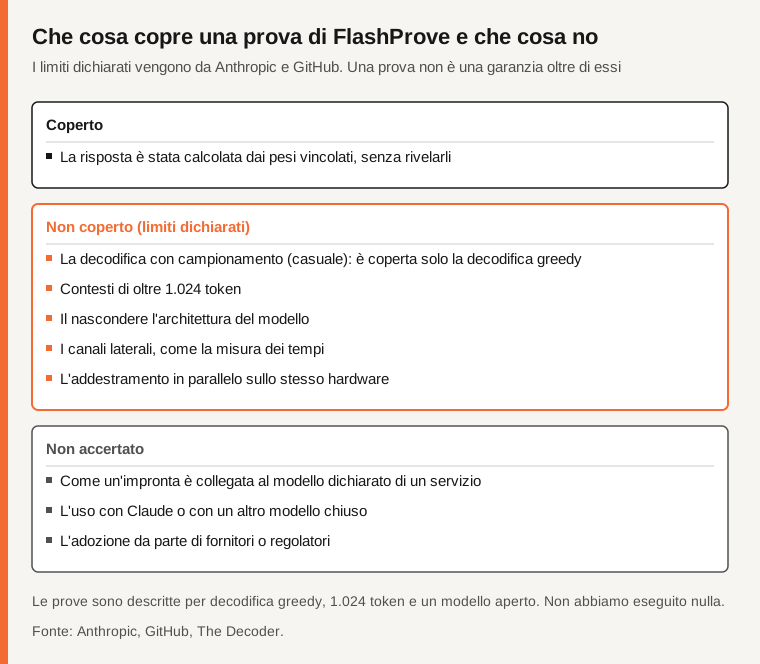
- Solo decodifica greedy: il campionamento casuale, tipico dei chatbot, non è coperto (Anthropic, The Decoder).
- Pesi in aritmetica intera: ritenuti vicini all'inferenza in virgola mobile dai test, senza coprire prompt d'attacco (Anthropic).
- 1.024 token, molto sotto le finestre attuali; l'estensione è lavoro futuro (Anthropic).
- Non del tutto nascosto: l'architettura è visibile e alcuni valori dei pesi sono mascherati tranne un elenco dichiarato (GitHub).
- Fuori ambito: canali laterali come la misura dei tempi, e l'addestramento in parallelo sullo stesso hardware (Anthropic).
- Verifica: il codice veloce in C++/GPU non è verificato formalmente e gli enunciati Lean richiedono un controllo manuale (Anthropic).
Fonte: Anthropic, GitHub, The Decoder.
Che cosa non è accertato?
Come un'impronta è collegata al modello dichiarato di un servizio; la decodifica con campionamento e i contesti lunghi; i modelli chiusi come Claude; una verifica indipendente delle prestazioni; l'adozione da parte di fornitori o regolatori; se il codice funziona come descritto.
Tabella comparativa
| Punto | Che cosa dicono le fonti | Stato |
|---|---|---|
| Modello provato | Llama 4 Maverick, aperto, 4 bit | Dichiarato da Anthropic |
| Costo aggiuntivo | Circa 70-95 volte il tempo GPU di un servizio vLLM | Dichiarato da Anthropic |
| Sistema precedente | VerInf: 14,3 ore, 93,6 GB per 1.000 token | Riferito da CellCog |
| Dispiegamento | Nessuno previsto | Riferito da TechCrunch |
| Impronta e modello dichiarato | Non dettagliato | Non accertato |
Domande frequenti
FlashProve dimostra che Claude è davvero Claude?
No. È stato provato su un modello aperto. L'uso con modelli chiusi come Claude non è accertato.
Si può usare oggi?
Il codice è open source, ma non mantenuto, il dimostratore richiede una H100 da 80 GB e non è previsto alcun dispiegamento. Non l'abbiamo eseguito.
Perché 1.024 token e decodifica greedy?
Anthropic indica entrambi come limiti; i contesti più lunghi sono lavoro futuro. Le pagine lette non danno altri motivi.
Metodo e limiti
Abbiamo letto il post di Anthropic e il repository GitHub tramite riassunti automatici il 4 novembre 2026, oltre a TechCrunch, The Decoder e CellCog (di seconda mano). Non abbiamo letto il rapporto tecnico di Anthropic né usato MarkTechPost o RuntimeWire. Non giudichiamo la crittografia.
Fonti
- Anthropic, Progress on provable inference for large language models, riassunto automatico
- GitHub, anthropics/FlashProve, riassunto automatico
- TechCrunch, Russell Brandom, riassunto automatico
- The Decoder, riassunto automatico
- CellCog, di seconda mano, riassunto automatico
Avete notato un errore in questo articolo? Segnalatelo · La nostra politica sulle correzioni
