Análisis
Anthropic publica FlashProve, un prototipo de investigación de código abierto que demuestra que una respuesta viene de un modelo comprometido, con límites de decodificación voraz, 1024 tokens y un modelo abierto
Anthropic publica FlashProve, prototipo que comprueba que una respuesta viene de un modelo comprometido. Decodificación voraz, 1024 tokens, modelo abierto.
- Nuevas tecnologías de IA
- #Anthropic
- #FlashProve
- #inferencia demostrable
- #pruebas de conocimiento cero
- #código abierto
- #seguridad de la IA
El 2 de noviembre de 2026, el Frontier Red Team de Anthropic publicó una entrada y código abierto de FlashProve, un prototipo de investigación de inferencia demostrable: comprobar criptográficamente que una respuesta viene de un modelo comprometido (committed), no de un sustituto. Es investigación, no un producto. Solo leímos las fuentes mediante resúmenes automáticos y no ejecutamos nada. Esto no es asesoramiento jurídico ni de seguridad.
Lo esencial
- Qué es: según Anthropic, un prototipo basado en zkSNARK que permite comprobar que una respuesta viene de un modelo comprometido sin acceder a sus pesos. Código con licencia Apache 2.0; los pesos no se incluyen.
- Dónde está: el repositorio figura como sin mantenimiento; TechCrunch informa de que no hay ningún despliegue previsto.
- Los límites: decodificación voraz, 1024 tokens, un modelo abierto (Llama 4 Maverick, no Claude) y unas 70 a 95 veces el tiempo de GPU de un servicio vLLM.
- No establecido: cómo se vincula una huella con la identidad anunciada de un modelo comercial, y la adopción.
¿Qué publica Anthropic?
La entrada de Anthropic y el repositorio (anthropics/FlashProve, v0.16.0) incluyen el código, las pruebas en Lean y la documentación. TechCrunch informa de que Anthropic describe la entrada como un informe de avance intermedio. Anthropic dice que el objetivo de su hoja de ruta, un prototipo de inferencia demostrable, se cumplió con un proyecto distinto, rebautizado «inference verification»; FlashProve es la vía puramente criptográfica, sin hardware de confianza (vía The Decoder y CellCog). Anthropic añade que Claude mejoró el trabajo sobre zkSNARK y redactó la especificación del protocolo, y que Lean sirve para enunciar garantías que personas puedan auditar.
Cómo funciona, en tres pasos
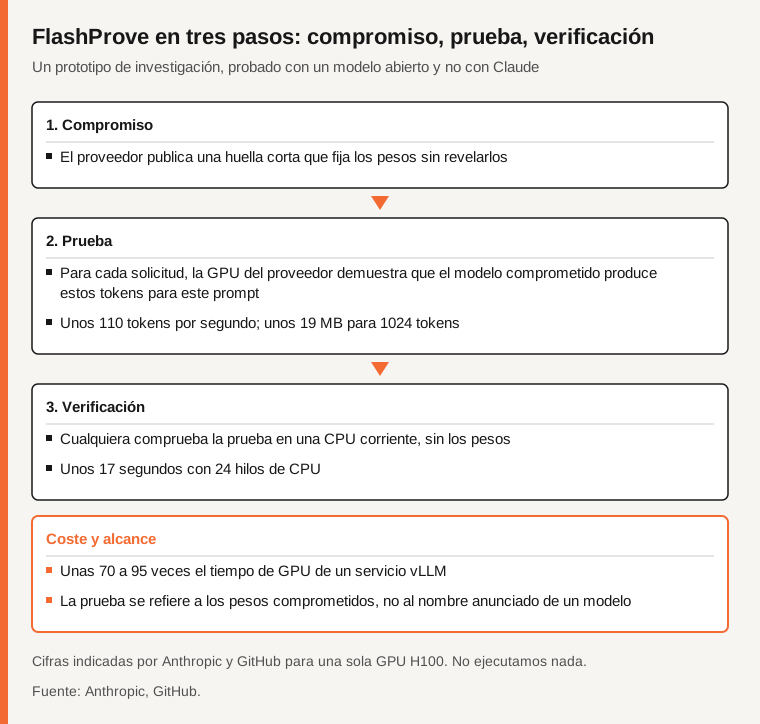
Según Anthropic y GitHub:
- Compromiso: el proveedor publica una huella corta que fija un conjunto de pesos sin revelarlo.
- Prueba: para cada solicitud, su GPU demuestra que el modelo comprometido genera estos tokens de salida para este prompt.
- Verificación: cualquiera comprueba la prueba en una CPU corriente, sin los pesos.
En una sola GPU H100, las fuentes dan unos 110 tokens por segundo de generación de prueba, una prueba de unos 19 MB para 1024 tokens y unos 17 segundos de verificación con 24 hilos de CPU. El probador exige una H100 de 80 GB dedicada y unos 330 GB de RAM (GitHub).
Fuente: Anthropic, GitHub.
Qué establece la prueba y qué no
CellCog informa de que un proveedor que sirva otro modelo no puede producir una prueba válida para el modelo comprometido; GitHub indica que esta solidez está demostrada en Lean, con una probabilidad de error acotada, no nula. El modelo de prueba fue Llama 4 Maverick de Meta, mediante una conversión a 4 bits de un tercero: FlashProve demuestra un modelo abierto, no Claude.
La prueba muestra coherencia con una huella. En las páginas leídas, ni Anthropic ni GitHub detallan cómo se vincula una huella con la identidad pública de un modelo comercial. GitHub añade que el identificador del compromiso debe venir de una parte de confianza del verificador, no del servidor.
Anthropic sugiere que los reguladores comprueben que los proveedores solo sirven modelos aprobados. TechCrunch añade impedir que un laboratorio sustituya en secreto un modelo más barato.
Los límites declarados
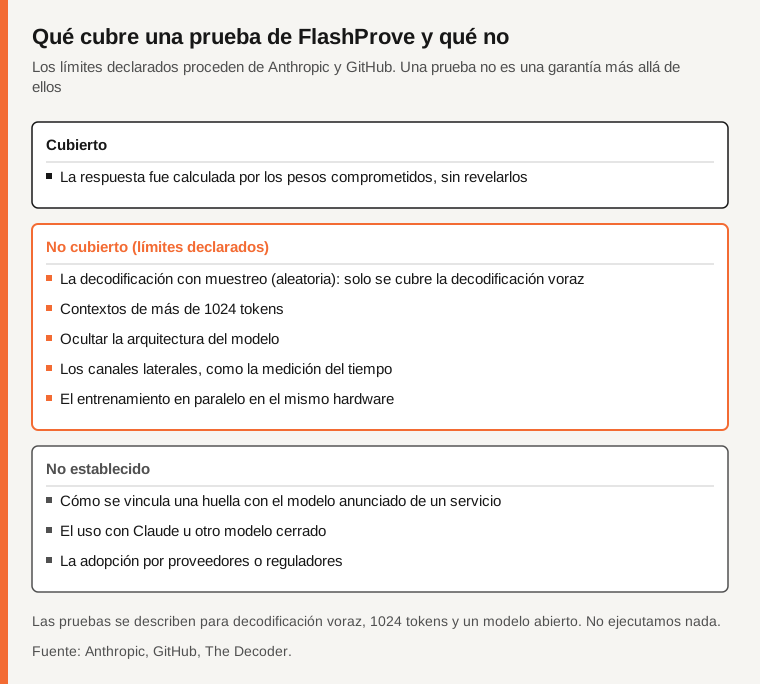
- Solo decodificación voraz: el muestreo aleatorio, típico de los chatbots, no está cubierto (Anthropic, The Decoder).
- Pesos en aritmética entera: considerados cercanos a la inferencia en coma flotante según pruebas, sin cubrir prompts de ataque (Anthropic).
- 1024 tokens, muy por debajo de las ventanas actuales; ampliarlo es trabajo futuro (Anthropic).
- No del todo oculto: la arquitectura es visible y algunos valores de los pesos se enmascaran salvo una lista declarada (GitHub).
- Fuera de alcance: canales laterales como la medición del tiempo, y el entrenamiento en paralelo en el mismo hardware (Anthropic).
- Comprobación: el código rápido en C++/GPU no está verificado formalmente y los enunciados de Lean requieren auditoría manual (Anthropic).
Fuente: Anthropic, GitHub, The Decoder.
¿Qué no está establecido?
Cómo se vincula una huella con el modelo anunciado de un servicio; la decodificación con muestreo y los contextos largos; los modelos cerrados como Claude; una comprobación independiente del rendimiento; la adopción por proveedores o reguladores; si el código funciona como se describe.
Tabla comparativa
| Punto | Lo que dicen las fuentes | Estado |
|---|---|---|
| Modelo de prueba | Llama 4 Maverick, abierto, 4 bits | Declarado por Anthropic |
| Sobrecoste | Unas 70 a 95 veces el tiempo de GPU de un servicio vLLM | Declarado por Anthropic |
| Sistema anterior | VerInf: 14,3 horas, 93,6 GB para 1000 tokens | Informado por CellCog |
| Despliegue | Ninguno previsto | Informado por TechCrunch |
| Huella a modelo anunciado | No detallado | No establecido |
Preguntas frecuentes
¿FlashProve demuestra que Claude es de verdad Claude?
No. Se probó con un modelo abierto. El uso con modelos cerrados como Claude no está establecido.
¿Se puede usar hoy?
El código es de código abierto, pero sin mantenimiento, el probador exige una H100 de 80 GB y no hay despliegue previsto. No lo ejecutamos.
¿Por qué 1024 tokens y decodificación voraz?
Anthropic da ambos como límites; los contextos más largos son trabajo futuro. Las páginas leídas no dan otra razón.
Método y límites
Leímos la entrada de Anthropic y el repositorio de GitHub mediante resúmenes automáticos el 4 de noviembre de 2026, además de TechCrunch, The Decoder y CellCog (de segunda mano). No leímos el informe técnico de Anthropic ni usamos MarkTechPost o RuntimeWire. No juzgamos la criptografía.
Fuentes
- Anthropic, Progress on provable inference for large language models, resumen automático
- GitHub, anthropics/FlashProve, resumen automático
- TechCrunch, Russell Brandom, resumen automático
- The Decoder, resumen automático
- CellCog, de segunda mano, resumen automático
¿Ha detectado un error en este artículo? Comuníquenoslo · Nuestra política de correcciones
