Análise
Anthropic publica o FlashProve, um protótipo de pesquisa de código aberto que prova que uma resposta veio de um modelo comprometido, com limites de decodificação gulosa, 1.024 tokens e um modelo aberto
A Anthropic publica o FlashProve, protótipo que verifica se uma resposta veio de um modelo comprometido. Decodificação gulosa, 1.024 tokens, modelo aberto.
- Novas tecnologias de IA
- #Anthropic
- #FlashProve
- #inferência comprovável
- #provas de conhecimento zero
- #código aberto
- #segurança da IA
Em 2 de novembro de 2026, a Frontier Red Team da Anthropic publicou um texto e código aberto do FlashProve, um protótipo de pesquisa de inferência comprovável: verificar criptograficamente que uma resposta veio de um modelo comprometido (committed), não de um substituto. É pesquisa, não um produto. Lemos as fontes apenas por resumos automáticos e não executamos nada. Isto não é aconselhamento jurídico nem de segurança.
O essencial
- O que é: segundo a Anthropic, um protótipo baseado em zkSNARK que permite verificar que uma resposta veio de um modelo comprometido sem acesso aos seus pesos. Código sob licença Apache 2.0; os pesos não estão incluídos.
- Em que pé está: o repositório está marcado como sem manutenção; o TechCrunch informa que nenhum uso em produção está previsto.
- Os limites: decodificação gulosa, 1.024 tokens, um modelo aberto (Llama 4 Maverick, não Claude) e cerca de 70 a 95 vezes o tempo de GPU de um serviço vLLM.
- Não estabelecido: como uma impressão digital se liga à identidade anunciada de um modelo comercial, e a adoção.
O que a Anthropic publica?
O texto da Anthropic e o repositório (anthropics/FlashProve, v0.16.0) incluem o código, as provas em Lean e a documentação. O TechCrunch informa que a Anthropic descreve o texto como um balanço intermediário do andamento. A Anthropic diz que o objetivo do seu roteiro, um protótipo de inferência comprovável, foi atingido por um projeto distinto, rebatizado de "inference verification"; o FlashProve é o caminho puramente criptográfico, sem hardware de confiança (via The Decoder e CellCog). A Anthropic acrescenta que Claude melhorou o trabalho com zkSNARK e redigiu a especificação do protocolo, e que o Lean serve para enunciar garantias que pessoas possam auditar.
Como funciona, em três etapas
Segundo a Anthropic e o GitHub:
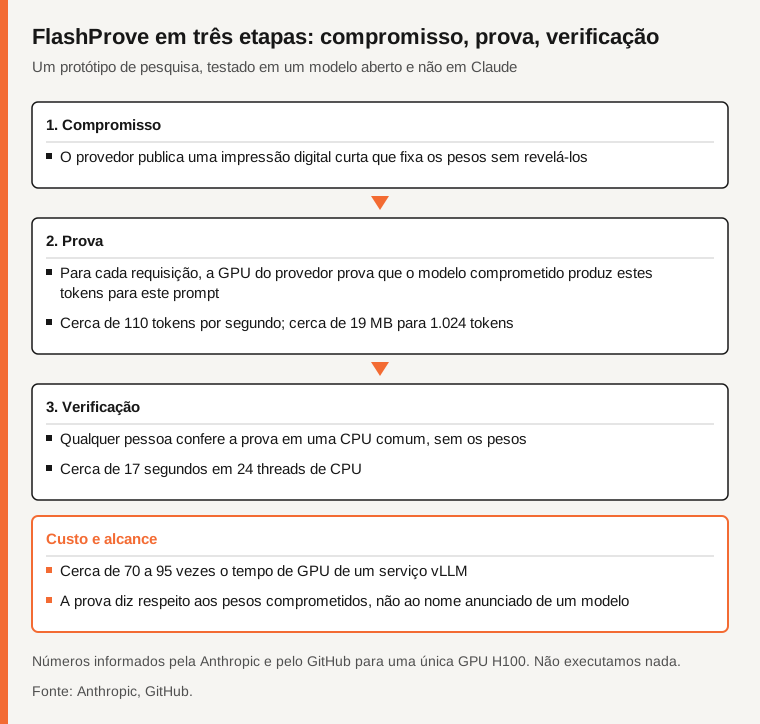
- Compromisso: o provedor publica uma impressão digital curta que fixa um conjunto de pesos sem revelá-lo.
- Prova: para cada requisição, sua GPU prova que o modelo comprometido gera estes tokens de saída para este prompt.
- Verificação: qualquer pessoa confere a prova em uma CPU comum, sem os pesos.
Em uma única GPU H100, as fontes citam cerca de 110 tokens por segundo na geração da prova, uma prova de cerca de 19 MB para 1.024 tokens e cerca de 17 segundos de verificação em 24 threads de CPU. O provador exige uma H100 de 80 GB dedicada e cerca de 330 GB de RAM (GitHub).
Fonte: Anthropic, GitHub.
O que a prova estabelece e o que não estabelece
O CellCog informa que um provedor que serve outro modelo não consegue produzir uma prova válida para o modelo comprometido; o GitHub indica que essa solidez é provada em Lean, com uma probabilidade de erro limitada, não nula. O modelo testado foi o Llama 4 Maverick, da Meta, por meio de uma conversão em 4 bits feita por terceiros: o FlashProve prova um modelo aberto, não Claude.
A prova mostra coerência com uma impressão digital. Nas páginas lidas, nem a Anthropic nem o GitHub detalham como uma impressão digital se liga à identidade pública de um modelo comercial. O GitHub acrescenta que o identificador do compromisso deve vir de uma parte em que o verificador confia, não do servidor.
A Anthropic sugere que reguladores verifiquem se os provedores servem apenas modelos aprovados. O TechCrunch acrescenta impedir que um laboratório troque em segredo por um modelo mais barato.
Os limites declarados
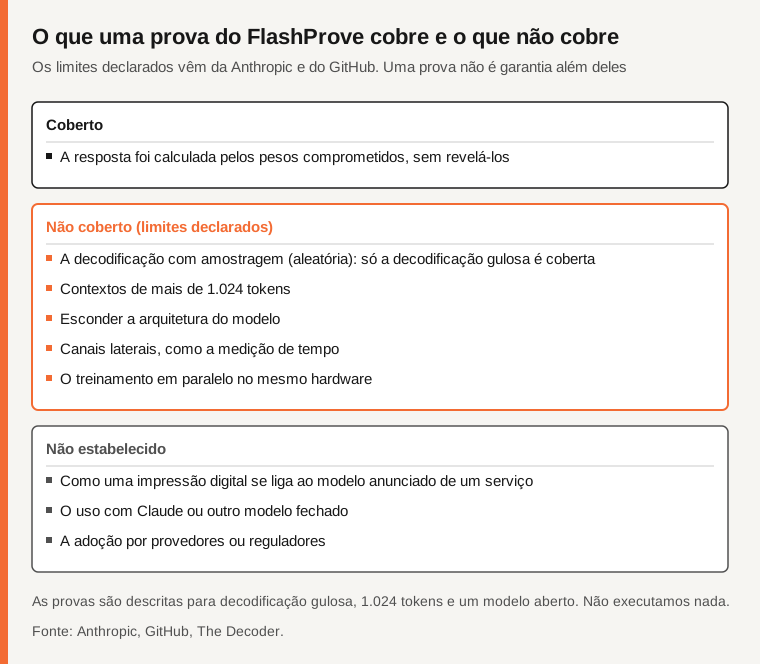
- Só decodificação gulosa: a amostragem aleatória, típica dos chatbots, não é coberta (Anthropic, The Decoder).
- Pesos em aritmética inteira: considerados próximos da inferência em ponto flutuante por testes, sem cobrir prompts de ataque (Anthropic).
- 1.024 tokens, muito abaixo das janelas atuais; ampliar é trabalho futuro (Anthropic).
- Não totalmente oculto: a arquitetura é visível e alguns valores dos pesos são mascarados, exceto uma lista declarada (GitHub).
- Fora do escopo: canais laterais, como a medição de tempo, e o treinamento em paralelo no mesmo hardware (Anthropic).
- Verificação: o código rápido em C++/GPU não é verificado formalmente, e os enunciados em Lean precisam de auditoria manual (Anthropic).
Fonte: Anthropic, GitHub, The Decoder.
O que não está estabelecido?
Como uma impressão digital se liga ao modelo anunciado de um serviço; a decodificação com amostragem e os contextos longos; os modelos fechados, como Claude; uma verificação independente do desempenho; a adoção por provedores ou reguladores; se o código funciona como descrito.
Tabela comparativa
| Ponto | O que dizem as fontes | Situação |
|---|---|---|
| Modelo testado | Llama 4 Maverick, aberto, 4 bits | Declarado pela Anthropic |
| Custo adicional | Cerca de 70 a 95 vezes o tempo de GPU de um serviço vLLM | Declarado pela Anthropic |
| Sistema anterior | VerInf: 14,3 horas, 93,6 GB para 1.000 tokens | Relatado pelo CellCog |
| Uso em produção | Nenhum previsto | Relatado pelo TechCrunch |
| Impressão digital e modelo anunciado | Não detalhado | Não estabelecido |
Perguntas frequentes
O FlashProve prova que Claude é mesmo Claude?
Não. Foi testado em um modelo aberto. O uso com modelos fechados, como Claude, não está estabelecido.
Dá para usar hoje?
O código é aberto, mas sem manutenção, o provador exige uma H100 de 80 GB e não há uso em produção previsto. Não o executamos.
Por que 1.024 tokens e decodificação gulosa?
A Anthropic aponta ambos como limites; contextos mais longos são trabalho futuro. As páginas lidas não dão outro motivo.
Método e limites
Lemos o texto da Anthropic e o repositório do GitHub por resumos automáticos em 4 de novembro de 2026, além do TechCrunch, do The Decoder e do CellCog (de segunda mão). Não lemos o relatório técnico da Anthropic nem usamos MarkTechPost ou RuntimeWire. Não julgamos a criptografia.
Fontes
- Anthropic, Progress on provable inference for large language models, lido em um resumo automático
- GitHub, anthropics/FlashProve, lido em um resumo automático
- TechCrunch, Russell Brandom, lido em um resumo automático
- The Decoder, lido em um resumo automático
- CellCog, de segunda mão, lido em um resumo automático
Encontrou um erro neste artigo? Avise-nos · Nossa política de correções
