Analyse
Anthropic veröffentlicht FlashProve, einen Open-Source-Forschungsprototyp, der belegt, dass eine Antwort von einem festgelegten Modell stammt, mit den Grenzen Greedy-Dekodierung, 1.024 Tokens und offenes Modell
Anthropic veröffentlicht FlashProve, einen Prototyp, der prüft, ob eine Antwort von einem festgelegten Modell stammt. Nur Greedy, 1.024 Tokens, offen.
- Neue KI-Technologien
- #Anthropic
- #FlashProve
- #nachweisbare Inferenz
- #Zero-Knowledge-Beweise
- #Open Source
- #KI-Sicherheit
Am 2. November 2026 hat das Frontier Red Team von Anthropic einen Beitrag und Open-Source-Code zu FlashProve veröffentlicht, einem Forschungsprototyp für nachweisbare Inferenz: kryptografisch prüfen, dass eine Antwort von einem festgelegten Modell (committed) stammt und nicht von einem Ersatz. Es ist Forschung, kein Produkt. Wir haben die Quellen nur über automatische Zusammenfassungen gelesen und nichts ausgeführt. Dies ist weder Rechts- noch Sicherheitsberatung.
Das Wichtigste
- Was es ist: laut Anthropic ein Prototyp auf Basis von zkSNARK, mit dem sich prüfen lässt, dass eine Antwort von einem festgelegten Modell stammt, ohne Zugriff auf dessen Gewichte. Code unter Apache 2.0; die Gewichte sind nicht enthalten.
- Wo es steht: Das Repository ist als nicht gepflegt markiert; TechCrunch berichtet, dass kein Einsatz geplant ist.
- Die Grenzen: Greedy-Dekodierung, 1.024 Tokens, ein offenes Modell (Llama 4 Maverick, nicht Claude) und rund das 70- bis 95-Fache der GPU-Zeit eines vLLM-Dienstes.
- Nicht belegt: wie ein Fingerabdruck mit der angekündigten Identität eines kommerziellen Modells verknüpft ist, und die Übernahme.
Was veröffentlicht Anthropic?
Anthropics Beitrag und das Repository (anthropics/FlashProve, v0.16.0) umfassen den Code, die Lean-Beweise und die Dokumentation. TechCrunch berichtet, Anthropic beschreibe den Beitrag als Zwischenstand. Anthropic sagt, das Ziel seiner Roadmap, ein Prototyp für nachweisbare Inferenz, sei durch ein separates Projekt erreicht worden, das in „inference verification“ umbenannt wurde; FlashProve sei der rein kryptografische Weg ohne vertrauenswürdige Hardware (laut The Decoder und CellCog). Anthropic fügt hinzu, Claude habe die zkSNARK-Arbeit verbessert und die Protokollspezifikation verfasst; Lean dient dazu, Garantien zu formulieren, die Menschen prüfen können.
So funktioniert es, in drei Schritten
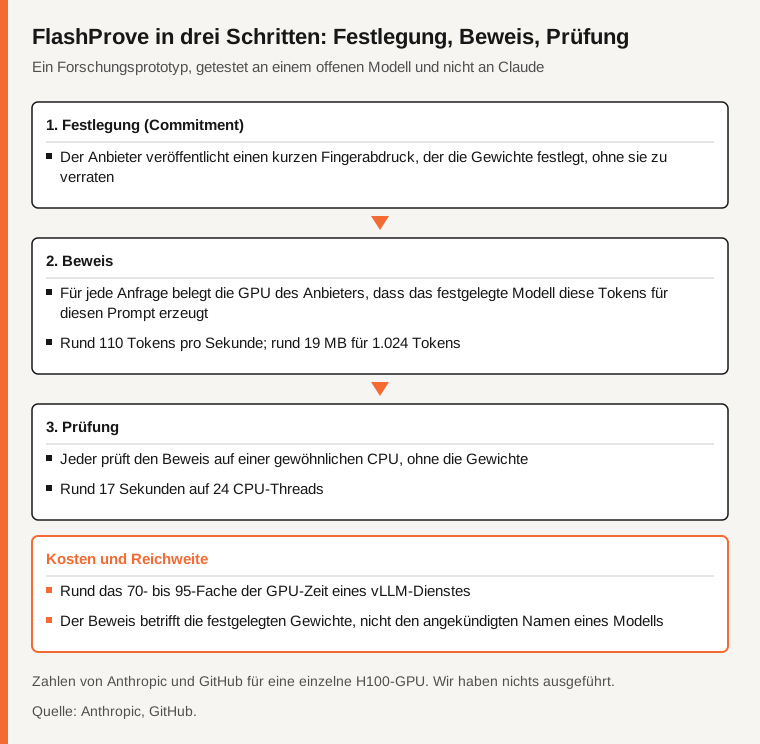
Laut Anthropic und GitHub:
- Festlegung (Commitment): Der Anbieter veröffentlicht einen kurzen Fingerabdruck, der einen Satz Gewichte festlegt, ohne ihn zu verraten.
- Beweis: Für jede Anfrage belegt seine GPU, dass das festgelegte Modell diese Ausgabe-Tokens für diesen Prompt erzeugt.
- Prüfung: Jeder prüft den Beweis auf einer gewöhnlichen CPU, ohne die Gewichte.
Auf einer einzelnen H100-GPU nennen die Quellen rund 110 Tokens pro Sekunde bei der Beweiserzeugung, einen Beweis von rund 19 MB für 1.024 Tokens und rund 17 Sekunden Prüfzeit auf 24 CPU-Threads. Der Beweiser braucht eine eigene H100 mit 80 GB und rund 330 GB RAM (GitHub).
Quelle: Anthropic, GitHub.
Was der Beweis belegt und was nicht
CellCog berichtet, dass ein Anbieter, der ein anderes Modell ausliefert, keinen gültigen Beweis für das festgelegte erzeugen kann; laut GitHub ist diese Korrektheit in Lean bewiesen, mit einer begrenzten, nicht null betragenden Fehlerwahrscheinlichkeit. Getestet wurde Metas Llama 4 Maverick über eine 4-Bit-Umwandlung eines Dritten: FlashProve belegt ein offenes Modell, nicht Claude.
Der Beweis zeigt Übereinstimmung mit einem Fingerabdruck. In den gelesenen Seiten erläutern weder Anthropic noch GitHub, wie ein Fingerabdruck mit der öffentlichen Identität eines kommerziellen Modells verknüpft wird. GitHub ergänzt, dass die Kennung der Festlegung von einer Partei stammen muss, der der Prüfer vertraut, nicht vom Server.
Anthropic schlägt vor, dass Aufsichtsbehörden prüfen, ob Anbieter nur genehmigte Modelle ausliefern. TechCrunch ergänzt: zu verhindern, dass ein Labor heimlich ein billigeres Modell einsetzt.
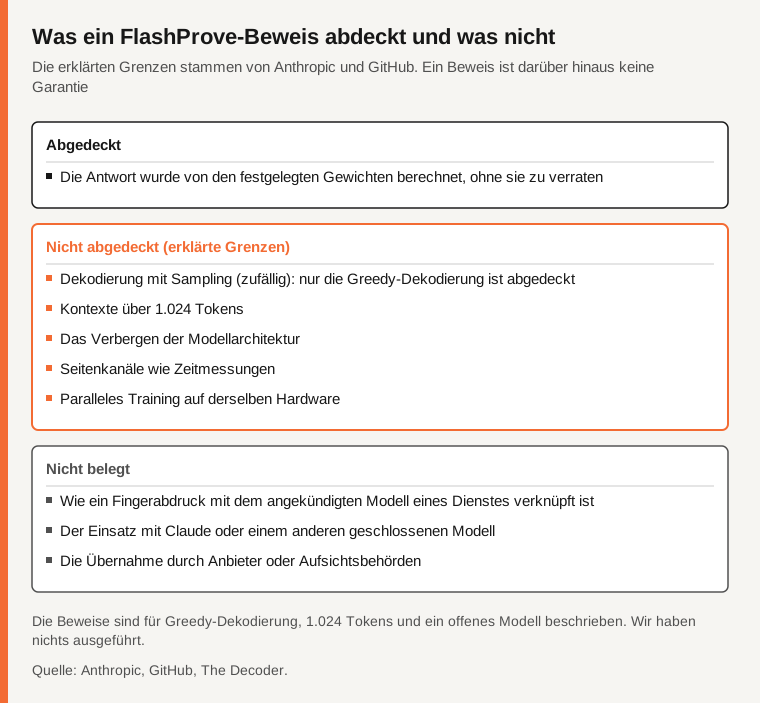
Die erklärten Grenzen
- Nur Greedy-Dekodierung: Zufälliges Sampling, typisch für Chatbots, ist nicht abgedeckt (Anthropic, The Decoder).
- Gewichte in Ganzzahlarithmetik: in Tests als nah an der Gleitkomma-Inferenz bewertet, ohne Angriffs-Prompts abzudecken (Anthropic).
- 1.024 Tokens, weit unter heutigen Kontextfenstern; die Erweiterung ist künftige Arbeit (Anthropic).
- Nicht vollständig verborgen: Die Architektur ist sichtbar, und einige Gewichtswerte sind maskiert, außer einer erklärten Liste (GitHub).
- Außerhalb des Umfangs: Seitenkanäle wie Zeitmessungen und paralleles Training auf derselben Hardware (Anthropic).
- Prüfung: Der schnelle C++/GPU-Code ist nicht formal verifiziert, und die Lean-Aussagen müssen von Hand geprüft werden (Anthropic).
Quelle: Anthropic, GitHub, The Decoder.
Was ist nicht belegt?
Wie ein Fingerabdruck mit dem angekündigten Modell eines Dienstes verknüpft ist; Dekodierung mit Sampling und lange Kontexte; geschlossene Modelle wie Claude; eine unabhängige Leistungsprüfung; die Übernahme durch Anbieter oder Aufsichtsbehörden; ob der Code wie beschrieben läuft.
Vergleichstabelle
| Punkt | Was die Quellen sagen | Status |
|---|---|---|
| Testmodell | Llama 4 Maverick, offen, 4 Bit | Von Anthropic erklärt |
| Mehraufwand | Rund das 70- bis 95-Fache der GPU-Zeit eines vLLM-Dienstes | Von Anthropic erklärt |
| Früheres System | VerInf: 14,3 Stunden, 93,6 GB für 1.000 Tokens | Von CellCog berichtet |
| Einsatz | Keiner geplant | Von TechCrunch berichtet |
| Fingerabdruck zu angekündigtem Modell | Nicht erläutert | Nicht belegt |
Häufige Fragen
Belegt FlashProve, dass Claude wirklich Claude ist?
Nein. Es wurde an einem offenen Modell getestet. Der Einsatz mit geschlossenen Modellen wie Claude ist nicht belegt.
Kann man es heute nutzen?
Der Code ist Open Source, aber nicht gepflegt, der Beweiser braucht eine H100 mit 80 GB, und ein Einsatz ist nicht geplant. Wir haben ihn nicht ausgeführt.
Warum 1.024 Tokens und Greedy-Dekodierung?
Anthropic nennt beides als Grenzen; längere Kontexte sind künftige Arbeit. Die gelesenen Seiten nennen keinen weiteren Grund.
Methode und Grenzen
Wir haben Anthropics Beitrag und das GitHub-Repository am 4. November 2026 über automatische Zusammenfassungen gelesen, dazu TechCrunch, The Decoder und CellCog (aus zweiter Hand). Wir haben den technischen Bericht von Anthropic nicht gelesen und MarkTechPost sowie RuntimeWire nicht verwendet. Die Kryptografie beurteilen wir nicht.
Quellen
- Anthropic, Progress on provable inference for large language models, per automatischer Zusammenfassung gelesen
- GitHub, anthropics/FlashProve, per automatischer Zusammenfassung gelesen
- TechCrunch, Russell Brandom, per automatischer Zusammenfassung gelesen
- The Decoder, per automatischer Zusammenfassung gelesen
- CellCog, aus zweiter Hand, per automatischer Zusammenfassung gelesen
Einen Fehler in diesem Artikel entdeckt? Melden Sie ihn · Unsere Korrekturrichtlinie
