Analyse
LiberAI dévoile Liber-0, un modèle monde-action préentraîné sur plus de 2,2 millions d'heures d'expérience humaine, avec 36 % de réussite zero-shot sur 60 tâches selon la société
LiberAI annonce 36,0 % de réussite zero-shot pour Liber-0, préentraîné sur plus de 2,2 millions d'heures d'expérience humaine. Évaluation de la société.
- Nouvelles technologies IA
- #LiberAI
- #Liber-0
- #modèles monde-action
- #robotique
- #apprentissage zero-shot
- #vidéo humaine
Le 3 novembre 2026, LiberAI, une startup de « physical AI », a présenté Liber-0, un « world action model » pour la manipulation robotique, préentraîné, dit-elle, sur plus de 2,2 millions d'heures d'expérience humaine. LiberAI annonce 36,0 % de réussite zero-shot sur 60 tâches. Tous les chiffres viennent de la société ; nous n'avons trouvé aucune couverture indépendante. Nous avons lu trois pages par résumés automatiques et n'avons rien exécuté. Ceci n'est ni un conseil d'investissement ni un conseil technique.
L'essentiel
- Le résultat : selon LiberAI, 36,0 % de réussite sur 600 essais, pour 60 tâches proposées par GPT-6, et 10,5 % sur les tâches difficiles.
- Les heures : plus de 2,2 millions d'heures d'expérience humaine, qui ne sont pas, dit LiberAI, des millions d'heures de démonstrations de robot.
- Les sources : les trois pages reprennent l'annonce de LiberAI ; The Robot Report est un contenu sponsorisé par LiberAI.
- Non établi : la reproduction indépendante, la publication des poids ou du code, le robot utilisé.
Qu'est-ce que Liber-0 ?
Un world action model apprend les relations entre observations visuelles, actions physiques et ce qui se passe ensuite, et prédit conjointement les images vidéo futures et les actions (The Robot Report, Robotics & Automation News). En bref, il prédit ce qu'il verra ensuite et ce qu'il faut faire.
LiberAI est décrite comme basée à Pékin (The Robot Report) et fondée en décembre 2025 (Robotics & Automation News) ; Songming Liu, à l'origine de la société, en est PDG (The Robot Report). Son but déclaré : des robots généralistes pour la maison.
L'entraînement comporte trois étapes, selon Robotics & Automation News : prédiction visuelle à partir de vidéos humaines ; prédiction conjointe d'images et d'actions ; étape finale centrée sur la manipulation. Les gants LiberSense Glove enregistrent poses et trajectoires de la main avec une caméra à la première personne et deux caméras aux poignets, sans robot sur place (The Robot Report, Robotics & Automation News).
Que sont ces heures d'expérience humaine ?
LiberAI dit que le préentraînement a utilisé plus de 2,2 millions d'heures d'expérience humaine. Robotics & Automation News en décrit l'essentiel comme de la vidéo d'activité humaine à grande échelle, sans répartition par source. The Robot Report ne dit pas comment elles se répartissent entre vidéo web et données de gants, ni comment elles sont comptées. La société précise que ce chiffre ne signifie pas des millions d'heures de démonstrations faites à la main pour des robots ; le préentraînement incluait aussi des données de robot (communiqué, The Robot Report).
Les résultats annoncés
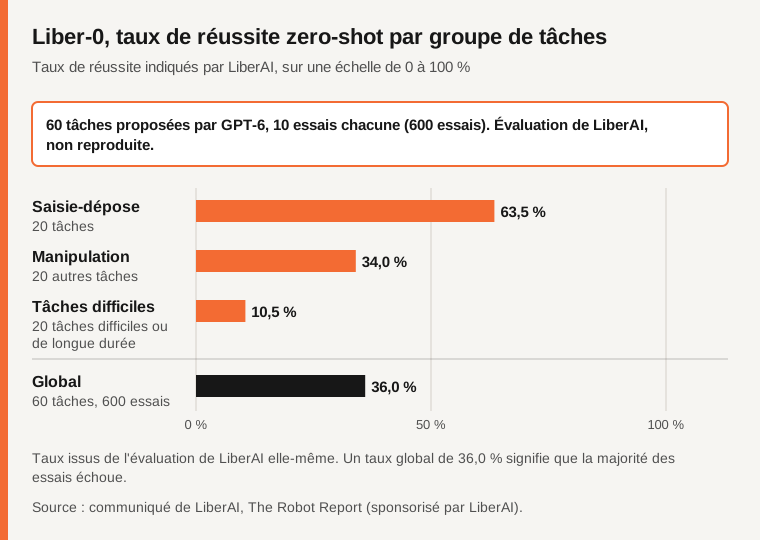
LiberAI a mené l'évaluation elle-même : 60 tâches proposées par GPT-6, chacune testée 10 fois, soit 600 essais (communiqué).
Source : communiqué de LiberAI, The Robot Report (sponsorisé par LiberAI).
LiberAI annonce 36,0 % au global, 63,5 % sur 20 tâches de saisie-dépose (pick-and-place), 34,0 % sur 20 autres tâches de manipulation et 10,5 % sur 20 tâches difficiles ou de longue durée (communiqué, The Robot Report). Robotics & Automation News écrit que la plupart des tâches évaluées échouent encore ; nous lisons les 36,0 % de la même façon.
« Zero-shot » a le sens de LiberAI : pas d'entraînement sur des démonstrations de robot pour ces tâches cibles, bien que le préentraînement ait inclus des données de robot (communiqué, The Robot Report).
LiberAI affirme aussi qu'après le même post-entraînement sur robot, 10 000 heures d'enregistrements de gants surpassent 2 millions d'heures de vidéo humaine du web. Aucun score n'est donné et les deux articles n'en parlent pas : une affirmation de la société, non vérifiée.
Limites déclarées par LiberAI
Les gants n'enregistrent ni contact ni force, importants pour l'insertion, la fixation et les matériaux souples. La vidéo humaine seule souffre d'un écart de supervision d'action et d'un écart d'incarnation. Les performances sur les tâches difficiles et de longue durée restent limitées. Le toucher, la force et la collecte dans plus de foyers sont des pistes futures.
Qu'est-ce qui n'est pas établi ?
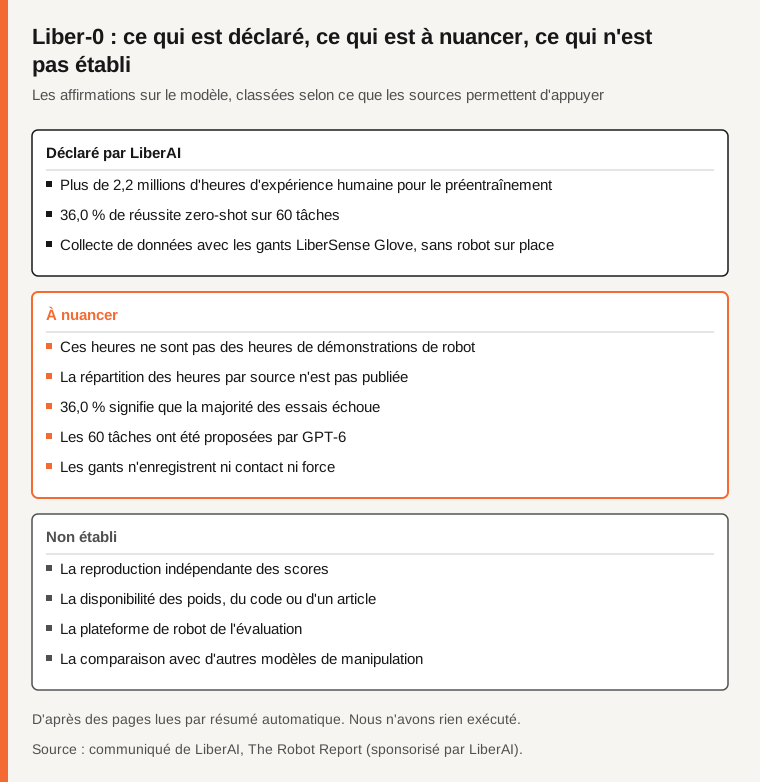
La répartition des heures par source ; la reproduction indépendante des 36,0 % et de la comparaison sur les gants ; la plateforme de robot de l'évaluation ; toute publication de poids, de code ou d'accès ; comment GPT-6 a choisi les tâches et leur difficulté ; la comparaison avec d'autres modèles de manipulation ; le financement et la taille de la société.
Source : communiqué de LiberAI, The Robot Report (sponsorisé par LiberAI).
Tableau comparatif
| Point | Ce que disent les sources | Statut |
|---|---|---|
| Résultat | 36,0 % sur 60 tâches ; 10,5 % sur les tâches difficiles | Déclaré par la société |
| Heures | Plus de 2,2 millions d'heures, surtout de la vidéo d'activité humaine | Déclaré par la société, répartition non publiée |
| Publication, reproduction | Aucun poids, code ni article mentionné | Non établi |
Questions fréquentes
Ces heures d'expérience humaine sont-elles des démonstrations de robot ?
Non. LiberAI précise que ce chiffre ne signifie pas des millions d'heures de démonstrations faites à la main pour des robots.
Que veut dire 36,0 % ?
Le taux global de réussite zero-shot de LiberAI sur 600 essais : la majorité des essais échoue.
Le modèle est-il disponible ?
Aucune page lue ne mentionne de poids, de code, d'accès ouvert, de prix ni de calendrier, et aucun article scientifique n'est nommé. Le communiqué mentionne un blog technique, des vidéos et une simulation interactive.
Méthode et limites
Le 4 novembre 2026, nous avons lu par résumés automatiques le communiqué de LiberAI du 3 novembre repris par Digital Media Net via ACCESS Newswire (la version FinancialContent a renvoyé une erreur), The Robot Report, contenu sponsorisé par LiberAI, et Robotics & Automation News (Sam Francis). Nous n'avons pas lu le blog technique, les vidéos, la simulation ni le compte X de LiberAI. Les scores ne sont pas reproduits.
Sources
- Communiqué de LiberAI via ACCESS Newswire, Digital Media Net, résumé automatique
- The Robot Report, contenu sponsorisé par LiberAI, résumé automatique
- Robotics & Automation News, Sam Francis, résumé automatique
Une erreur dans cet article ? Signalez-la · Notre politique de corrections
