Analisi
LiberAI presenta Liber-0, un modello world-action pre-addestrato su oltre 2,2 milioni di ore di esperienza umana, con il 36% di successo zero-shot su 60 compiti secondo la società
LiberAI riporta il 36,0% di successo zero-shot per Liber-0, pre-addestrato su oltre 2,2 milioni di ore di esperienza umana. Valutazione della società.
- Nuove tecnologie di IA
- #LiberAI
- #Liber-0
- #modelli world-action
- #robotica
- #apprendimento zero-shot
- #video umani
Il 3 novembre 2026 LiberAI, una startup di «physical AI», ha presentato Liber-0, un «world action model» per la manipolazione robotica, pre-addestrato, dice, su oltre 2,2 milioni di ore di esperienza umana. LiberAI riporta il 36,0% di successo zero-shot su 60 compiti. Tutte le cifre vengono dalla società; non abbiamo trovato alcuna copertura indipendente. Abbiamo letto tre pagine tramite riassunti automatici e non abbiamo eseguito nulla. Questo non è né un consiglio di investimento né un consiglio tecnico.
L'essenziale
- Il risultato: secondo LiberAI, il 36,0% di successo su 600 prove, con 60 compiti proposti da GPT-6, e il 10,5% sui compiti difficili.
- Le ore: oltre 2,2 milioni di ore di esperienza umana, che secondo LiberAI non sono milioni di ore di dimostrazioni di robot.
- Le fonti: le tre pagine ripetono l'annuncio di LiberAI; The Robot Report è un contenuto sponsorizzato da LiberAI.
- Non accertato: la riproduzione indipendente, la pubblicazione di pesi o codice, il robot usato.
Che cos'è Liber-0?
Un world action model impara le relazioni tra osservazioni visive, azioni fisiche e ciò che accade dopo, e prevede congiuntamente i futuri fotogrammi video e le azioni (The Robot Report, Robotics & Automation News). In breve, prevede ciò che vedrà dopo e che cosa fare.
LiberAI è descritta come con sede a Pechino (The Robot Report) e fondata nel dicembre 2025 (Robotics & Automation News); Songming Liu, che ha fondato la società, ne è CEO (The Robot Report). Il suo obiettivo dichiarato: robot generalisti per la casa.
L'addestramento ha tre fasi, secondo Robotics & Automation News: previsione visiva da video umani; previsione congiunta di fotogrammi e azioni; una fase finale dedicata alla manipolazione. I guanti LiberSense Glove registrano pose e traiettorie della mano con una telecamera in prima persona e due telecamere ai polsi, senza robot sul posto (The Robot Report, Robotics & Automation News).
Che cosa sono queste ore di esperienza umana?
LiberAI dice che il pre-addestramento ha usato oltre 2,2 milioni di ore di esperienza umana. Robotics & Automation News ne descrive la maggior parte come video di attività umana su larga scala, senza ripartizione per fonte. The Robot Report non dice come si ripartiscano tra video dal web e dati dei guanti, né come vengano contate. La società precisa che la cifra non significa milioni di ore di dimostrazioni fatte a mano per i robot; il pre-addestramento includeva anche dati di robot (comunicato, The Robot Report).
I risultati annunciati
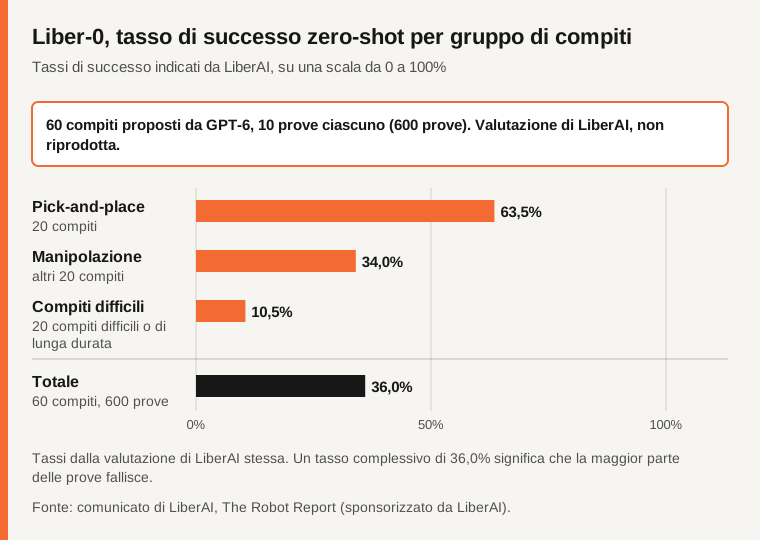
LiberAI ha condotto da sé la valutazione: 60 compiti proposti da GPT-6, ciascuno provato 10 volte, cioè 600 prove (comunicato).
Fonte: comunicato di LiberAI, The Robot Report (sponsorizzato da LiberAI).
LiberAI riporta il 36,0% complessivo, il 63,5% su 20 compiti di pick-and-place, il 34,0% su altri 20 compiti di manipolazione e il 10,5% su 20 compiti difficili o di lunga durata (comunicato, The Robot Report). Robotics & Automation News scrive che la maggior parte dei compiti valutati fallisce ancora; leggiamo il 36,0% allo stesso modo.
«Zero-shot» ha il senso di LiberAI: nessun addestramento su dimostrazioni di robot per questi compiti obiettivo, anche se il pre-addestramento includeva dati di robot (comunicato, The Robot Report).
LiberAI afferma inoltre che, dopo lo stesso post-addestramento su robot, 10.000 ore di registrazioni dei guanti superano 2 milioni di ore di video umani dal web. Non sono forniti punteggi e i due articoli non ne parlano: un'affermazione della società, non verificata.
Limiti dichiarati da LiberAI
I guanti non registrano né contatto né forza, importanti per l'inserimento, il fissaggio e i materiali morbidi. Il solo video umano soffre di un divario di supervisione delle azioni e di un divario di incarnazione. Le prestazioni sui compiti difficili e di lunga durata restano limitate. Tatto, forza e raccolta in più case sono piste future.
Che cosa non è accertato?
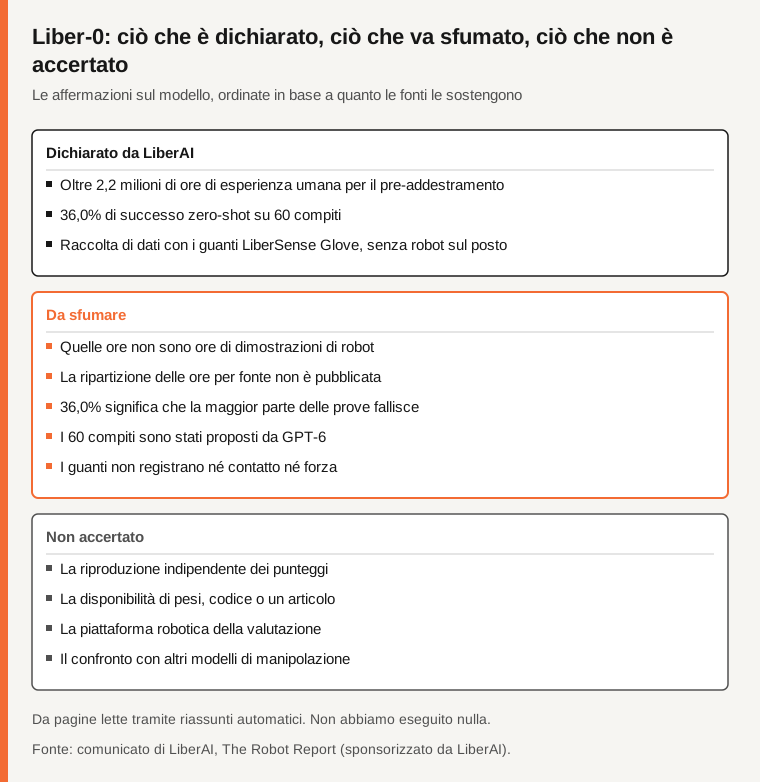
La ripartizione delle ore per fonte; la riproduzione indipendente del 36,0% e del confronto sui guanti; la piattaforma robotica della valutazione; qualsiasi pubblicazione di pesi, codice o accesso; come GPT-6 abbia scelto i compiti e quanto siano difficili; il confronto con altri modelli di manipolazione; il finanziamento e le dimensioni della società.
Fonte: comunicato di LiberAI, The Robot Report (sponsorizzato da LiberAI).
Tabella comparativa
| Punto | Che cosa dicono le fonti | Stato |
|---|---|---|
| Risultato | 36,0% su 60 compiti; 10,5% sui compiti difficili | Dichiarato dalla società |
| Ore | Oltre 2,2 milioni di ore, soprattutto video di attività umana | Dichiarato dalla società, ripartizione non pubblicata |
| Pubblicazione, riproduzione | Nessun peso, codice o articolo citato | Non accertato |
Domande frequenti
Queste ore di esperienza umana sono dimostrazioni di robot?
No. LiberAI precisa che la cifra non significa milioni di ore di dimostrazioni fatte a mano per i robot.
Che cosa significa 36,0%?
Il tasso complessivo di successo zero-shot di LiberAI su 600 prove: la maggior parte delle prove fallisce.
Il modello è disponibile?
Nessuna pagina letta cita pesi, codice, accesso aperto, prezzo o calendario, e non è nominato alcun articolo scientifico. Il comunicato cita un blog tecnico, video e una simulazione interattiva.
Metodo e limiti
Il 4 novembre 2026 abbiamo letto tramite riassunti automatici il comunicato di LiberAI del 3 novembre ripreso da Digital Media Net via ACCESS Newswire (la versione FinancialContent ha restituito un errore), The Robot Report, contenuto sponsorizzato da LiberAI, e Robotics & Automation News (Sam Francis). Non abbiamo letto il blog tecnico, i video, la simulazione né l'account X di LiberAI. I punteggi non sono riprodotti.
Fonti
- Comunicato di LiberAI via ACCESS Newswire, Digital Media Net, riassunto automatico
- The Robot Report, contenuto sponsorizzato da LiberAI, riassunto automatico
- Robotics & Automation News, Sam Francis, riassunto automatico
Avete notato un errore in questo articolo? Segnalatelo · La nostra politica sulle correzioni
