Analyse
'Dans DeepSeek V4.1-Flash : son cache KV, la mise à jour 1017 et la pile Harness'
Selon DeepSeek, V4.1-Flash garde un cache KV global environ quatre fois plus petit. Architecture, mise à jour 1017, prix, et ce qui n'est pas vérifié.
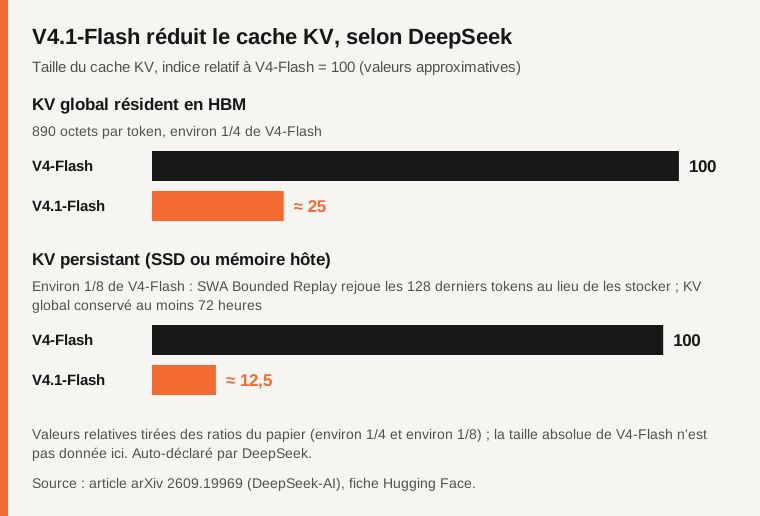
Au 2 novembre 2026, DeepSeek a publié V4.1-Flash (10 septembre), son article technique (17 septembre) et la mise à jour V4.1-Flash-1017 (17 octobre), ainsi qu'un cadre d'agent open source, DeepSeek Harness, et une API payante de recherche et de lecture web. Le cœur technique, selon DeepSeek, est un cache KV global de 890 octets par jeton, environ un quart de celui de V4-Flash. Tous les benchmarks ci-dessous viennent de DeepSeek ; nous n'avons trouvé aucun test indépendant et n'avons pas exécuté le modèle.
L'essentiel
- Ce qui est sorti : un modèle multimodal en mélange d'experts (Mixture of Experts) à poids ouverts (MIT), avec un contexte de 1 M de jetons, un article sur la compression du cache KV, une mise à jour 1017 sous le même identifiant d'API, et Harness.
- L'idée technique : la contrainte des agents est le cache KV et les charges riches en entrée, pas seulement la taille du modèle. DeepSeek réduit le cache en le partageant entre les couches et en le stockant en FP4.
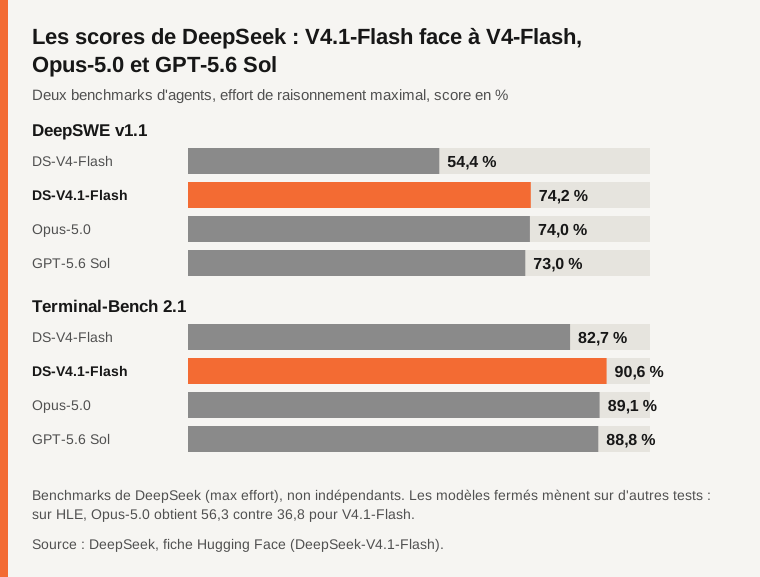
- Chiffres clés, selon DeepSeek : KV global environ 1/4 de celui de V4-Flash, KV persistant environ 1/8 ; 74,2 sur DeepSWE v1.1 et 90,6 sur Terminal-Bench 2.1 (77,0 sur DeepSWE après la 1017).
- Usage :
deepseek-flashà partir de 0,15 $ par million de jetons d'entrée sans cache en heures creuses (0,30 $ en heures pleines) ; poids sur Hugging Face et ModelScope. - Non vérifié : benchmarks indépendants, débit, latence et coût de service réels, et l'écart entre 552B et 763B de paramètres.
Qu'a sorti DeepSeek, et dans quel ordre ?
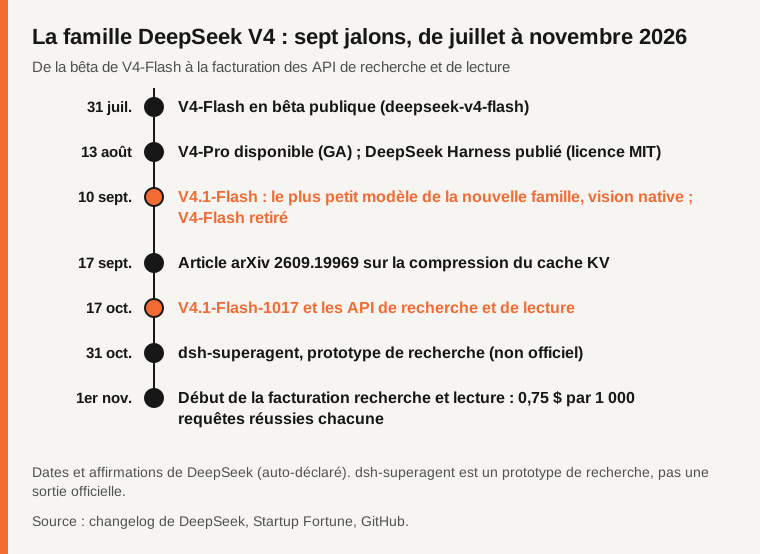
La séquence ci-dessous vient du changelog de l'API de DeepSeek, la date de lancement de Harness étant tirée de Startup Fortune.
Source : changelog de l'API DeepSeek, Startup Fortune, GitHub.
Le 10 septembre, DeepSeek a présenté V4.1-Flash comme le plus petit modèle de sa nouvelle famille d'architecture, avec compréhension native des images. V4-Flash et V4-Flash-Vision-Exp ont été retirés, et leurs noms redirigent vers lui. SiliconANGLE a rapporté une panne de l'API de près de cinq heures le 15 octobre. Un prototype de recherche, dsh-superagent, est apparu le 31 octobre ; il est non officiel et traité dans un autre article.
Comment l'architecture réduit-elle le cache KV ?
Pendant la génération, un transformeur conserve les clés et les valeurs (le cache KV) de chaque jeton précédent ; les contextes longs et les boucles d'agent qui relisent de grandes entrées sont donc limités par la mémoire du cache. DeepSeek s'y attaque à trois endroits.
Source : fiche Hugging Face, article arXiv (DeepSeek).
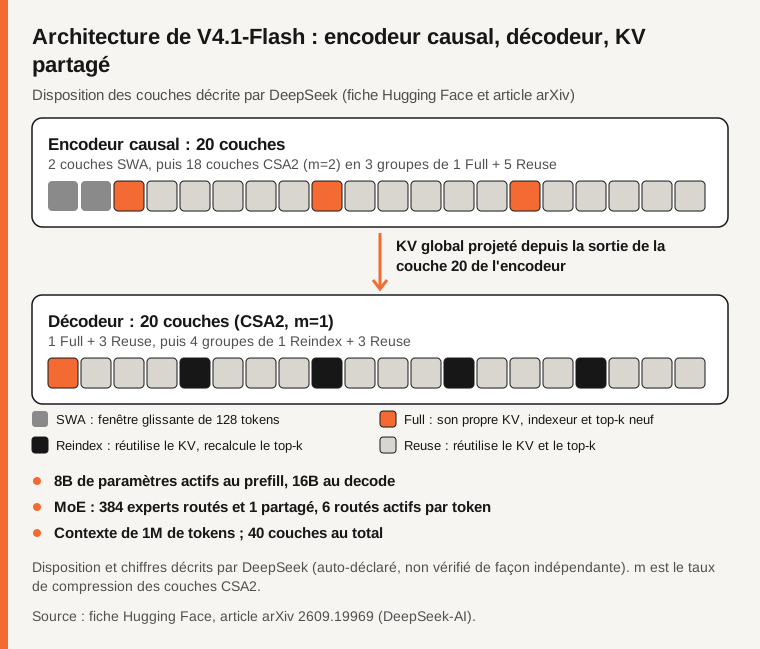
Causal Encoder-Decoder (CED). Les 40 couches (dimension cachée 5120) se répartissent entre un encodeur causal de 20 couches et un décodeur de 20 couches. Le KV global du décodeur est projeté depuis la sortie de la couche 20 de l'encodeur, avec des poids propres à chaque couche, au lieu d'être calculé depuis les états du décodeur. La plupart des jetons du prompt évitent donc le décodeur complet au prefill ; l'article chiffre l'économie à environ la moitié du calcul de prefill. C'est pourquoi 8B de paramètres sont actifs au prefill et 16B au decode. Le KV à fenêtre glissante du décodeur reste calculé par couche.
Compressed Sparse Attention 2 (CSA2). Chaque couche a un mode statique :
- Full : calcule son propre KV principal, ses requêtes et clés d'indexeur, et un top-k neuf.
- Reindex : réutilise le KV principal et les clés d'indexeur d'une couche antérieure, a sa propre requête d'indexeur et recalcule le top-k.
- Reuse : réutilise le KV principal et les indices top-k ; aucun indexeur.
Dans l'encodeur, les couches 1 et 2 sont en attention à fenêtre glissante (SWA) pure ; 18 couches CSA2 avec compression m=2 forment trois groupes de six (1 Full + 5 Reuse). Le décodeur compte 20 couches CSA2 avec m=1 : un groupe de 1 Full + 3 Reuse, puis quatre groupes de 1 Reindex + 3 Reuse. Le top-k vaut 512 et la fenêtre glissante 128 jetons. Un indexeur hiérarchique permet à la première couche Full de choisir 2 048 blocs de 8 positions (un pool de 16 384 positions), que seules les couches Reindex évaluent.
FP4 et SWA Bounded Replay.
- FP4 : le KV principal est stocké en FP4 (E2M1, une échelle E4M3 par 16 canaux, quantification après RoPE) ; le KV SWA reste en FP8. Cela divise à peu près par deux l'empreinte par rapport au FP8 de V4. L'article est incohérent sur le moment : l'introduction dit FP4 pendant l'entraînement, la section 2.4.4 le situe en QAT lors du post-entraînement.
- SWA Bounded Replay : le KV SWA n'est plus conservé mais reconstruit en rejouant les 128 derniers jetons. Le KV global est garanti au moins 72 heures ; le KV SWA vit en DRAM hôte quelques minutes.
Source : article arXiv, fiche Hugging Face. Valeurs relatives, d'après les ratios de l'article.
Le reste de la pile, selon DeepSeek :
- MoE : 1 expert partagé plus 384 experts routés, 6 routés actifs par jeton, dimension intermédiaire 2 304, SwiGLU.
- Engram : mémoire conditionnelle éparse, 196B de paramètres en deux modules (couches 1 et 14).
- DSpark : décodage spéculatif avec un drafter de 3 blocs prédisant 5 positions en parallèle. La partie de l'article que nous avons lue ne donne ni taux d'acceptation ni gain de vitesse.
La seule affirmation quantitative d'efficacité de l'article est que le FLOPs de decode croît d'environ un quart quand le contexte passe de 4K à 1M. Les parties lues ne donnent ni décomposition des 890 octets, ni débit, ni latence, ni ablations.
Que mesure DeepSeek, et contre qui ?
L'entraînement a utilisé 45 T de jetons (texte contre multimodal à 7:1), avec un contexte étendu à 1M à 34 T de jetons. Le post-entraînement enchaîne SFT, RL, puis distillation sur politique ; la fiche attribue les gains à la chaîne de données (tâches d'agents et environnements synthétisés), pas à un nouvel algorithme.
Source : fiche Hugging Face. Benchmarks de DeepSeek, non indépendants.
Le tableau de DeepSeek compare aussi avec Opus-5.0 (Anthropic) et GPT-5.6 Sol ; nous rapportons les chiffres tels que publiés. Selon DeepSeek, V4.1-Flash obtient 90,9 sur GPQA Diamond (Opus-5.0 93,4, GPT-5.6 Sol 94,1), 30,0 sur Terminal-Bench 3.0 (43,3 et 34,4) et 36,8 sur HLE (56,3 et 44,5 ; les sous-ensembles texte seul sont signalés à part). Il annonce 88,1 sur CyberGym (GPT-5.6 Sol 84,5) et 54,8 sur AutomationBench (50,3 et 45,8). Ainsi, d'après le tableau de DeepSeek lui-même, les modèles fermés restent devant sur plusieurs tests (HLE, Terminal-Bench 3.0, certains tests visuels comme ZeroBench, 49,0 contre 53,0 pour GPT-5.6 Sol). SiliconANGLE compte Opus-5.0 en tête sur 7 des 11 benchmarks publiés pour la mise à jour.
Modèles de base, d'après la fiche :
| Benchmark | V4-Flash-Base | V4-Pro-Base | V4.1-Flash-Base |
|---|---|---|---|
| MMLU-Pro | 68,3 | 73,5 | 74,1 |
| HumanEval | 69,5 | 76,8 | 79,4 |
| SimpleQA-Verified | 30,1 | 55,2 | 42,3 |
| MATH | 57,4 | 64,5 | 61,1 |
| LongBench-V2 | 44,7 | 51,5 | 45,2 |
V4-Pro-Base compte 1,6 T de paramètres et reste devant V4.1-Flash-Base sur SimpleQA-Verified, MATH et LongBench-V2.
Que change la mise à jour 1017 ?
V4.1-Flash-1017 garde l'identifiant deepseek-flash et les mêmes prix. DeepSeek annonce des gains de septembre à la 1017 : HLE sans outils de 36,8 à 42,6 (44,0 sur texte seul), DeepSWE v1.1 de 74,2 à 77,0 et Terminal-Bench 4.0 de 31,2 à 42,3.
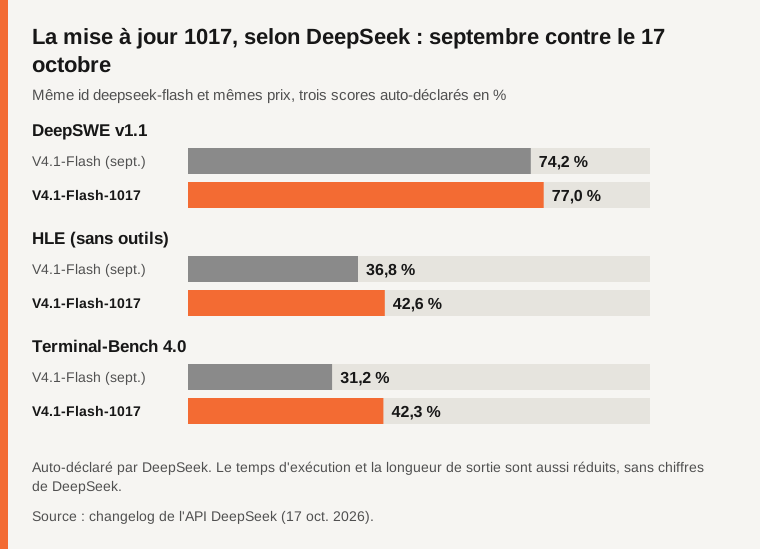
Source : changelog de l'API DeepSeek (17 octobre 2026). Auto-déclaré.
Le temps d'exécution et la longueur de sortie ont aussi été réduits, sans chiffres. Harness 0.2.1-rc.1 ou plus récent est recommandé, et SiliconANGLE indique que le modèle a été optimisé pour Harness et pour CodeBuddy et WorkBuddy de Tencent. DeepSeek parle d'une amélioration de Pareto en performance et en coût ; Startup Fortune note que c'est le jugement de DeepSeek lui-même et que le calendrier favorise sa pile maison, même si la licence MIT permet à d'autres d'utiliser le modèle dans des outils concurrents. Neomanex note qu'aucune version figée n'est annoncée : refaites vos évaluations, car des sorties plus courtes peuvent casser des parsers et des budgets de jetons.
Que coûte le raisonnement, et comment le régler ?
L'effort de raisonnement se règle de 1 à 100 ; dans l'API, max vaut 100, high 75 et low 50, et les résultats « instruct » utilisent 100.
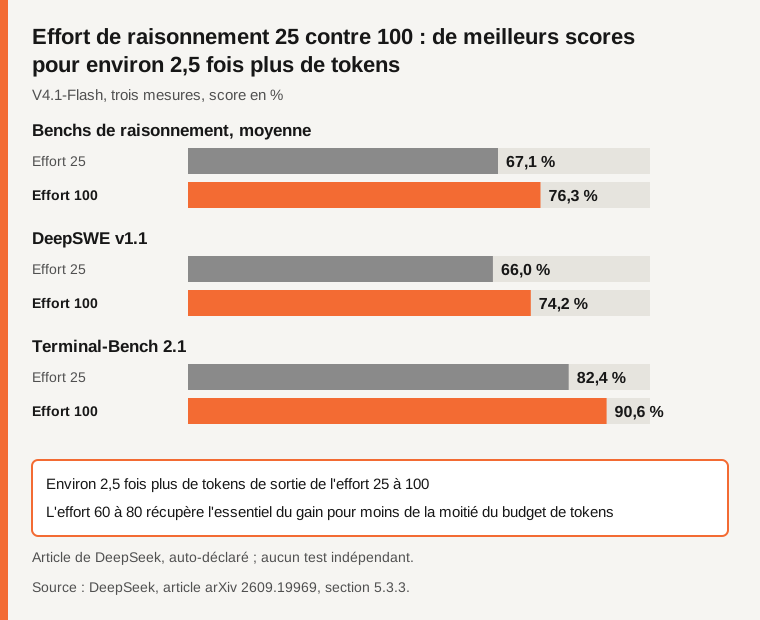
Source : article arXiv, section 5.3.3. Auto-déclaré.
Passer de l'effort 25 à 100 coûte environ 2,5 fois plus de jetons de sortie ; des efforts de 60 à 80 captent l'essentiel du gain pour moins de la moitié des jetons. L'échafaudage compte aussi (DeepSWE v1.1 / Terminal-Bench 2.1, d'après la fiche) : mini-SWE 74,2 / 90,3, DSH Minimal 72,6 / 90,6, DSH Standard 70,5 / 85,8 ; les autres harnais (Claude Code, Codex, OpenCode, Pi) obtiennent 65,5 à 69,8 sur DeepSWE, et Terminal-Bench 2.1 va de 84,1 (Codex) à 90,6. Avec plusieurs agents, l'article rapporte un ProgramBench Almost@1 de 30,04 % à 8 heures contre 20,39 % pour un seul agent.
Combien ça coûte et comment l'utiliser ?
deepseek-flash est V4.1-Flash-1017 ; deepseek-v4-pro est V4-Pro-0813. Les anciens noms redirigent vers Flash aux prix de Flash. Les deux offrent un contexte de 1 M, une sortie maximale de 384 K, des modes réflexion et non-réflexion, JSON, appels d'outils, l'API Responses et une API compatible Anthropic ; la vision n'existe que sur Flash.
| Prix par million de jetons | Flash creuses | Flash pleines | Pro creuses | Pro pleines |
|---|---|---|---|---|
| Entrée, cache hit | 0,003 $ | 0,006 $ | 0,022 $ | 0,044 $ |
| Entrée, cache miss | 0,15 $ | 0,30 $ | 0,66 $ | 1,32 $ |
| Sortie | 0,60 $ | 1,20 $ | 1,98 $ | 3,96 $ |
Les heures pleines sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC, du lundi au vendredi hors jours fériés chinois ; le reste est creux.
- API de recherche et de lecture : 0,75 $ par 1 000 requêtes réussies pour chacune, gratuites jusqu'au 1er novembre et facturées à la requête à partir de 00:00 heure de Pékin le 1er novembre 2026. La recherche renvoie jusqu'à 50 résultats classés ; Fetch convertit une page en Markdown (SiliconANGLE). Elle peut être appelée côté serveur via Harness, Claude Code ou Codex.
- DeepSeek Harness : cadre d'agent open source officiel (
dsh, MIT), où tout est plugin (adaptateurs de modèles, outils, journaux, boucles d'agent), avec une interface web ; dépôt github.com/deepseek-ai/deepseek-harness. Le nombre d'étoiles rapporté diverge selon les sources (Startup Fortune, HelloGitHub), donc nous n'en donnons aucun. - L'exécuter soi-même :
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash"(compatible OpenAI, entrée image) oupython3 -m sglang.launch_server --model-path "deepseek-ai/DeepSeek-V4.1-Flash", ou Transformers avecdevice_map="auto". Il n'y a pas de modèle de chat Jinja : utilisez l'implémentation de référence en Python du dossierencoding, ou la bibliothèque Rustdeepseek-recipeen production. La fiche ne donne aucune configuration matérielle minimale.
Qu'est-ce qui n'est pas établi ?
Nous n'avons trouvé aucun test indépendant, et les comparaisons avec Opus-5.0 et GPT-5.6 Sol sont celles de DeepSeek. La fiche et l'article parlent de 552B de paramètres de backbone, alors que les métadonnées Safetensors indiquent 763B ; peut-être les 196B d'Engram ou l'encodeur visuel, mais ce n'est pas confirmé. Le débit, la latence et le coût de service réels ne sont pas publiés, les ablations ne sont pas chiffrées, le gain réel de DSpark est inconnu et le matériel minimal n'est pas indiqué. Nous n'avons pas mesuré l'effet de la 1017 sur les sorties longues.
Tableau récapitulatif
| Point | Ce que disent les sources au 2 novembre 2026 | Source |
|---|---|---|
| Modèle | MoE multimodal, MIT, contexte 1 M, 8B actifs au prefill / 16B au decode | Hugging Face, arXiv |
| Taille | 552B de backbone dans le texte ; 763B dans les métadonnées, sans explication | Hugging Face |
| KV global | 890 octets par jeton, environ 1/4 de V4-Flash | arXiv |
| KV persistant | Environ 1/8 de V4-Flash, via SWA Bounded Replay | arXiv |
| Benchmarks | DeepSWE 74,2 (77,0 en 1017), Terminal-Bench 2.1 90,6 ; auto-déclarés | Hugging Face, changelog |
| Prix | Flash 0,15 $ / 0,60 $ en creuses, 0,30 $ / 1,20 $ en pleines (cache miss / sortie) | Tarifs DeepSeek |
| Tests indépendants | Aucun trouvé | s. o. |
Questions fréquentes
Le modèle est-il vraiment 4 fois plus léger ?
Non. Selon DeepSeek, c'est le cache KV global en HBM qui représente environ un quart de celui de V4-Flash (890 octets par jeton), pas le modèle. Le texte parle de 552B de paramètres et les métadonnées de 763B, sans explication.
Peut-on l'exécuter soi-même ?
Les poids sont MIT et la fiche documente vLLM, SGLang et Transformers. Elle n'indique aucun matériel minimal, donc nous ne pouvons pas dire ce qu'il faut.
La mise à jour 1017 change-t-elle le prix ou l'identifiant ?
Non. L'identifiant reste deepseek-flash et les prix sont identiques. Aucune version figée n'est annoncée : refaites vos évaluations.
DeepSeek bat-il les modèles fermés ?
Selon DeepSeek, il est devant sur certains tests d'agents et derrière sur d'autres (HLE, Terminal-Bench 3.0, certains tests visuels). Il n'existe aucun test indépendant.
Méthode et limites
Nous avons lu la fiche Hugging Face (via un résumé automatique, donc les chiffres sont à recouper), environ deux tiers de l'article arXiv, le changelog et la page de prix de DeepSeek, ainsi que des sources secondaires de qualité inégale (Neomanex, HelloGitHub). Nous n'avons pas testé le modèle et n'avons trouvé dans l'article ni ablation ni mesure de débit. Ce n'est ni un conseil d'achat ni un conseil d'investissement.
Sources
- Hugging Face : fiche du modèle DeepSeek-V4.1-Flash (vérifié le 2026-11-02)
- arXiv 2609.19969 : DeepSeek-V4.1-Flash, Pushing the Limits of KV Cache Compression (vérifié le 2026-11-02)
- API DeepSeek : mises à jour (changelog) (vérifié le 2026-11-02)
- API DeepSeek : modèles et tarifs (vérifié le 2026-11-02)
- SiliconANGLE : DeepSeek publie une version mise à jour de V4.1-Flash (vérifié le 2026-11-02)
- Startup Fortune : DeepSeek lie son nouveau modèle V4.1-Flash-1017 plus étroitement à son propre Harness (vérifié le 2026-11-02)
- Neomanex : DeepSeek V4.1-Flash-1017, même identifiant Flash, même prix (vérifié le 2026-11-02)
- HelloGitHub : deepseek-harness (vérifié le 2026-11-02)
Une erreur dans cet article ? Signalez-la · Notre politique de corrections
