Analyse
'Einblick in DeepSeek V4.1-Flash: der KV-Cache, das Update 1017 und der Harness-Stack'
Laut DeepSeek ist der globale KV-Cache von V4.1-Flash etwa 1/4 so groß wie bei V4-Flash. Wie, was 1017 ändert, was es kostet und was nicht belegt ist.
Stand 2. November 2026 hat DeepSeek V4.1-Flash veröffentlicht (10. September), sein technisches Paper vorgelegt (17. September) und das Modell auf V4.1-Flash-1017 aktualisiert (17. Oktober), dazu ein quelloffenes Agenten-Framework, DeepSeek Harness, und eine kostenpflichtige API für Websuche und Seitenabruf. Der technische Kern ist laut DeepSeek ein globaler KV-Cache von 890 Byte pro Token, etwa ein Viertel von V4-Flash. Alle Benchmarks unten stammen von DeepSeek selbst; wir fanden keinen unabhängigen Test und haben das Modell nicht ausgeführt.
Das Wesentliche
- Was erschienen ist: ein multimodales Mixture-of-Experts-Modell mit offenen Gewichten (MIT) und 1M Token Kontext, ein Paper zur KV-Cache-Kompression, ein Update 1017 unter derselben API-ID und Harness.
- Die technische Idee: Der Engpass für Agenten ist der KV-Cache und eingabelastige Workloads, nicht nur die Modellgröße. DeepSeek verkleinert den Cache, indem er ihn über Schichten hinweg teilt und in FP4 speichert.
- Kennzahlen laut DeepSeek: globaler KV etwa 1/4 von V4-Flash, persistenter KV etwa 1/8; 74,2 bei DeepSWE v1.1 und 90,6 bei Terminal-Bench 2.1 (77,0 bei DeepSWE nach 1017).
- Nutzung:
deepseek-flashab 0,15 $ pro Million Eingabe-Token ohne Cache-Treffer außerhalb der Stoßzeiten (0,30 $ zu Stoßzeiten); Gewichte auf Hugging Face und ModelScope. - Nicht überprüft: unabhängige Benchmarks, tatsächlicher Durchsatz, Latenz und Betriebskosten sowie der Unterschied zwischen 552B und 763B Parametern.
Was hat DeepSeek veröffentlicht, und in welcher Reihenfolge?
Die Abfolge unten stammt aus dem API-Changelog von DeepSeek; das Startdatum von Harness stammt von Startup Fortune.
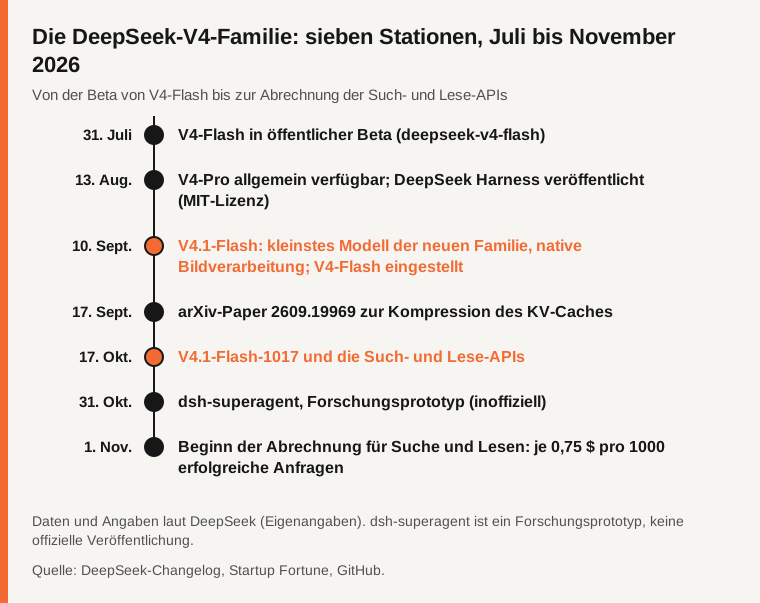
Quelle: DeepSeek-API-Changelog, Startup Fortune, GitHub.
Am 10. September nannte DeepSeek V4.1-Flash das kleinste Modell seiner neuen Architekturfamilie, mit nativem Bildverständnis. V4-Flash und V4-Flash-Vision-Exp wurden eingestellt, ihre Namen leiten auf V4.1-Flash weiter. SiliconANGLE berichtete von einem API-Ausfall von fast fünf Stunden am 15. Oktober. Am 31. Oktober tauchte ein Forschungsprototyp namens dsh-superagent auf; er ist inoffiziell und wird in einem anderen Artikel behandelt.
Wie verkleinert die Architektur den KV-Cache?
Bei der Generierung speichert ein Transformer Schlüssel und Werte (den KV-Cache) jedes früheren Tokens; lange Kontexte und Agentenschleifen, die große Eingaben erneut lesen, werden daher vom Cache-Speicher begrenzt. DeepSeek setzt an drei Stellen an.
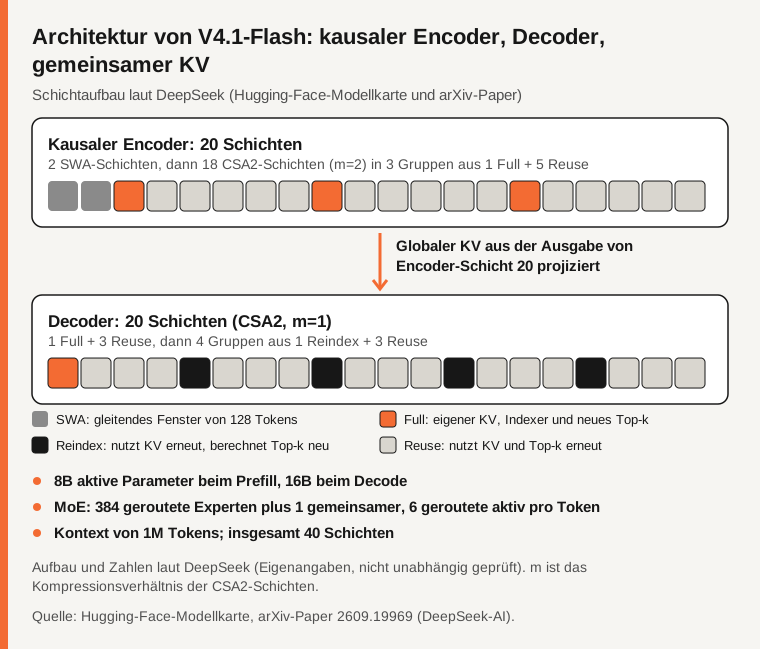
Quelle: Hugging-Face-Modellkarte, arXiv-Paper (DeepSeek).
Causal Encoder-Decoder (CED). Die 40 Schichten (versteckte Größe 5120) teilen sich in einen kausalen Encoder mit 20 Schichten und einen Decoder mit 20 Schichten. Der globale KV des Decoders wird aus der Ausgabe von Encoder-Schicht 20 projiziert, mit eigenen Gewichten pro Schicht, statt aus den Decoder-Zuständen berechnet zu werden. Die meisten Prompt-Token überspringen daher beim Prefill den vollen Decoder; das Paper beziffert die Ersparnis auf rund die Hälfte der Prefill-Rechenlast. Deshalb sind beim Prefill 8B Parameter aktiv und beim Decode 16B. Der Sliding-Window-KV des Decoders wird weiterhin pro Schicht berechnet.
Compressed Sparse Attention 2 (CSA2). Jede Schicht hat einen statischen Modus:
- Full: berechnet ihren eigenen Haupt-KV, Indexer-Queries und -Keys sowie ein neues Top-k.
- Reindex: nutzt den Haupt-KV und die Indexer-Keys einer früheren Schicht wieder, hat eine eigene Indexer-Query und berechnet das Top-k neu.
- Reuse: nutzt den Haupt-KV und die Top-k-Indizes wieder; gar kein Indexer.
Im Encoder sind die Schichten 1 und 2 reine Sliding-Window-Attention (SWA); 18 CSA2-Schichten mit Kompression m=2 bilden drei Gruppen zu sechs (1 Full + 5 Reuse). Der Decoder hat 20 CSA2-Schichten mit m=1: eine Gruppe aus 1 Full + 3 Reuse, dann vier Gruppen aus 1 Reindex + 3 Reuse. Top-k ist 512, das gleitende Fenster umfasst 128 Token. Ein hierarchischer Indexer lässt die erste Full-Schicht 2.048 Blöcke zu je 8 Positionen auswählen (ein Pool von 16.384 Positionen), die nur die Reindex-Schichten bewerten.
FP4 und SWA Bounded Replay.
- FP4: Der Haupt-KV wird in FP4 gespeichert (E2M1, eine E4M3-Skala pro 16 Kanäle, nach RoPE quantisiert); der SWA-KV bleibt FP8. Das halbiert den Platzbedarf grob gegenüber dem FP8 von V4. Zum Zeitpunkt ist das Paper widersprüchlich: Die Einleitung nennt FP4 während des Trainings, Abschnitt 2.4.4 verortet es im QAT des Post-Trainings.
- SWA Bounded Replay: Der SWA-KV wird nicht mehr persistent gespeichert, sondern durch Wiedergabe der letzten 128 Token rekonstruiert. Der globale KV ist mindestens 72 Stunden garantiert; der SWA-KV lebt einige Minuten im Host-DRAM.
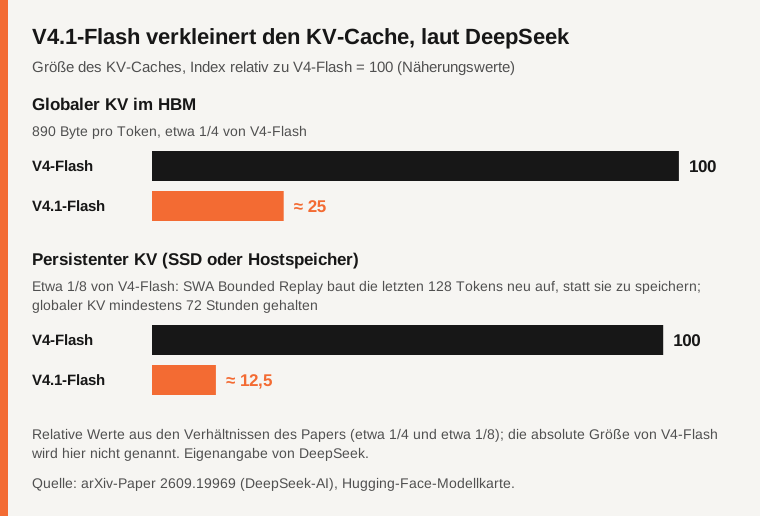
Quelle: arXiv-Paper, Hugging-Face-Modellkarte. Die Werte sind relativ, aus den Verhältnissen des Papers.
Der Rest des Stacks laut DeepSeek:
- MoE: 1 gemeinsamer plus 384 geroutete Experten, 6 geroutete aktiv pro Token, Zwischengröße 2.304, SwiGLU.
- Engram: spärlicher bedingter Speicher, 196B Parameter in zwei Modulen (Schichten 1 und 14).
- DSpark: spekulatives Decoding mit einem Drafter aus 3 Blöcken, der 5 Positionen parallel vorhersagt. Der von uns gelesene Teil des Papers nennt weder Akzeptanzrate noch Beschleunigung.
Die einzige quantitative Effizienzaussage des Papers lautet, dass die Decode-FLOPs um etwa ein Viertel wachsen, wenn der Kontext von 4K auf 1M steigt. In den gelesenen Teilen gibt es keine Aufschlüsselung der 890 Byte, keinen Durchsatz, keine Latenz und keine Ablationen.
Was misst DeepSeek, und gegen wen?
Das Training nutzte 45T Token (Text zu multimodal 7:1), mit auf 1M erweitertem Kontext bei 34T Token. Das Post-Training läuft über SFT, RL und danach On-Policy-Destillation; die Modellkarte führt die Gewinne auf die Datenpipeline zurück (synthetisierte Agentenaufgaben und -umgebungen), nicht auf einen neuen Algorithmus.
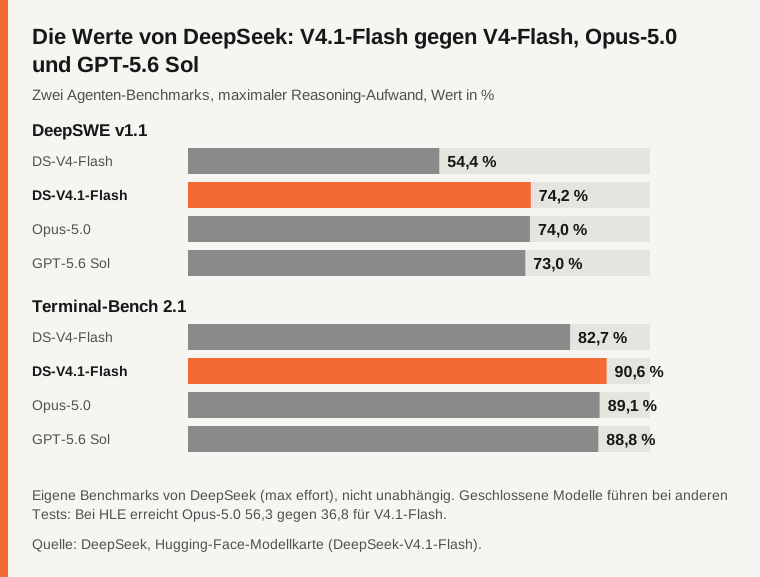
Quelle: Hugging-Face-Modellkarte. Benchmarks von DeepSeek, nicht unabhängig.
DeepSeeks Tabelle vergleicht auch mit Opus-5.0 (Anthropic) und GPT-5.6 Sol; wir geben die Zahlen wie veröffentlicht wieder. Laut DeepSeek erreicht V4.1-Flash 90,9 bei GPQA Diamond (Opus-5.0 93,4, GPT-5.6 Sol 94,1), 30,0 bei Terminal-Bench 3.0 (43,3 und 34,4) und 36,8 bei HLE (56,3 und 44,5; reine Textteilmengen sind gesondert gekennzeichnet). Es meldet 88,1 bei CyberGym (GPT-5.6 Sol 84,5) und 54,8 bei AutomationBench (50,3 und 45,8). Laut DeepSeeks eigener Tabelle bleiben die geschlossenen Modelle bei mehreren Tests also vorn (HLE, Terminal-Bench 3.0, einige visuelle wie ZeroBench, 49,0 gegenüber 53,0 für GPT-5.6 Sol). SiliconANGLE zählt Opus-5.0 bei 7 der 11 für das Update veröffentlichten Benchmarks vorn.
Basismodelle laut Modellkarte:
| Benchmark | V4-Flash-Base | V4-Pro-Base | V4.1-Flash-Base |
|---|---|---|---|
| MMLU-Pro | 68,3 | 73,5 | 74,1 |
| HumanEval | 69,5 | 76,8 | 79,4 |
| SimpleQA-Verified | 30,1 | 55,2 | 42,3 |
| MATH | 57,4 | 64,5 | 61,1 |
| LongBench-V2 | 44,7 | 51,5 | 45,2 |
V4-Pro-Base hat 1,6T Parameter und liegt bei SimpleQA-Verified, MATH und LongBench-V2 vor V4.1-Flash-Base.
Was ändert das Update 1017?
V4.1-Flash-1017 behält die ID deepseek-flash und dieselben Preise. DeepSeek meldet Verbesserungen von September bis 1017: HLE ohne Werkzeuge von 36,8 auf 42,6 (44,0 nur Text), DeepSWE v1.1 von 74,2 auf 77,0 und Terminal-Bench 4.0 von 31,2 auf 42,3.
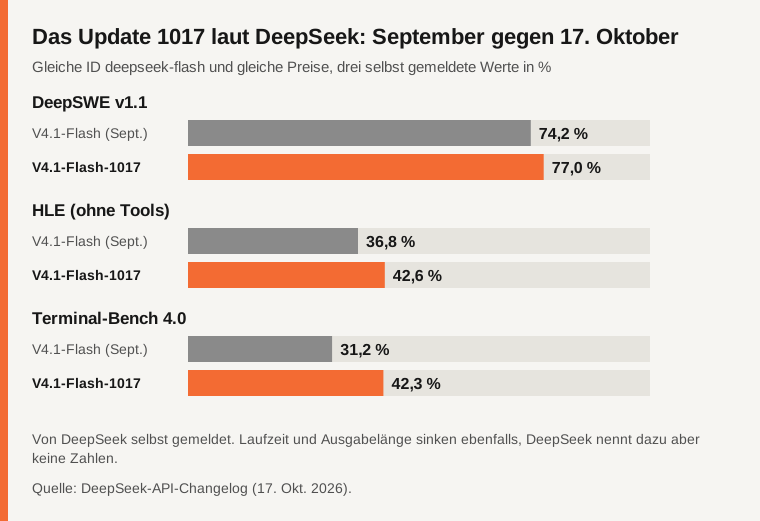
Quelle: DeepSeek-API-Changelog (17. Oktober 2026). Selbst berichtet.
Auch Laufzeit und Ausgabelänge wurden verringert, ohne Zahlen. Empfohlen wird Harness 0.2.1-rc.1 oder neuer, und laut SiliconANGLE wurde das Modell auf Harness sowie auf Tencents CodeBuddy und WorkBuddy abgestimmt. DeepSeek nennt die Veröffentlichung eine Pareto-Verbesserung bei Leistung und Kosten; Startup Fortune merkt an, dass dies DeepSeeks eigene Einschätzung ist und der Zeitpunkt den hauseigenen Stack begünstigt, auch wenn die MIT-Lizenz anderen erlaubt, das Modell in konkurrierenden Werkzeugen zu nutzen. Neomanex weist darauf hin, dass keine festgeschriebene Version angekündigt ist: Wiederholen Sie Ihre Auswertungen, denn kürzere Ausgaben können Parser und Token-Budgets brechen.
Was kostet das Schlussfolgern, und wie stellt man es ein?
Der Schlussfolgerungsaufwand ist von 1 bis 100 einstellbar; in der API ist max gleich 100, high gleich 75 und low gleich 50, und die Instruct-Ergebnisse verwenden 100.
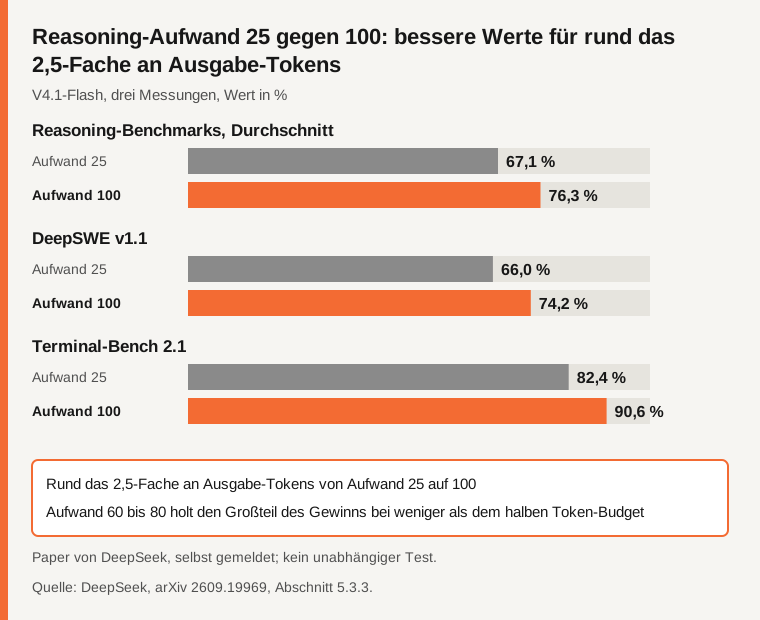
Quelle: arXiv-Paper, Abschnitt 5.3.3. Selbst berichtet.
Von Aufwand 25 auf 100 zu gehen kostet etwa 2,5-mal mehr Ausgabe-Token; Aufwände von 60 bis 80 erfassen den Großteil des Gewinns mit weniger als der Hälfte der Token. Auch das Gerüst spielt eine Rolle (DeepSWE v1.1 / Terminal-Bench 2.1, laut Modellkarte): mini-SWE 74,2 / 90,3, DSH Minimal 72,6 / 90,6, DSH Standard 70,5 / 85,8; andere Harnesses (Claude Code, Codex, OpenCode, Pi) erreichen 65,5 bis 69,8 bei DeepSWE, und Terminal-Bench 2.1 reicht von 84,1 (Codex) bis 90,6. Mit mehreren Agenten meldet das Paper ein ProgramBench Almost@1 von 30,04% nach 8 Stunden gegenüber 20,39% für einen einzelnen Agenten.
Was kostet es, und wie nutzt man es?
deepseek-flash ist V4.1-Flash-1017; deepseek-v4-pro ist V4-Pro-0813. Alte Namen leiten zu Flash-Preisen auf Flash weiter. Beide bieten 1M Kontext, 384K maximale Ausgabe, Denk- und Nicht-Denk-Modus, JSON, Werkzeugaufrufe, die Responses-API und eine Anthropic-kompatible API; Vision gibt es nur bei Flash.
| Preis pro Million Token | Flash außerhalb der Stoßzeiten | Flash Stoßzeiten | Pro außerhalb der Stoßzeiten | Pro Stoßzeiten |
|---|---|---|---|---|
| Eingabe, Cache-Treffer | 0,003 $ | 0,006 $ | 0,022 $ | 0,044 $ |
| Eingabe, Cache-Fehlgriff | 0,15 $ | 0,30 $ | 0,66 $ | 1,32 $ |
| Ausgabe | 0,60 $ | 1,20 $ | 1,98 $ | 3,96 $ |
Stoßzeiten sind 01:00 bis 04:00 und 06:00 bis 10:00 UTC, Montag bis Freitag ohne chinesische Feiertage; der Rest zählt als außerhalb der Stoßzeiten.
- Such- und Abruf-API: 0,75 $ pro 1.000 erfolgreiche Anfragen je Dienst, kostenlos bis zum 1. November und ab 00:00 Uhr Pekinger Zeit am 1. November 2026 pro Anfrage abgerechnet. Die Suche liefert bis zu 50 gerankte Ergebnisse; Fetch wandelt eine Seite in Markdown um (SiliconANGLE). Sie kann serverseitig über Harness, Claude Code oder Codex aufgerufen werden.
- DeepSeek Harness: offizielles quelloffenes Agenten-Framework (
dsh, MIT), alles ist ein Plugin (Modelladapter, Werkzeuge, Protokolle, Agentenschleifen), mit Weboberfläche; Repository github.com/deepseek-ai/deepseek-harness. Die gemeldeten Sternezahlen weichen zwischen den Quellen ab (Startup Fortune, HelloGitHub), daher nennen wir keine. - Selbst ausführen:
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash"(OpenAI-kompatibel, Bildeingabe) oderpython3 -m sglang.launch_server --model-path "deepseek-ai/DeepSeek-V4.1-Flash", oder Transformers mitdevice_map="auto". Es gibt keine Jinja-Chatvorlage: Nutzen Sie das Referenz-Python im Ordnerencodingoder in der Produktion die Rust-Bibliothekdeepseek-recipe. Die Modellkarte nennt keine Mindesthardware.
Was ist nicht belegt?
Einen unabhängigen Test, den wir finden konnten, gibt es nicht, und die Vergleiche mit Opus-5.0 und GPT-5.6 Sol stammen von DeepSeek. Modellkarte und Paper nennen 552B Backbone-Parameter, die Safetensors-Metadaten dagegen 763B; vielleicht die 196B von Engram oder der Vision-Encoder, aber das ist nicht bestätigt. Realer Durchsatz, Latenz und Betriebskosten sind unveröffentlicht, Ablationen sind nicht beziffert, der tatsächliche Gewinn von DSpark ist unbekannt und die Mindesthardware ist nicht angegeben. Wir haben den Effekt von 1017 auf lange Ausgaben nicht gemessen.
Vergleichstabelle
| Punkt | Was die Quellen am 2. Nov. 2026 sagen | Quelle |
|---|---|---|
| Modell | Multimodales MoE, MIT, 1M Kontext, 8B aktiv beim Prefill / 16B beim Decode | Hugging Face, arXiv |
| Größe | 552B Backbone im Text; 763B in den Metadaten, unerklärt | Hugging Face |
| Globaler KV | 890 Byte pro Token, etwa 1/4 von V4-Flash | arXiv |
| Persistenter KV | Etwa 1/8 von V4-Flash, über SWA Bounded Replay | arXiv |
| Benchmarks | DeepSWE 74,2 (77,0 in 1017), Terminal-Bench 2.1 90,6; selbst berichtet | Hugging Face, Changelog |
| Preis | Flash 0,15 $ / 0,60 $ außerhalb der Stoßzeiten, 0,30 $ / 1,20 $ zu Stoßzeiten (Cache-Fehlgriff / Ausgabe) | DeepSeek-Preise |
| Unabhängige Tests | Keine gefunden | k. A. |
Häufige Fragen
Ist das Modell wirklich 4-mal leichter?
Nein. Laut DeepSeek ist es der globale KV-Cache im HBM, der etwa ein Viertel von V4-Flash beträgt (890 Byte pro Token), nicht das Modell. Der Text nennt 552B Parameter, die Metadaten 763B, ohne Erklärung.
Kann ich es selbst ausführen?
Die Gewichte stehen unter MIT, und die Modellkarte dokumentiert vLLM, SGLang und Transformers. Sie nennt keine Mindesthardware, daher können wir nicht sagen, was Sie brauchen.
Ändert das Update 1017 Preis oder ID?
Nein. Die ID bleibt deepseek-flash, und die Preise sind identisch. Eine festgeschriebene Version ist nicht angekündigt, wiederholen Sie also Ihre Auswertungen.
Schlägt DeepSeek die geschlossenen Modelle?
Laut DeepSeek liegt es bei einigen Agententests vorn und bei anderen hinten (HLE, Terminal-Bench 3.0, einige visuelle Tests). Es gibt keinen unabhängigen Test.
Methode und Grenzen
Wir haben die Hugging-Face-Modellkarte gelesen (über eine automatische Zusammenfassung, die Zahlen sollten daher gegengeprüft werden), etwa zwei Drittel des arXiv-Papers, den Changelog und die Preisseite von DeepSeek sowie Sekundärquellen von ungleicher Qualität (Neomanex, HelloGitHub). Wir haben das Modell nicht getestet und im Paper weder Ablationen noch Durchsatzmessungen gefunden. Dies ist keine Kauf- oder Anlageberatung.
Quellen
- Hugging Face: Modellkarte DeepSeek-V4.1-Flash (geprüft am 02.11.2026)
- arXiv 2609.19969: DeepSeek-V4.1-Flash, Pushing the Limits of KV Cache Compression (geprüft am 02.11.2026)
- DeepSeek API: Updates (Changelog) (geprüft am 02.11.2026)
- DeepSeek API: Modelle und Preise (geprüft am 02.11.2026)
- SiliconANGLE: DeepSeek veröffentlicht aktualisiertes Modell V4.1-Flash (geprüft am 02.11.2026)
- Startup Fortune: DeepSeek bindet sein neues Modell V4.1-Flash-1017 enger an den eigenen Harness (geprüft am 02.11.2026)
- Neomanex: DeepSeek V4.1-Flash-1017, gleiche Flash-ID, gleicher Preis (geprüft am 02.11.2026)
- HelloGitHub: deepseek-harness (geprüft am 02.11.2026)
Einen Fehler in diesem Artikel entdeckt? Melden Sie ihn · Unsere Korrekturrichtlinie
