Análisis
'Por dentro de DeepSeek V4.1-Flash: su caché KV, la actualización 1017 y la pila Harness'
Según DeepSeek, V4.1-Flash tiene un caché KV global unas cuatro veces menor. Arquitectura, actualización 1017, precios y lo que nadie ha verificado.
Al 2 de noviembre de 2026, DeepSeek ha publicado V4.1-Flash (10 de septiembre), su artículo técnico (17 de septiembre) y la actualización V4.1-Flash-1017 (17 de octubre), además de un marco de agentes de código abierto, DeepSeek Harness, y una API de pago de búsqueda y lectura web. El núcleo técnico, según DeepSeek, es un caché KV global de 890 bytes por token, aproximadamente una cuarta parte del de V4-Flash. Todos los benchmarks de abajo son de DeepSeek; no hemos encontrado ninguna prueba independiente y no hemos ejecutado el modelo.
Lo esencial
- Qué ha salido: un modelo multimodal de mezcla de expertos (Mixture of Experts) con pesos abiertos (MIT), con un contexto de 1 M de tokens, un artículo sobre compresión del caché KV, una actualización 1017 con el mismo identificador de API y Harness.
- La idea técnica: la restricción de los agentes es el caché KV y las cargas con mucha entrada, no solo el tamaño del modelo. DeepSeek reduce el caché compartiéndolo entre capas y almacenándolo en FP4.
- Cifras clave, según DeepSeek: KV global alrededor de 1/4 del de V4-Flash, KV persistente alrededor de 1/8; 74,2 en DeepSWE v1.1 y 90,6 en Terminal-Bench 2.1 (77,0 en DeepSWE tras la 1017).
- Uso:
deepseek-flashdesde 0,15 $ por millón de tokens de entrada sin caché en horas valle (0,30 $ en horas punta); pesos en Hugging Face y ModelScope. - Sin verificar: benchmarks independientes, rendimiento, latencia y coste de servicio reales, y la diferencia entre 552B y 763B de parámetros.
¿Qué lanzó DeepSeek y en qué orden?
La secuencia de abajo procede del registro de cambios de la API de DeepSeek; la fecha de lanzamiento de Harness se toma de Startup Fortune.
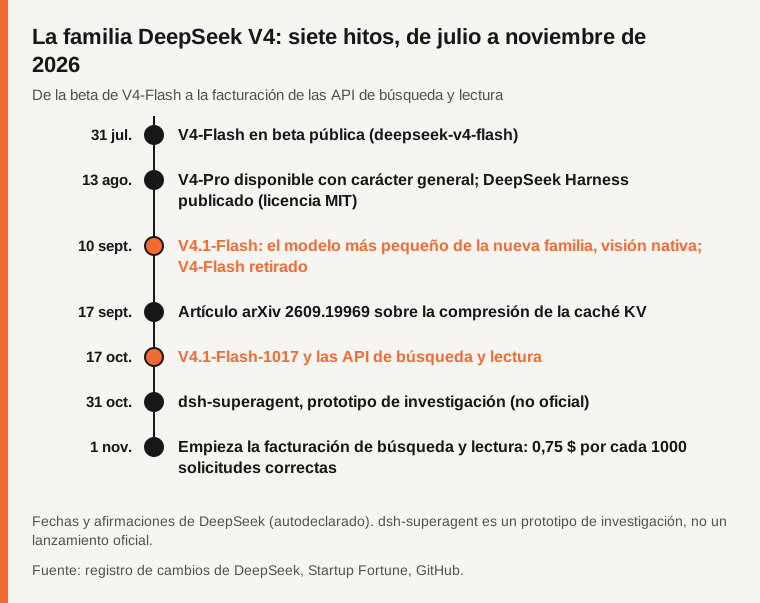
Fuente: registro de cambios de la API de DeepSeek, Startup Fortune, GitHub.
El 10 de septiembre, DeepSeek presentó V4.1-Flash como el modelo más pequeño de su nueva familia de arquitectura, con comprensión nativa de imágenes. V4-Flash y V4-Flash-Vision-Exp se retiraron y sus nombres redirigen a él. SiliconANGLE informó de una caída de la API de casi cinco horas el 15 de octubre. El 31 de octubre apareció un prototipo de investigación, dsh-superagent; no es oficial y se trata en otro artículo.
¿Cómo reduce la arquitectura el caché KV?
Durante la generación, un transformer guarda las claves y los valores (el caché KV) de cada token anterior, así que los contextos largos y los bucles de agentes que releen grandes entradas están limitados por la memoria del caché. DeepSeek lo ataca en tres puntos.
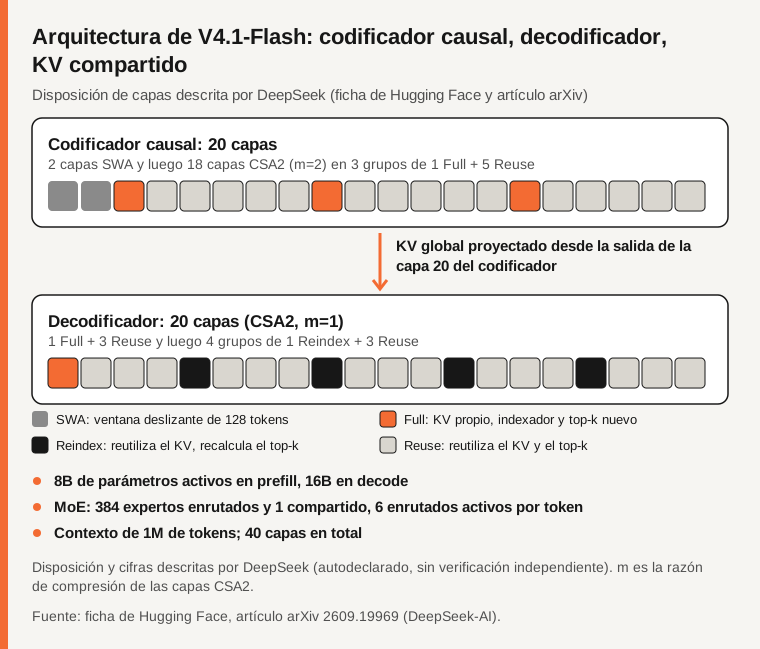
Fuente: ficha de Hugging Face, artículo de arXiv (DeepSeek).
Causal Encoder-Decoder (CED). Las 40 capas (dimensión oculta 5120) se reparten entre un codificador causal de 20 capas y un decodificador de 20 capas. El KV global del decodificador se proyecta desde la salida de la capa 20 del codificador, con pesos propios en cada capa, en lugar de calcularse a partir de los estados del decodificador. Así, la mayoría de los tokens del prompt se saltan el decodificador completo en el prefill; el artículo cifra el ahorro en aproximadamente la mitad del cómputo de prefill. Por eso hay 8B de parámetros activos en el prefill y 16B en el decode. El KV de ventana deslizante del decodificador se sigue calculando por capa.
Compressed Sparse Attention 2 (CSA2). Cada capa tiene un modo estático:
- Full: calcula su propio KV principal, las consultas y claves del indexador, y un top-k nuevo.
- Reindex: reutiliza el KV principal y las claves del indexador de una capa anterior, tiene su propia consulta de indexador y recalcula el top-k.
- Reuse: reutiliza el KV principal y los índices top-k; sin indexador.
En el codificador, las capas 1 y 2 son de atención de ventana deslizante (SWA) pura; 18 capas CSA2 con compresión m=2 forman tres grupos de seis (1 Full + 5 Reuse). El decodificador tiene 20 capas CSA2 con m=1: un grupo de 1 Full + 3 Reuse y luego cuatro grupos de 1 Reindex + 3 Reuse. El top-k es 512 y la ventana deslizante, de 128 tokens. Un indexador jerárquico permite que la primera capa Full elija 2048 bloques de 8 posiciones (un conjunto de 16 384 posiciones), que solo evalúan las capas Reindex.
FP4 y SWA Bounded Replay.
- FP4: el KV principal se guarda en FP4 (E2M1, una escala E4M3 por 16 canales, cuantificación después de RoPE); el KV SWA sigue en FP8. Eso reduce a la mitad, más o menos, la huella respecto al FP8 de V4. El artículo es incoherente sobre el momento: la introducción dice FP4 durante el entrenamiento y la sección 2.4.4 lo sitúa en QAT durante el posentrenamiento.
- SWA Bounded Replay: el KV SWA ya no se conserva, sino que se reconstruye reproduciendo los últimos 128 tokens. El KV global está garantizado al menos 72 horas; el KV SWA vive en DRAM del host unos minutos.
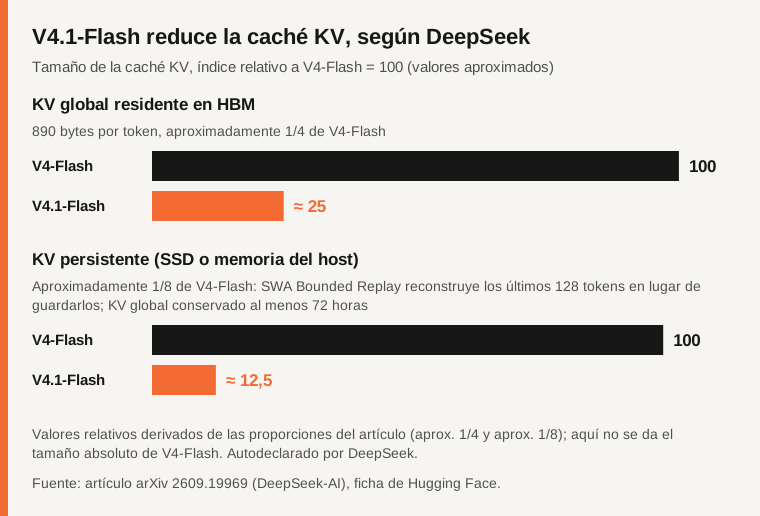
Fuente: artículo de arXiv, ficha de Hugging Face. Valores relativos, según las proporciones del artículo.
El resto de la pila, según DeepSeek:
- MoE: 1 experto compartido más 384 expertos enrutados, 6 enrutados activos por token, dimensión intermedia 2304, SwiGLU.
- Engram: memoria condicional dispersa, 196B de parámetros en dos módulos (capas 1 y 14).
- DSpark: decodificación especulativa con un drafter de 3 bloques que predice 5 posiciones en paralelo. La parte del artículo que leímos no da tasa de aceptación ni mejora de velocidad.
La única afirmación cuantitativa de eficiencia del artículo es que los FLOPs de decode crecen alrededor de una cuarta parte cuando el contexto pasa de 4K a 1M. Las partes leídas no dan desglose de los 890 bytes, ni rendimiento, ni latencia, ni ablaciones.
¿Qué mide DeepSeek y frente a quién?
El entrenamiento usó 45 T de tokens (texto frente a multimodal de 7:1), con el contexto ampliado a 1M a los 34 T de tokens. El posentrenamiento encadena SFT, RL y después destilación sobre política; la ficha atribuye las mejoras a la cadena de datos (tareas de agentes y entornos sintetizados), no a un algoritmo nuevo.
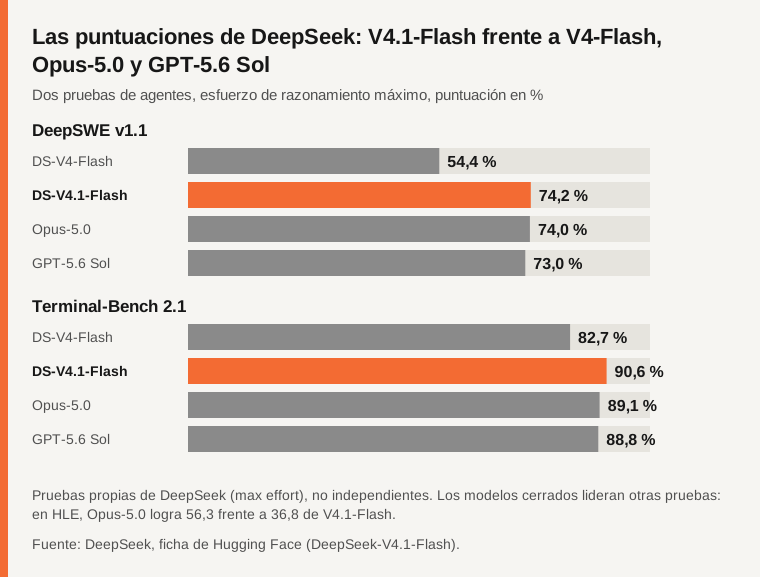
Fuente: ficha de Hugging Face. Benchmarks de DeepSeek, no independientes.
La tabla de DeepSeek también compara con Opus-5.0 (Anthropic) y GPT-5.6 Sol; recogemos las cifras tal como se publicaron. Según DeepSeek, V4.1-Flash obtiene 90,9 en GPQA Diamond (Opus-5.0 93,4, GPT-5.6 Sol 94,1), 30,0 en Terminal-Bench 3.0 (43,3 y 34,4) y 36,8 en HLE (56,3 y 44,5; los subconjuntos solo de texto se marcan aparte). Declara 88,1 en CyberGym (GPT-5.6 Sol 84,5) y 54,8 en AutomationBench (50,3 y 45,8). Así, según la propia tabla de DeepSeek, los modelos cerrados siguen por delante en varias pruebas (HLE, Terminal-Bench 3.0, algunas visuales como ZeroBench, 49,0 frente a 53,0 de GPT-5.6 Sol). SiliconANGLE cuenta a Opus-5.0 por delante en 7 de los 11 benchmarks publicados para la actualización.
Modelos base, según la ficha:
| Benchmark | V4-Flash-Base | V4-Pro-Base | V4.1-Flash-Base |
|---|---|---|---|
| MMLU-Pro | 68,3 | 73,5 | 74,1 |
| HumanEval | 69,5 | 76,8 | 79,4 |
| SimpleQA-Verified | 30,1 | 55,2 | 42,3 |
| MATH | 57,4 | 64,5 | 61,1 |
| LongBench-V2 | 44,7 | 51,5 | 45,2 |
V4-Pro-Base tiene 1,6 T de parámetros y sigue por delante de V4.1-Flash-Base en SimpleQA-Verified, MATH y LongBench-V2.
¿Qué cambia la actualización 1017?
V4.1-Flash-1017 conserva el identificador deepseek-flash y los mismos precios. DeepSeek declara mejoras de septiembre a la 1017: HLE sin herramientas de 36,8 a 42,6 (44,0 solo con texto), DeepSWE v1.1 de 74,2 a 77,0 y Terminal-Bench 4.0 de 31,2 a 42,3.
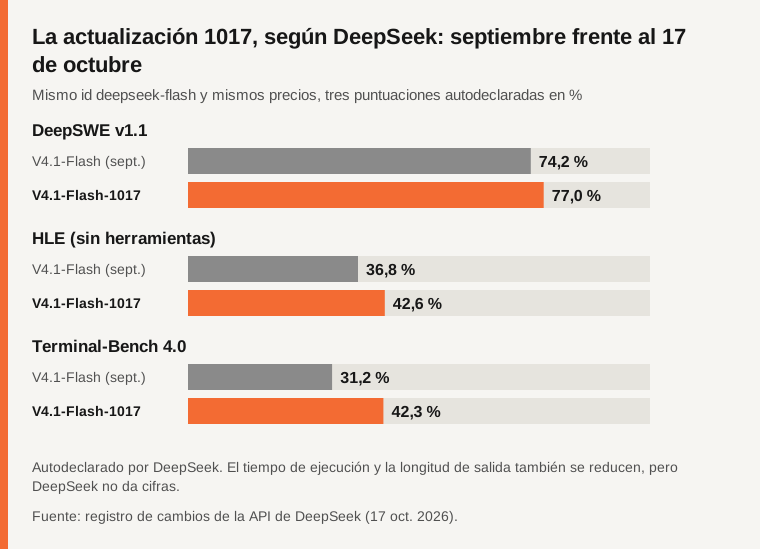
Fuente: registro de cambios de la API de DeepSeek (17 de octubre de 2026). Autodeclarado.
También se redujeron el tiempo de ejecución y la longitud de salida, sin cifras. Se recomienda Harness 0.2.1-rc.1 o posterior, y SiliconANGLE dice que el modelo se optimizó para Harness y para CodeBuddy y WorkBuddy de Tencent. DeepSeek habla de una mejora de Pareto en rendimiento y coste; Startup Fortune señala que es el juicio de la propia DeepSeek y que el calendario favorece su pila propia, aunque la licencia MIT permite a otros usar el modelo en herramientas competidoras. Neomanex advierte de que no se anuncia ninguna versión fija: vuelve a ejecutar tus evaluaciones, porque salidas más cortas pueden romper parsers y presupuestos de tokens.
¿Cuánto cuesta razonar y cómo se ajusta?
El esfuerzo de razonamiento se ajusta de 1 a 100; en la API, max vale 100, high 75 y low 50, y los resultados «instruct» usan 100.
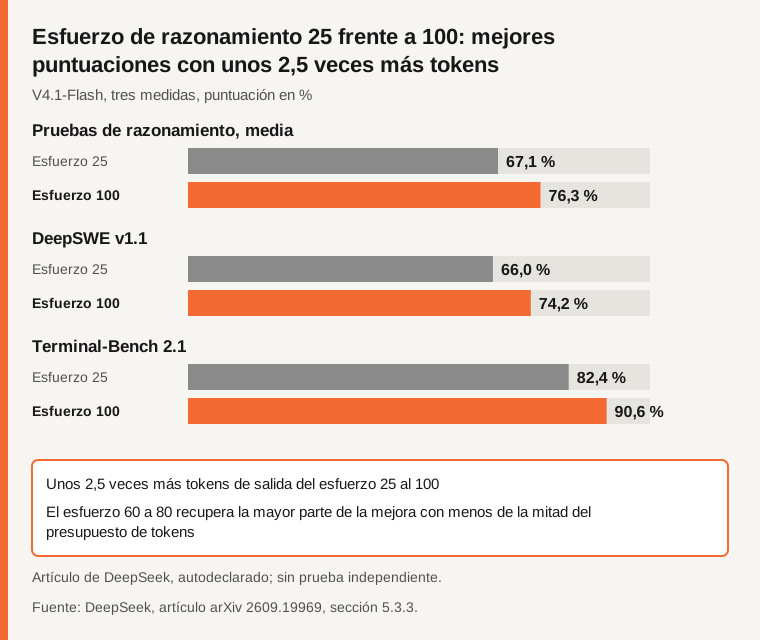
Fuente: artículo de arXiv, sección 5.3.3. Autodeclarado.
Pasar del esfuerzo 25 al 100 cuesta unas 2,5 veces más tokens de salida; esfuerzos de 60 a 80 capturan la mayor parte de la mejora con menos de la mitad de los tokens. El andamiaje también influye (DeepSWE v1.1 / Terminal-Bench 2.1, según la ficha): mini-SWE 74,2 / 90,3, DSH Minimal 72,6 / 90,6, DSH Standard 70,5 / 85,8; los demás arneses (Claude Code, Codex, OpenCode, Pi) obtienen de 65,5 a 69,8 en DeepSWE, y Terminal-Bench 2.1 va de 84,1 (Codex) a 90,6. Con varios agentes, el artículo informa de un ProgramBench Almost@1 del 30,04 % a las 8 horas frente al 20,39 % de un solo agente.
¿Cuánto cuesta y cómo se usa?
deepseek-flash es V4.1-Flash-1017; deepseek-v4-pro es V4-Pro-0813. Los nombres antiguos redirigen a Flash con los precios de Flash. Ambos ofrecen contexto de 1 M, salida máxima de 384 K, modos con y sin razonamiento, JSON, llamadas a herramientas, la API Responses y una API compatible con Anthropic; la visión solo está en Flash.
| Precio por millón de tokens | Flash valle | Flash punta | Pro valle | Pro punta |
|---|---|---|---|---|
| Entrada, cache hit | 0,003 $ | 0,006 $ | 0,022 $ | 0,044 $ |
| Entrada, cache miss | 0,15 $ | 0,30 $ | 0,66 $ | 1,32 $ |
| Salida | 0,60 $ | 1,20 $ | 1,98 $ | 3,96 $ |
Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes salvo festivos chinos; el resto es valle.
- API de búsqueda y lectura: 0,75 $ por cada 1000 solicitudes correctas de cada una, gratuitas hasta el 1 de noviembre y facturadas por solicitud desde las 00:00 hora de Pekín del 1 de noviembre de 2026. La búsqueda devuelve hasta 50 resultados clasificados; Fetch convierte una página en Markdown (SiliconANGLE). Puede llamarse desde el servidor mediante Harness, Claude Code o Codex.
- DeepSeek Harness: marco de agentes de código abierto oficial (
dsh, MIT), donde todo es un plugin (adaptadores de modelos, herramientas, registros, bucles de agente), con interfaz web; repositorio github.com/deepseek-ai/deepseek-harness. El número de estrellas varía según las fuentes (Startup Fortune, HelloGitHub), así que no damos ninguno. - Ejecutarlo tú mismo:
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash"(compatible con OpenAI, entrada de imagen) opython3 -m sglang.launch_server --model-path "deepseek-ai/DeepSeek-V4.1-Flash", o Transformers condevice_map="auto". No hay plantilla de chat Jinja: usa la implementación de referencia en Python de la carpetaencoding, o la biblioteca Rustdeepseek-recipeen producción. La ficha no da ninguna configuración de hardware mínima.
¿Qué no está establecido?
No hemos encontrado ninguna prueba independiente, y las comparaciones con Opus-5.0 y GPT-5.6 Sol son de DeepSeek. La ficha y el artículo hablan de 552B de parámetros de backbone, mientras que los metadatos de Safetensors indican 763B; quizá los 196B de Engram o el codificador visual, pero no está confirmado. El rendimiento, la latencia y el coste de servicio reales no se publican, las ablaciones no están cuantificadas, se desconoce la mejora real de DSpark y no se indica el hardware mínimo. No hemos medido el efecto de la 1017 en las salidas largas.
Tabla resumen
| Punto | Lo que dicen las fuentes al 2 de noviembre de 2026 | Fuente |
|---|---|---|
| Modelo | MoE multimodal, MIT, contexto de 1 M, 8B activos en prefill / 16B en decode | Hugging Face, arXiv |
| Tamaño | 552B de backbone en el texto; 763B en los metadatos, sin explicación | Hugging Face |
| KV global | 890 bytes por token, alrededor de 1/4 de V4-Flash | arXiv |
| KV persistente | Alrededor de 1/8 de V4-Flash, mediante SWA Bounded Replay | arXiv |
| Benchmarks | DeepSWE 74,2 (77,0 en 1017), Terminal-Bench 2.1 90,6; autodeclarados | Hugging Face, registro de cambios |
| Precio | Flash 0,15 $ / 0,60 $ en valle, 0,30 $ / 1,20 $ en punta (cache miss / salida) | Tarifas de DeepSeek |
| Pruebas independientes | Ninguna encontrada | n. d. |
Preguntas frecuentes
¿El modelo es realmente 4 veces más ligero?
No. Según DeepSeek, es el caché KV global en HBM el que ronda una cuarta parte del de V4-Flash (890 bytes por token), no el modelo. El texto habla de 552B de parámetros y los metadatos de 763B, sin explicación.
¿Puedo ejecutarlo yo mismo?
Los pesos son MIT y la ficha documenta vLLM, SGLang y Transformers. No indica hardware mínimo, así que no podemos decir qué se necesita.
¿La actualización 1017 cambia el precio o el identificador?
No. El identificador sigue siendo deepseek-flash y los precios son idénticos. No se anuncia ninguna versión fija: vuelve a ejecutar tus evaluaciones.
¿DeepSeek supera a los modelos cerrados?
Según DeepSeek, va por delante en algunas pruebas de agentes y por detrás en otras (HLE, Terminal-Bench 3.0, algunas pruebas visuales). No hay ninguna prueba independiente.
Método y límites
Leímos la ficha de Hugging Face (mediante un resumen automático, así que las cifras deben contrastarse), alrededor de dos tercios del artículo de arXiv, el registro de cambios y la página de precios de DeepSeek, y fuentes secundarias de calidad desigual (Neomanex, HelloGitHub). No probamos el modelo y no encontramos en el artículo ninguna ablación ni medición de rendimiento. No es consejo de compra ni de inversión.
Fuentes
- Hugging Face: ficha del modelo DeepSeek-V4.1-Flash (verificado el 2026-11-02)
- arXiv 2609.19969: DeepSeek-V4.1-Flash, Pushing the Limits of KV Cache Compression (verificado el 2026-11-02)
- API de DeepSeek: actualizaciones (registro de cambios) (verificado el 2026-11-02)
- API de DeepSeek: modelos y precios (verificado el 2026-11-02)
- SiliconANGLE: DeepSeek lanza una versión actualizada de V4.1-Flash (verificado el 2026-11-02)
- Startup Fortune: DeepSeek ata su nuevo modelo V4.1-Flash-1017 más a su propio Harness (verificado el 2026-11-02)
- Neomanex: DeepSeek V4.1-Flash-1017, mismo identificador de Flash, mismo precio (verificado el 2026-11-02)
- HelloGitHub: deepseek-harness (verificado el 2026-11-02)
¿Ha detectado un error en este artículo? Comuníquenoslo · Nuestra política de correcciones
