Analisi
'Dentro DeepSeek V4.1-Flash: la sua cache KV, l''aggiornamento 1017 e lo stack Harness'
Per DeepSeek, la cache KV globale di V4.1-Flash è circa 1/4 di quella di V4-Flash. Come, cosa cambia la 1017, quanto costa e cosa non è verificato.
Al 2 novembre 2026, DeepSeek ha rilasciato V4.1-Flash (10 settembre), ha pubblicato il suo articolo tecnico (17 settembre) e ha aggiornato il modello a V4.1-Flash-1017 (17 ottobre), insieme a un framework di agenti open source, DeepSeek Harness, e a un'API a pagamento di ricerca e lettura web. Il cuore tecnico, secondo DeepSeek, è una cache KV globale di 890 byte per token, circa un quarto di quella di V4-Flash. Tutti i benchmark qui sotto sono di DeepSeek: non abbiamo trovato alcun test indipendente e non abbiamo eseguito il modello.
L'essenziale
- Cosa è uscito: un modello multimodale Mixture-of-Experts a pesi aperti (MIT) con contesto di 1M di token, un articolo sulla compressione della cache KV, un aggiornamento 1017 con lo stesso id API e Harness.
- L'idea tecnica: per gli agenti il vincolo è la cache KV e i carichi ricchi di input, non solo la dimensione del modello. DeepSeek riduce la cache condividendola tra i livelli e memorizzandola in FP4.
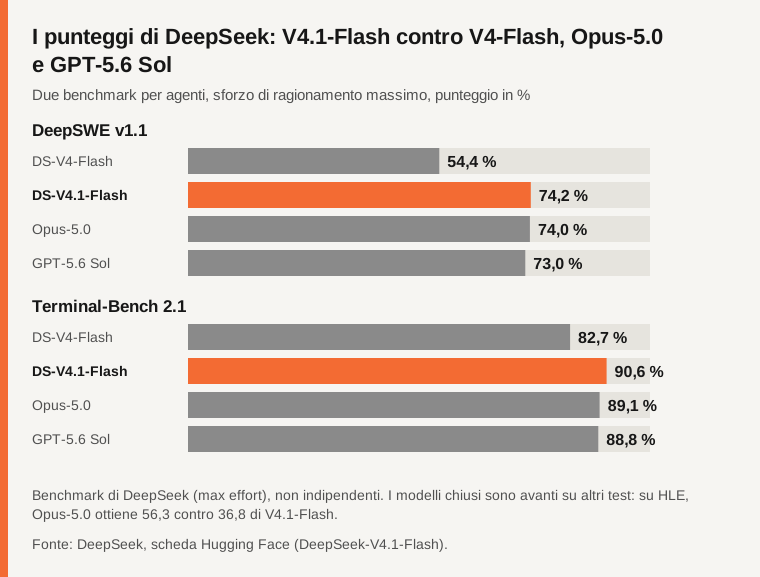
- Cifre chiave, secondo DeepSeek: KV globale circa 1/4 di V4-Flash, KV persistente circa 1/8; 74,2 su DeepSWE v1.1 e 90,6 su Terminal-Bench 2.1 (77,0 su DeepSWE dopo la 1017).
- Uso:
deepseek-flasha partire da 0,15 $ per milione di token in ingresso senza cache hit nelle ore di morbida (0,30 $ nelle ore di punta); pesi su Hugging Face e ModelScope. - Non verificato: benchmark indipendenti, velocità effettiva, latenza e costo di servizio, e la differenza tra 552B e 763B parametri.
Cosa ha rilasciato DeepSeek, e in quale ordine?
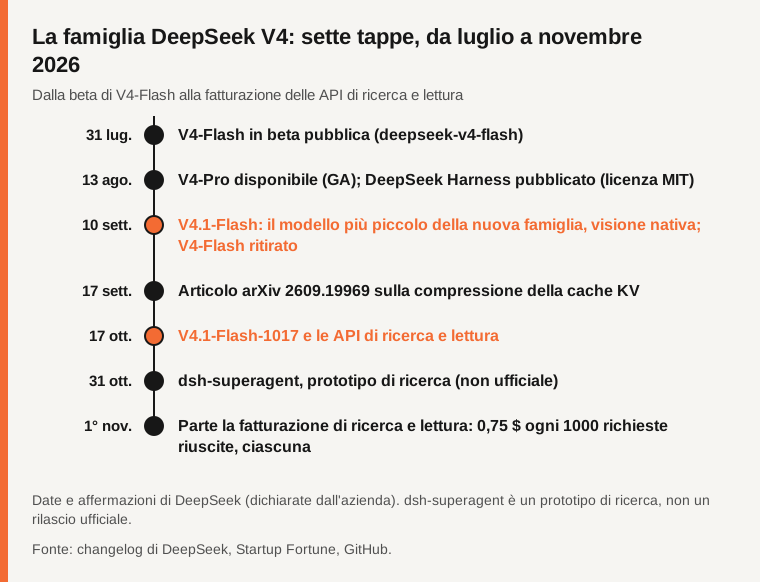
La sequenza qui sotto viene dal changelog API di DeepSeek; la data di lancio di Harness è presa da Startup Fortune.
Fonte: changelog API DeepSeek, Startup Fortune, GitHub.
Il 10 settembre DeepSeek ha definito V4.1-Flash il più piccolo modello della sua nuova famiglia di architettura, con comprensione nativa delle immagini. V4-Flash e V4-Flash-Vision-Exp sono stati ritirati e i loro nomi rimandano a V4.1-Flash. SiliconANGLE ha riportato un'interruzione dell'API di quasi cinque ore il 15 ottobre. Un prototipo di ricerca, dsh-superagent, è comparso il 31 ottobre; non è ufficiale ed è trattato in un altro articolo.
Come fa l'architettura a ridurre la cache KV?
Durante la generazione, un transformer memorizza chiavi e valori (la cache KV) di ogni token precedente: i contesti lunghi e i cicli di agenti che rileggono grandi input sono quindi limitati dalla memoria della cache. DeepSeek interviene in tre punti.
Fonte: scheda Hugging Face, articolo arXiv (DeepSeek).
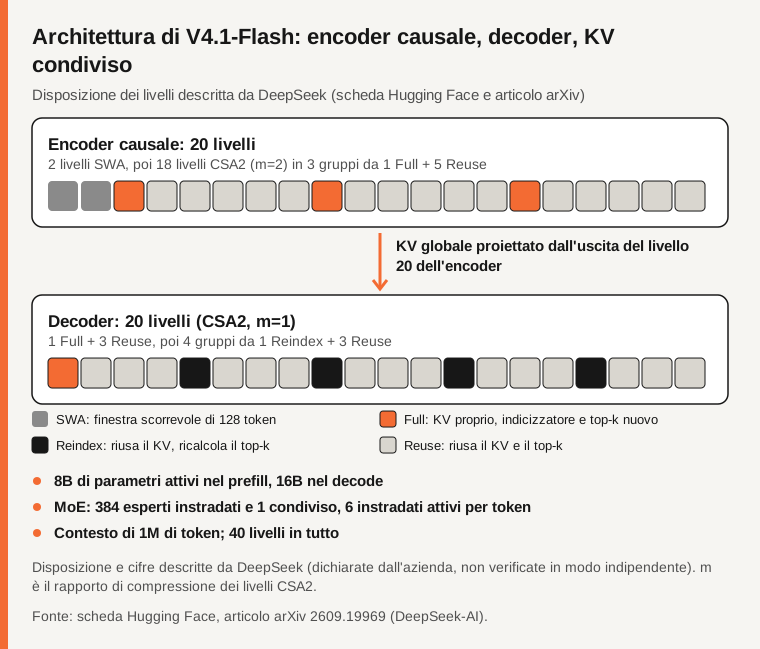
Causal Encoder-Decoder (CED). I 40 livelli (dimensione nascosta 5120) sono divisi in un encoder causale di 20 livelli e un decoder di 20 livelli. Il KV globale del decoder è proiettato dall'uscita del livello 20 dell'encoder, con pesi propri per ogni livello, invece di essere calcolato dagli stati del decoder. La maggior parte dei token del prompt salta quindi il decoder completo al prefill; l'articolo stima il risparmio in circa metà del calcolo di prefill. Per questo i parametri attivi sono 8B al prefill e 16B al decode. Il KV a finestra scorrevole del decoder resta calcolato livello per livello.
Compressed Sparse Attention 2 (CSA2). Ogni livello ha una modalità statica:
- Full: calcola il proprio KV principale, query e chiavi dell'indicizzatore e un nuovo top-k.
- Reindex: riutilizza il KV principale e le chiavi dell'indicizzatore di un livello precedente, ha una propria query dell'indicizzatore e ricalcola il top-k.
- Reuse: riutilizza il KV principale e gli indici top-k; nessun indicizzatore.
Nell'encoder, i livelli 1 e 2 sono attenzione a finestra scorrevole (SWA) pura; 18 livelli CSA2 con compressione m=2 formano tre gruppi da sei (1 Full + 5 Reuse). Il decoder ha 20 livelli CSA2 con m=1: un gruppo da 1 Full + 3 Reuse, poi quattro gruppi da 1 Reindex + 3 Reuse. Il top-k è 512 e la finestra scorrevole è di 128 token. Un indicizzatore gerarchico permette al primo livello Full di scegliere 2.048 blocchi da 8 posizioni (un insieme di 16.384 posizioni), che solo i livelli Reindex valutano.
FP4 e SWA Bounded Replay.
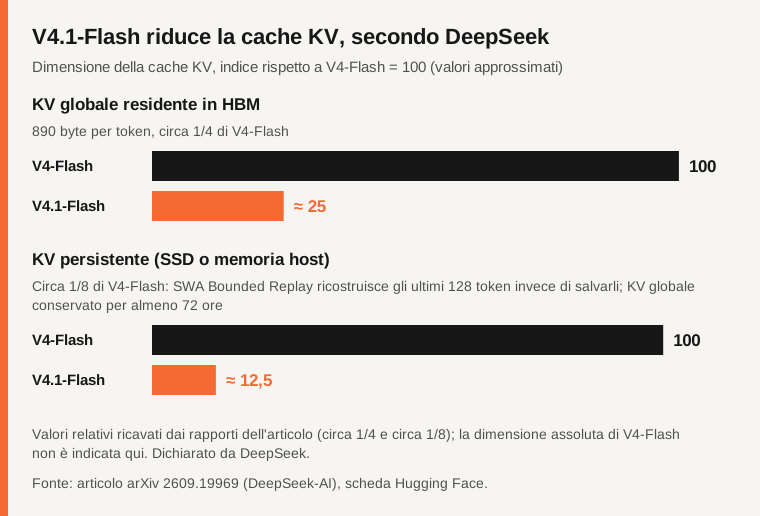
- FP4: il KV principale è memorizzato in FP4 (E2M1, una scala E4M3 ogni 16 canali, quantizzato dopo RoPE); il KV SWA resta in FP8. Questo dimezza all'incirca l'ingombro rispetto all'FP8 di V4. L'articolo non è coerente sui tempi: l'introduzione parla di FP4 durante l'addestramento, la sezione 2.4.4 lo colloca nel QAT del post-addestramento.
- SWA Bounded Replay: il KV SWA non è più reso persistente ma ricostruito rieseguendo gli ultimi 128 token. Il KV globale è garantito per almeno 72 ore; il KV SWA vive nella DRAM dell'host per qualche minuto.
Fonte: articolo arXiv, scheda Hugging Face. I valori sono relativi, dai rapporti dell'articolo.
Il resto dello stack, secondo DeepSeek:
- MoE: 1 esperto condiviso più 384 instradati, 6 instradati attivi per token, dimensione intermedia 2.304, SwiGLU.
- Engram: memoria condizionale sparsa, 196B parametri in due moduli (livelli 1 e 14).
- DSpark: decodifica speculativa con un drafter di 3 blocchi che predice 5 posizioni in parallelo. La parte dell'articolo che abbiamo letto non dà né tasso di accettazione né accelerazione.
L'unica affermazione quantitativa di efficienza dell'articolo è che i FLOPs di decode crescono di circa un quarto quando il contesto passa da 4K a 1M. Nelle parti lette non c'è alcuna scomposizione degli 890 byte, né velocità effettiva, latenza o ablazioni.
Cosa misura DeepSeek, e contro chi?
L'addestramento ha usato 45T token (testo e multimodale 7:1), con contesto esteso a 1M a 34T token. Il post-addestramento prevede SFT, RL e poi distillazione on-policy; la scheda attribuisce i miglioramenti alla catena di dati (sintesi di compiti e ambienti per agenti), non a un nuovo algoritmo.
Fonte: scheda Hugging Face. Benchmark di DeepSeek, non indipendenti.
La tabella di DeepSeek confronta anche con Opus-5.0 (Anthropic) e GPT-5.6 Sol; riportiamo i numeri come pubblicati. Secondo DeepSeek, V4.1-Flash ottiene 90,9 su GPQA Diamond (Opus-5.0 93,4, GPT-5.6 Sol 94,1), 30,0 su Terminal-Bench 3.0 (43,3 e 34,4) e 36,8 su HLE (56,3 e 44,5; i sottoinsiemi di solo testo sono indicati a parte). Riporta 88,1 su CyberGym (GPT-5.6 Sol 84,5) e 54,8 su AutomationBench (50,3 e 45,8). Quindi, secondo la tabella di DeepSeek stessa, i modelli chiusi restano avanti su diversi test (HLE, Terminal-Bench 3.0, alcuni visivi come ZeroBench, 49,0 contro 53,0 per GPT-5.6 Sol). SiliconANGLE conta Opus-5.0 in testa su 7 degli 11 benchmark pubblicati per l'aggiornamento.
Modelli di base, secondo la scheda:
| Benchmark | V4-Flash-Base | V4-Pro-Base | V4.1-Flash-Base |
|---|---|---|---|
| MMLU-Pro | 68,3 | 73,5 | 74,1 |
| HumanEval | 69,5 | 76,8 | 79,4 |
| SimpleQA-Verified | 30,1 | 55,2 | 42,3 |
| MATH | 57,4 | 64,5 | 61,1 |
| LongBench-V2 | 44,7 | 51,5 | 45,2 |
V4-Pro-Base ha 1,6T parametri e resta avanti a V4.1-Flash-Base su SimpleQA-Verified, MATH e LongBench-V2.
Cosa cambia l'aggiornamento 1017?
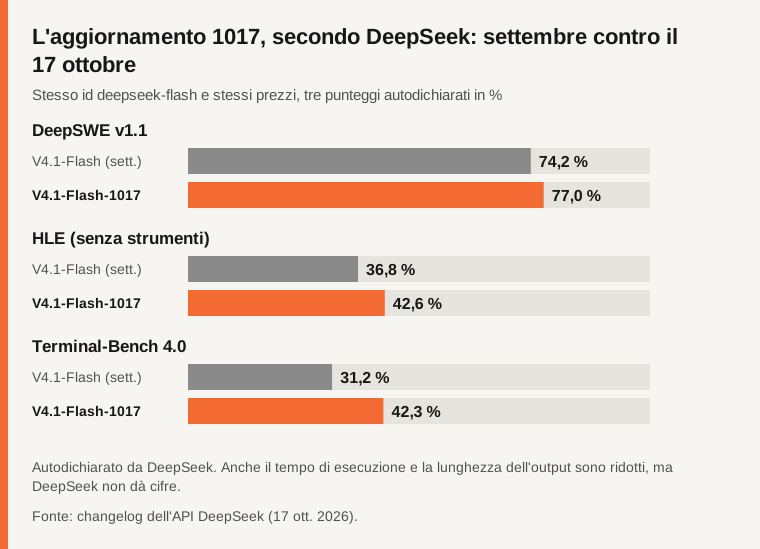
V4.1-Flash-1017 mantiene l'id deepseek-flash e gli stessi prezzi. DeepSeek riporta i miglioramenti da settembre alla 1017: HLE senza strumenti da 36,8 a 42,6 (44,0 sul solo testo), DeepSWE v1.1 da 74,2 a 77,0 e Terminal-Bench 4.0 da 31,2 a 42,3.
Fonte: changelog API DeepSeek (17 ottobre 2026). Auto-dichiarato.
Anche tempo di esecuzione e lunghezza dell'output sono stati ridotti, senza cifre. Si raccomanda Harness 0.2.1-rc.1 o successivo, e secondo SiliconANGLE il modello è stato ottimizzato per Harness e per CodeBuddy e WorkBuddy di Tencent. DeepSeek definisce il rilascio un miglioramento di Pareto in prestazioni e costo; Startup Fortune osserva che è un giudizio di DeepSeek stessa e che i tempi favoriscono il suo stack interno, anche se la licenza MIT permette ad altri di usare il modello in strumenti concorrenti. Neomanex nota che non è annunciata alcuna versione fissa: rifate le vostre valutazioni, perché output più corti possono rompere parser e budget di token.
Quanto costa il ragionamento e come regolarlo?
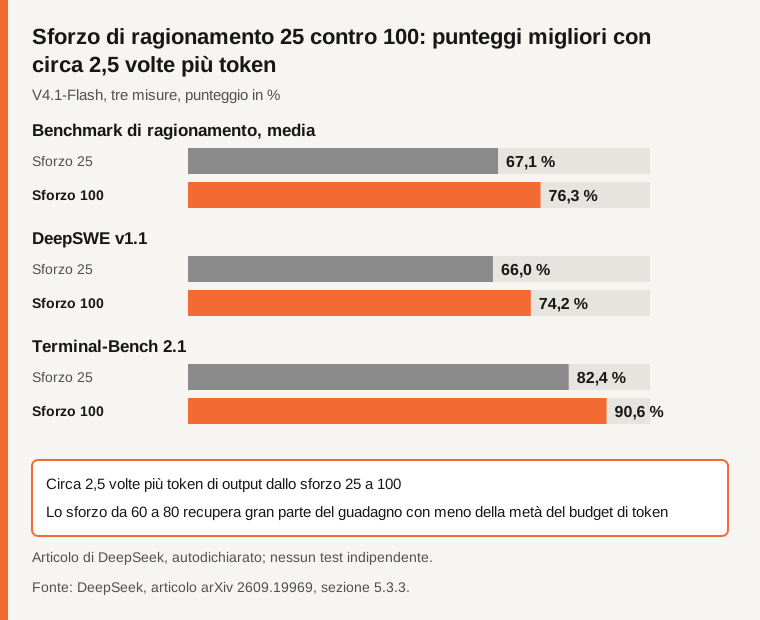
Lo sforzo di ragionamento è regolabile da 1 a 100; nell'API max vale 100, high 75 e low 50, e i risultati instruct usano 100.
Fonte: articolo arXiv, sezione 5.3.3. Auto-dichiarato.
Passare da sforzo 25 a 100 costa circa 2,5 volte più token di output; sforzi da 60 a 80 colgono la maggior parte del guadagno con meno della metà dei token. Conta anche l'impalcatura (DeepSWE v1.1 / Terminal-Bench 2.1, secondo la scheda): mini-SWE 74,2 / 90,3, DSH Minimal 72,6 / 90,6, DSH Standard 70,5 / 85,8; gli altri harness (Claude Code, Codex, OpenCode, Pi) ottengono da 65,5 a 69,8 su DeepSWE, e Terminal-Bench 2.1 va da 84,1 (Codex) a 90,6. Con più agenti, l'articolo riporta un ProgramBench Almost@1 del 30,04% a 8 ore contro il 20,39% per un solo agente.
Quanto costa e come si usa?
deepseek-flash è V4.1-Flash-1017; deepseek-v4-pro è V4-Pro-0813. I vecchi nomi rimandano a Flash ai prezzi di Flash. Entrambi offrono contesto di 1M, output massimo di 384K, modalità con e senza ragionamento, JSON, chiamate di strumenti, API Responses e un'API compatibile con Anthropic; la visione è solo per Flash.
| Prezzo per milione di token | Flash ore di morbida | Flash ore di punta | Pro ore di morbida | Pro ore di punta |
|---|---|---|---|---|
| Ingresso, cache hit | 0,003 $ | 0,006 $ | 0,022 $ | 0,044 $ |
| Ingresso, cache miss | 0,15 $ | 0,30 $ | 0,66 $ | 1,32 $ |
| Uscita | 0,60 $ | 1,20 $ | 1,98 $ | 3,96 $ |
Le ore di punta sono dalle 01:00 alle 04:00 e dalle 06:00 alle 10:00 UTC, dal lunedì al venerdì esclusi i giorni festivi cinesi; il resto è ore di morbida.
- API di ricerca e lettura: 0,75 $ ogni 1.000 richieste riuscite ciascuna, gratuita fino al 1° novembre e fatturata per richiesta dalle 00:00 ora di Pechino del 1° novembre 2026. La ricerca restituisce fino a 50 risultati ordinati; Fetch converte una pagina in Markdown (SiliconANGLE). Può essere chiamata lato server tramite Harness, Claude Code o Codex.
- DeepSeek Harness: framework di agenti open source ufficiale (
dsh, MIT), tutto è un plugin (adattatori di modelli, strumenti, registri, cicli di agente), con interfaccia web; repository github.com/deepseek-ai/deepseek-harness. Il numero di stelle riportato diverge tra le fonti (Startup Fortune, HelloGitHub), quindi non lo diamo. - Eseguirlo in proprio:
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash"(compatibile OpenAI, ingresso immagine) oppurepython3 -m sglang.launch_server --model-path "deepseek-ai/DeepSeek-V4.1-Flash", o Transformers condevice_map="auto". Non c'è un modello di chat Jinja: usate il Python di riferimento nella cartellaencoding, o la libreria Rustdeepseek-recipein produzione. La scheda non indica alcun hardware minimo.
Cosa non è accertato?
Non esiste alcun test indipendente che abbiamo potuto trovare, e i confronti con Opus-5.0 e GPT-5.6 Sol sono di DeepSeek. La scheda e l'articolo parlano di 552B parametri di backbone, mentre i metadati Safetensors indicano 763B; forse i 196B di Engram o l'encoder visivo, ma non è confermato. Velocità effettiva, latenza e costo di servizio reali non sono pubblicati, le ablazioni non sono quantificate, il guadagno reale di DSpark è ignoto e l'hardware minimo non è indicato. Non abbiamo misurato l'effetto della 1017 sugli output lunghi.
Tabella di confronto
| Punto | Cosa dicono le fonti al 2 nov. 2026 | Fonte |
|---|---|---|
| Modello | MoE multimodale, MIT, contesto 1M, 8B attivi al prefill / 16B al decode | Hugging Face, arXiv |
| Dimensione | 552B di backbone nel testo; 763B nei metadati, senza spiegazione | Hugging Face |
| KV globale | 890 byte per token, circa 1/4 di V4-Flash | arXiv |
| KV persistente | Circa 1/8 di V4-Flash, tramite SWA Bounded Replay | arXiv |
| Benchmark | DeepSWE 74,2 (77,0 nella 1017), Terminal-Bench 2.1 90,6; auto-dichiarati | Hugging Face, changelog |
| Prezzo | Flash 0,15 $ / 0,60 $ ore di morbida, 0,30 $ / 1,20 $ ore di punta (cache miss / uscita) | Prezzi DeepSeek |
| Test indipendenti | Nessuno trovato | n.d. |
Domande frequenti
Il modello è davvero 4 volte più leggero?
No. Secondo DeepSeek, è la cache KV globale in HBM a essere circa un quarto di quella di V4-Flash (890 byte per token), non il modello. Il testo parla di 552B parametri e i metadati di 763B, senza spiegazione.
Posso eseguirlo in proprio?
I pesi sono MIT e la scheda documenta vLLM, SGLang e Transformers. Non indica alcun hardware minimo, quindi non possiamo dire di cosa abbiate bisogno.
L'aggiornamento 1017 cambia prezzo o id?
No. L'id resta deepseek-flash e i prezzi sono identici. Non è annunciata alcuna versione fissa, quindi rifate le vostre valutazioni.
DeepSeek batte i modelli chiusi?
Secondo DeepSeek, è avanti su alcuni test di agenti e dietro su altri (HLE, Terminal-Bench 3.0, alcuni test visivi). Non c'è alcun test indipendente.
Metodo e limiti
Abbiamo letto la scheda Hugging Face (tramite un riassunto automatico, quindi le cifre vanno ricontrollate), circa due terzi dell'articolo arXiv, il changelog e la pagina dei prezzi di DeepSeek, e fonti secondarie di qualità disomogenea (Neomanex, HelloGitHub). Non abbiamo provato il modello e nell'articolo non abbiamo trovato né ablazioni né misure di velocità effettiva. Non è un consiglio d'acquisto né di investimento.
Fonti
- Hugging Face: scheda del modello DeepSeek-V4.1-Flash (verificato il 2026-11-02)
- arXiv 2609.19969: DeepSeek-V4.1-Flash, Pushing the Limits of KV Cache Compression (verificato il 2026-11-02)
- API DeepSeek: aggiornamenti (changelog) (verificato il 2026-11-02)
- API DeepSeek: modelli e prezzi (verificato il 2026-11-02)
- SiliconANGLE: DeepSeek rilascia il modello V4.1-Flash aggiornato (verificato il 2026-11-02)
- Startup Fortune: DeepSeek lega il nuovo modello V4.1-Flash-1017 più strettamente al proprio Harness (verificato il 2026-11-02)
- Neomanex: DeepSeek V4.1-Flash-1017, stesso id Flash, stesso prezzo (verificato il 2026-11-02)
- HelloGitHub: deepseek-harness (verificato il 2026-11-02)
Avete notato un errore in questo articolo? Segnalatelo · La nostra politica sulle correzioni
