Análise
'Por dentro do DeepSeek V4.1-Flash: seu cache KV, a atualização 1017 e a pilha Harness'
Segundo a DeepSeek, o V4.1-Flash tem um cache KV global cerca de 1/4 do do V4-Flash. Como funciona, o que a 1017 mudou, o custo e o que não foi verificado.
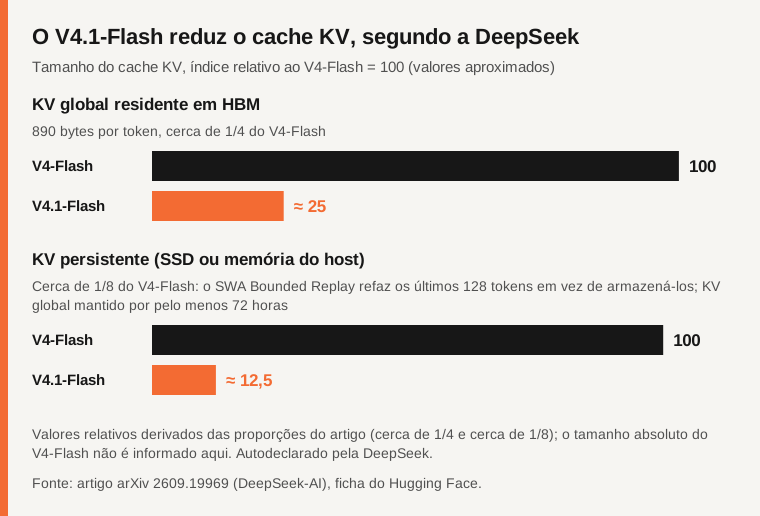
Em 2 de novembro de 2026, a DeepSeek lançou o V4.1-Flash (10 de setembro), publicou seu artigo técnico (17 de setembro) e atualizou o modelo para V4.1-Flash-1017 (17 de outubro), junto com um framework de agentes de código aberto, o DeepSeek Harness, e uma API paga de busca e leitura da web. O núcleo técnico, segundo a DeepSeek, é um cache KV global de 890 bytes por token, cerca de um quarto do do V4-Flash. Todos os benchmarks abaixo são da própria DeepSeek; não encontramos nenhum teste independente e não executamos o modelo.
O essencial
- O que foi lançado: um modelo multimodal Mixture-of-Experts de pesos abertos (MIT) com janela de contexto de 1M de tokens, um artigo sobre compressão do cache KV, uma atualização 1017 sob o mesmo id de API e o Harness.
- A ideia técnica: a restrição para agentes de IA é o cache KV e as cargas ricas em entrada, não apenas o tamanho do modelo. A DeepSeek reduz o cache compartilhando-o entre camadas e armazenando-o em FP4.
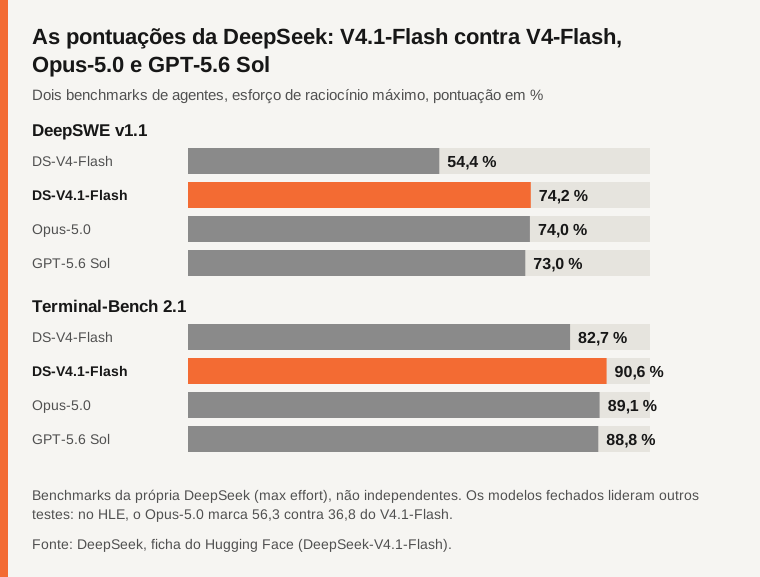
- Números principais, segundo a DeepSeek: KV global cerca de 1/4 do V4-Flash, KV persistente cerca de 1/8; 74,2 no DeepSWE v1.1 e 90,6 no Terminal-Bench 2.1 (77,0 no DeepSWE após a 1017).
- Uso:
deepseek-flasha partir de US$ 0,15 por milhão de tokens de entrada sem cache (cache miss) fora do horário de pico (US$ 0,30 no pico); pesos no Hugging Face e no ModelScope. - Não verificado: benchmarks independentes, vazão real, latência e custo de operação, e a diferença entre 552B e 763B de parâmetros.
O que a DeepSeek lançou e em que ordem?
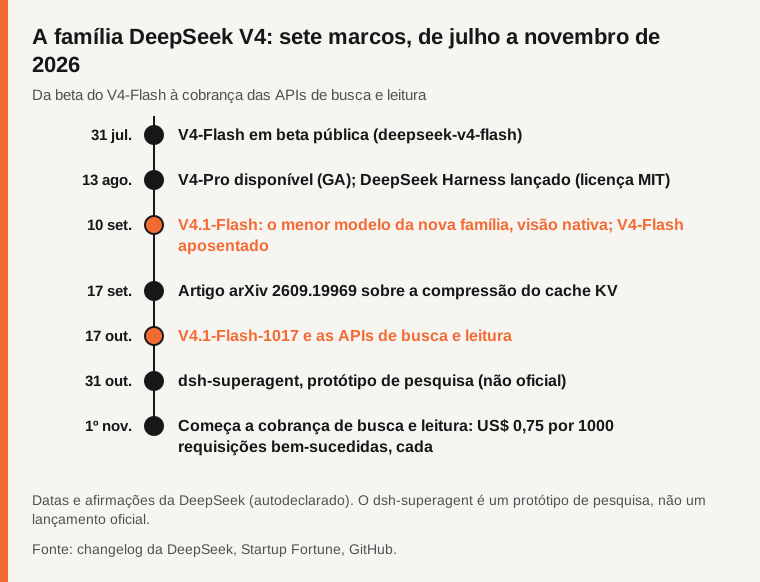
A sequência abaixo vem do changelog da API da DeepSeek, com a data de lançamento do Harness tirada da Startup Fortune.
Fonte: changelog da API da DeepSeek, Startup Fortune, GitHub.
Em 10 de setembro, a DeepSeek chamou o V4.1-Flash de o menor modelo de sua nova família de arquitetura, com compreensão nativa de imagens. O V4-Flash e o V4-Flash-Vision-Exp foram aposentados e seus nomes redirecionam para ele. A SiliconANGLE relatou uma queda da API de quase cinco horas em 15 de outubro. Um protótipo de pesquisa, o dsh-superagent, apareceu em 31 de outubro; é não oficial e é tratado em outro artigo.
Como a arquitetura reduz o cache KV?
Durante a geração, um transformer armazena chaves e valores (o cache KV) de cada token anterior, de modo que contextos longos e laços de agentes que relêem entradas grandes ficam limitados pela memória do cache. A DeepSeek ataca o problema em três pontos.
Fonte: ficha do modelo no Hugging Face, artigo arXiv (DeepSeek).
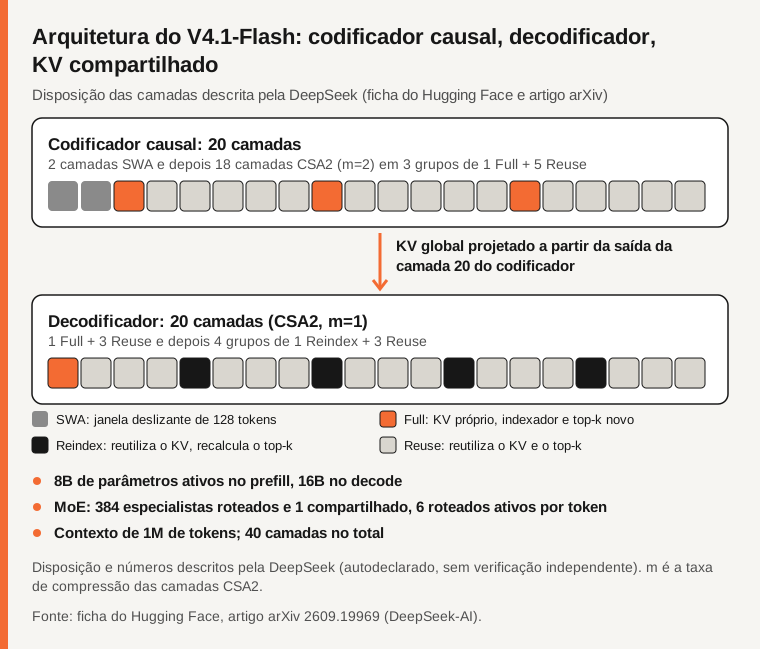
Causal Encoder-Decoder (CED). As 40 camadas (dimensão oculta 5120) são divididas em um codificador causal de 20 camadas e um decodificador de 20 camadas. O KV global do decodificador é projetado a partir da saída da camada 20 do codificador, com pesos separados por camada, em vez de ser calculado a partir dos estados do decodificador. A maioria dos tokens do prompt, portanto, pula o decodificador completo no prefill; o artigo estima a economia em cerca de metade do cálculo do prefill. É por isso que 8B de parâmetros ficam ativos no prefill e 16B na decodificação. O KV de janela deslizante do decodificador continua sendo calculado por camada.
Compressed Sparse Attention 2 (CSA2). Cada camada tem um único modo estático:
- Full: calcula seu próprio KV principal, consultas e chaves do indexador e um novo top-k.
- Reindex: reutiliza o KV principal e as chaves do indexador de uma camada anterior, tem sua própria consulta do indexador e recalcula o top-k.
- Reuse: reutiliza o KV principal e os índices do top-k; sem indexador algum.
No codificador, as camadas 1 e 2 são de atenção pura por janela deslizante (SWA); 18 camadas CSA2 com compressão m=2 formam três grupos de seis (1 Full + 5 Reuse). O decodificador tem 20 camadas CSA2 com m=1: um grupo de 1 Full + 3 Reuse, depois quatro grupos de 1 Reindex + 3 Reuse. O top-k é 512 e a janela deslizante é de 128 tokens. Um indexador hierárquico permite que a primeira camada Full escolha 2 048 blocos de 8 posições (um conjunto de 16 384 posições), que somente as camadas Reindex pontuam.
FP4 e SWA Bounded Replay.
- FP4: o KV principal é armazenado em FP4 (E2M1, uma escala E4M3 por 16 canais, quantizado após o RoPE); o KV SWA permanece em FP8. Isso reduz a pegada aproximadamente pela metade em relação ao FP8 do V4. O artigo é inconsistente quanto ao momento: a introdução diz FP4 durante o treinamento, a seção 2.4.4 o situa no QAT de pós-treinamento.
- SWA Bounded Replay: o KV SWA deixa de ser persistido e é reconstruído reproduzindo os últimos 128 tokens. O KV global é garantido por pelo menos 72 horas; o KV SWA vive na DRAM do host por alguns minutos.
Fonte: artigo arXiv, ficha do modelo no Hugging Face. Os valores são relativos, a partir das proporções do artigo.
O restante da pilha, segundo a DeepSeek:
- MoE: 1 especialista compartilhado mais 384 roteados, 6 roteados ativos por token, tamanho intermediário 2 304, SwiGLU.
- Engram: memória condicional esparsa, 196B de parâmetros em dois módulos (camadas 1 e 14).
- DSpark: decodificação especulativa com um rascunhador de 3 blocos que prevê 5 posições em paralelo. A parte do artigo que lemos não traz taxa de aceitação nem ganho de velocidade.
A única afirmação quantitativa de eficiência do artigo é que os FLOPs de decodificação crescem cerca de um quarto quando o contexto vai de 4K a 1M. As partes que lemos não trazem detalhamento dos 890 bytes, vazão, latência nem ablações.
O que a DeepSeek mede e contra quem?
O treinamento usou 45T de tokens (texto para multimodal, 7:1), com o contexto estendido a 1M aos 34T de tokens. O pós-treinamento executa SFT, RL e depois destilação on-policy; a ficha do modelo atribui os ganhos ao pipeline de dados (tarefas e ambientes de agentes sintetizados), não a um novo algoritmo.
Fonte: ficha do modelo no Hugging Face. Benchmarks da DeepSeek, não independentes.
A tabela da DeepSeek também compara com o Opus-5.0 (Anthropic) e o GPT-5.6 Sol; informamos os números como publicados. Segundo a DeepSeek, o V4.1-Flash marca 90,9 no GPQA Diamond (Opus-5.0 93,4, GPT-5.6 Sol 94,1), 30,0 no Terminal-Bench 3.0 (43,3 e 34,4) e 36,8 no HLE (56,3 e 44,5; os subconjuntos somente de texto são indicados separadamente). Ela informa 88,1 no CyberGym (GPT-5.6 Sol 84,5) e 54,8 no AutomationBench (50,3 e 45,8). Assim, segundo a própria tabela da DeepSeek, os modelos fechados continuam à frente em vários testes (HLE, Terminal-Bench 3.0, alguns visuais como o ZeroBench, 49,0 contra 53,0 do GPT-5.6 Sol). A SiliconANGLE conta o Opus-5.0 à frente em 7 dos 11 benchmarks publicados para a atualização.
Modelos base, segundo a ficha do modelo:
| Benchmark | V4-Flash-Base | V4-Pro-Base | V4.1-Flash-Base |
|---|---|---|---|
| MMLU-Pro | 68,3 | 73,5 | 74,1 |
| HumanEval | 69,5 | 76,8 | 79,4 |
| SimpleQA-Verified | 30,1 | 55,2 | 42,3 |
| MATH | 57,4 | 64,5 | 61,1 |
| LongBench-V2 | 44,7 | 51,5 | 45,2 |
O V4-Pro-Base tem 1,6T de parâmetros e continua à frente do V4.1-Flash-Base no SimpleQA-Verified, no MATH e no LongBench-V2.
O que a atualização 1017 muda?
O V4.1-Flash-1017 mantém o id deepseek-flash e os mesmos preços. A DeepSeek informa ganhos da versão de setembro para a 1017: HLE sem ferramentas de 36,8 para 42,6 (44,0 somente em texto), DeepSWE v1.1 de 74,2 para 77,0 e Terminal-Bench 4.0 de 31,2 para 42,3.
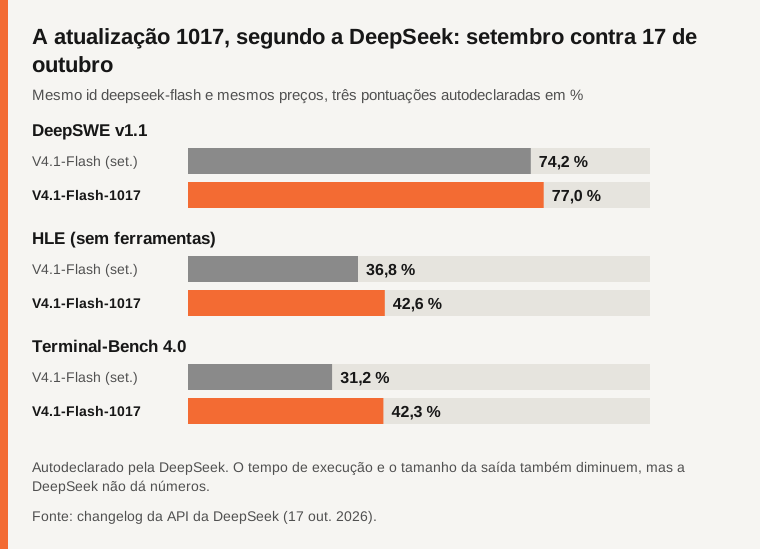
Fonte: changelog da API da DeepSeek (17 de outubro de 2026). Autodeclarado.
O tempo de execução e o tamanho da saída também foram reduzidos, sem números. Recomenda-se o Harness 0.2.1-rc.1 ou posterior, e a SiliconANGLE diz que o modelo foi ajustado para o Harness e para o CodeBuddy e o WorkBuddy da Tencent. A DeepSeek chama o lançamento de uma melhoria de Pareto em desempenho e custo; a Startup Fortune observa que esse é um juízo da própria DeepSeek e que o momento favorece sua pilha interna, embora a licença MIT permita que outros usem o modelo em ferramentas concorrentes. A Neomanex observa que nenhuma versão fixa foi anunciada: execute novamente suas avaliações, pois saídas mais curtas podem quebrar analisadores e orçamentos de tokens.
Quanto custa o raciocínio e como ajustá-lo?
O esforço de raciocínio é ajustável de 1 a 100; na API, max é 100, high é 75 e low é 50, e os resultados do modelo instruct usam 100.
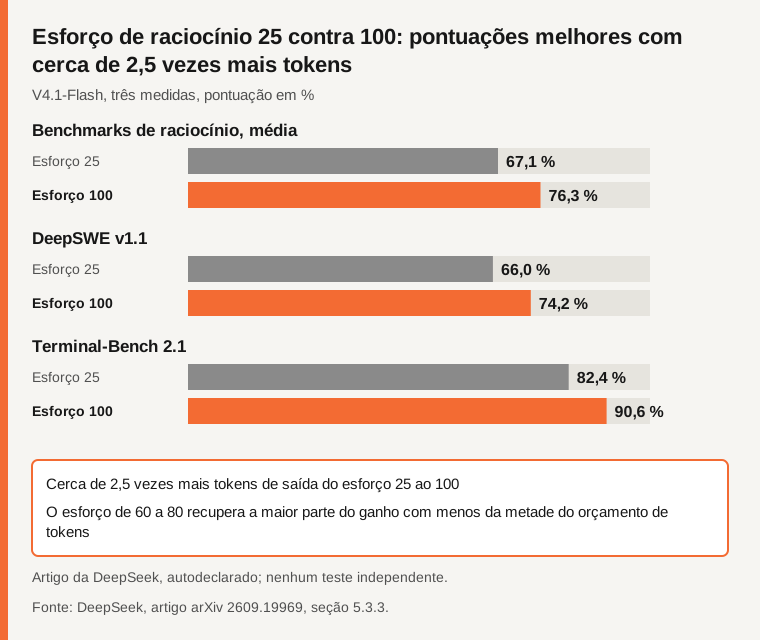
Fonte: artigo arXiv, seção 5.3.3. Autodeclarado.
Ir do esforço 25 ao 100 custa cerca de 2,5 vezes mais tokens de saída; esforços de 60 a 80 capturam a maior parte do ganho com menos da metade dos tokens. O scaffold também importa (DeepSWE v1.1 / Terminal-Bench 2.1, segundo a ficha do modelo): mini-SWE 74,2 / 90,3, DSH Minimal 72,6 / 90,6, DSH Standard 70,5 / 85,8; outros harnesses (Claude Code, Codex, OpenCode, Pi) marcam de 65,5 a 69,8 no DeepSWE, e o Terminal-Bench 2.1 vai de 84,1 (Codex) a 90,6. Com vários agentes, o artigo informa um ProgramBench Almost@1 de 30,04% em 8 horas contra 20,39% com um único agente.
Quanto custa e como usar?
deepseek-flash é o V4.1-Flash-1017; deepseek-v4-pro é o V4-Pro-0813. Os nomes antigos redirecionam para o Flash pelos preços do Flash. Ambos oferecem contexto de 1M, saída máxima de 384K, modos com e sem raciocínio, JSON, chamadas de ferramentas, a API Responses e uma API compatível com a Anthropic; visão apenas no Flash.
| Preço por milhão de tokens | Flash fora do pico | Flash no pico | Pro fora do pico | Pro no pico |
|---|---|---|---|---|
| Entrada, cache hit | US$ 0,003 | US$ 0,006 | US$ 0,022 | US$ 0,044 |
| Entrada, cache miss | US$ 0,15 | US$ 0,30 | US$ 0,66 | US$ 1,32 |
| Saída | US$ 0,60 | US$ 1,20 | US$ 1,98 | US$ 3,96 |
Os horários de pico são das 01:00 às 04:00 e das 06:00 às 10:00 UTC, de segunda a sexta, exceto feriados públicos chineses; o restante é fora do pico.
- API de busca e leitura: US$ 0,75 por 1 000 requisições bem-sucedidas de cada uma, gratuita até 1º de novembro e cobrada por requisição a partir de 00:00 no horário de Pequim de 1º de novembro de 2026. A busca retorna até 50 resultados ordenados; a leitura converte uma página em Markdown (SiliconANGLE). Pode ser chamada no servidor pelo Harness, pelo Claude Code ou pelo Codex.
- DeepSeek Harness: framework oficial de agentes de código aberto (
dsh, MIT), tudo é plugin (adaptadores de modelo, ferramentas, logs, laços de agentes), com interface web; repositório github.com/deepseek-ai/deepseek-harness. As contagens de estrelas relatadas divergem entre as fontes (Startup Fortune, HelloGitHub), por isso não informamos nenhuma. - Executar por conta própria:
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash"(compatível com OpenAI, entrada de imagem) oupython3 -m sglang.launch_server --model-path "deepseek-ai/DeepSeek-V4.1-Flash", ou Transformers comdevice_map="auto". Não há template de chat Jinja: use o Python de referência na pastaencodingou, em produção, a biblioteca Rustdeepseek-recipe. A ficha não indica hardware mínimo.
O que não está estabelecido?
Não existe nenhum teste independente que tenhamos encontrado, e as comparações com o Opus-5.0 e o GPT-5.6 Sol são da DeepSeek. A ficha e o artigo dizem 552B de parâmetros do backbone, enquanto os metadados Safetensors mostram 763B; talvez os 196B do Engram ou o codificador de visão, mas isso não está confirmado. Vazão real, latência e custo de operação não são publicados, as ablações não são quantificadas, o ganho real do DSpark é desconhecido e o hardware mínimo não é indicado. Não medimos o efeito da 1017 em saídas longas.
Tabela comparativa
| Ponto | O que as fontes dizem em 2 de nov. de 2026 | Fonte |
|---|---|---|
| Modelo | MoE multimodal, MIT, contexto de 1M, 8B ativos no prefill / 16B na decodificação | Hugging Face, arXiv |
| Tamanho | 552B de backbone no texto; 763B nos metadados, sem explicação | Hugging Face |
| KV global | 890 bytes por token, cerca de 1/4 do V4-Flash | arXiv |
| KV persistente | Cerca de 1/8 do V4-Flash, via SWA Bounded Replay | arXiv |
| Benchmarks | DeepSWE 74,2 (77,0 na 1017), Terminal-Bench 2.1 90,6; autodeclarados | Hugging Face, changelog |
| Preço | Flash US$ 0,15 / US$ 0,60 fora do pico, US$ 0,30 / US$ 1,20 no pico (cache miss / saída) | Preços da DeepSeek |
| Testes independentes | Nenhum encontrado | n/d |
Perguntas frequentes
O modelo é mesmo 4x mais leve?
Não. Segundo a DeepSeek, é o cache KV global na HBM que tem cerca de um quarto do tamanho do do V4-Flash (890 bytes por token), não o modelo. O texto diz 552B de parâmetros e os metadados 763B, sem explicação.
Posso executá-lo por conta própria?
Os pesos são MIT e a ficha documenta vLLM, SGLang e Transformers. Ela não indica hardware mínimo, então não podemos dizer o que você precisa.
A atualização 1017 muda o preço ou o id?
Não. O id continua deepseek-flash e os preços são idênticos. Nenhuma versão fixa foi anunciada, então execute novamente suas avaliações.
A DeepSeek supera os modelos fechados?
Segundo a DeepSeek, ela está à frente em alguns testes de agentes e atrás em outros (HLE, Terminal-Bench 3.0, alguns testes visuais). Não há teste independente.
Método e limites
Lemos a ficha do modelo no Hugging Face (por meio de um resumo automático, então os números devem ser conferidos), cerca de dois terços do artigo arXiv, o changelog e a página de preços da DeepSeek, além de fontes secundárias de qualidade irregular (Neomanex, HelloGitHub). Não testamos o modelo e não encontramos nenhuma ablação nem medição de vazão no artigo. Não é aconselhamento de compra nem de investimento.
Fontes
- Hugging Face: ficha do modelo DeepSeek-V4.1-Flash (verificado em 2026-11-02)
- arXiv 2609.19969: DeepSeek-V4.1-Flash, Pushing the Limits of KV Cache Compression (verificado em 2026-11-02)
- DeepSeek API: atualizações (changelog) (verificado em 2026-11-02)
- DeepSeek API: modelos e preços (verificado em 2026-11-02)
- SiliconANGLE: DeepSeek releases updated V4.1-Flash model (verificado em 2026-11-02)
- Startup Fortune: DeepSeek ties its new V4.1-Flash-1017 model tighter to its own Harness (verificado em 2026-11-02)
- Neomanex: DeepSeek V4.1-Flash-1017, same Flash id, same price (verificado em 2026-11-02)
- HelloGitHub: deepseek-harness (verificado em 2026-11-02)
Encontrou um erro neste artigo? Avise-nos · Nossa política de correções
