Analyse
Revolut fait de GLM auto-hébergé son choix par défaut pour le code assisté par IA et annonce des coûts en baisse d'environ 90 %, Claude Code et Codex devenant l'exception, selon une conférence rapportée par The Register
Revolut dit faire de GLM auto-hébergé son défaut pour le code par IA, Claude Code devenant l'exception, avec des coûts en baisse de 90 %. Non vérifié.
Le 3 novembre 2026, The Register (Tobias Mann) a rapporté l'intervention de David Abitbol, responsable des opérations et de l'infrastructure de Revolut, à la conférence AI Engineer à New York en octobre 2026. Selon ce compte rendu, Revolut a fait des modèles auto-hébergés son choix par défaut pour le code assisté par IA, plutôt que des services commerciaux comme Claude. Les chiffres sont ceux de Revolut et ne sont pas vérifiés de façon indépendante. Nous n'avons lu les sources que par résumé automatique. Ceci n'est ni un conseil d'investissement ni un conseil juridique.
L'essentiel
- Ce que dit Revolut : GLM de Z.ai (Zhipu) auto-hébergé est le défaut pour environ 2 000 ingénieurs ; Claude Code et Codex sont l'exception (The Register).
- L'affirmation : les coûts d'inférence du code assisté par IA ont baissé d'environ 90 % en moins d'un an, soit 10 fois (The Register).
- Pas une suppression : Claude Code et Codex restent disponibles ; un routeur envoie certaines requêtes à d'autres modèles.
- Non établi : la base de comparaison, l'inclusion du matériel, la version de GLM, toute vérification indépendante.
Ce que Revolut dit avoir changé
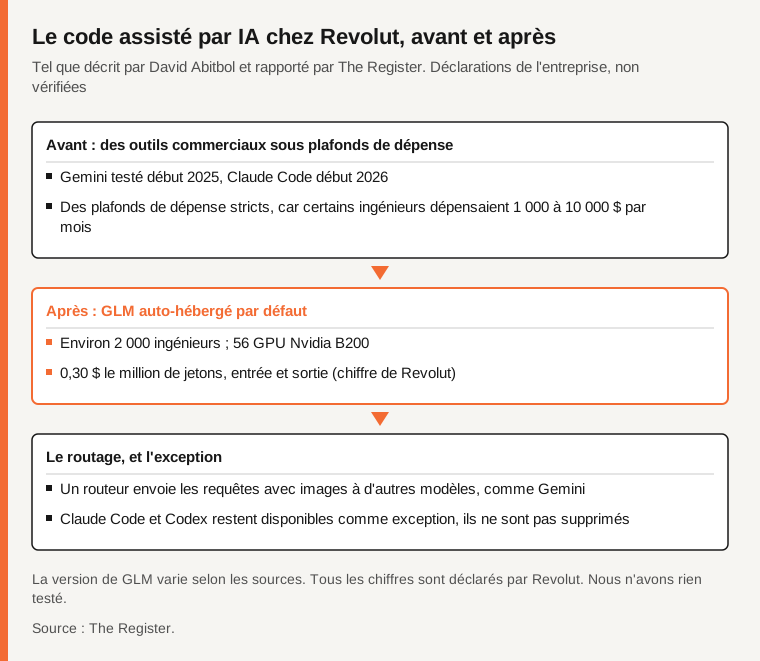
Selon The Register, Revolut a testé Gemini début 2025 et Claude Code début 2026. Les outils ont été lancés avec des plafonds de dépense stricts, car certains ingénieurs dépensaient entre 1 000 et 10 000 $ par mois (Abitbol, via The Register). Revolut est ensuite passé à GLM de Z.ai, d'abord GLM-5.1, puis GLM-5.3. Emergent ne mentionne que GLM-5.3, et un résumé citant StartupHub, que nous n'avons pas lu, parle de GLM 4.5 : nous ne lions donc pas le coût à une version. Pour l'état des modèles ouverts, dont GLM-5.3, voir notre point d'octobre.
Pour GLM-5.3, The Register indique 56 GPU Nvidia B200 (sept systèmes DGX B200), environ 754 milliards de paramètres (environ 40 milliards actifs par jeton) et environ 380 Go de mémoire GPU pour les poids. Les gains viennent du réglage, de la quantification NVFP4 et de la séparation prefill/decode, pas de GPU supplémentaires.
Source : The Register.
Combien, et par rapport à quoi ?
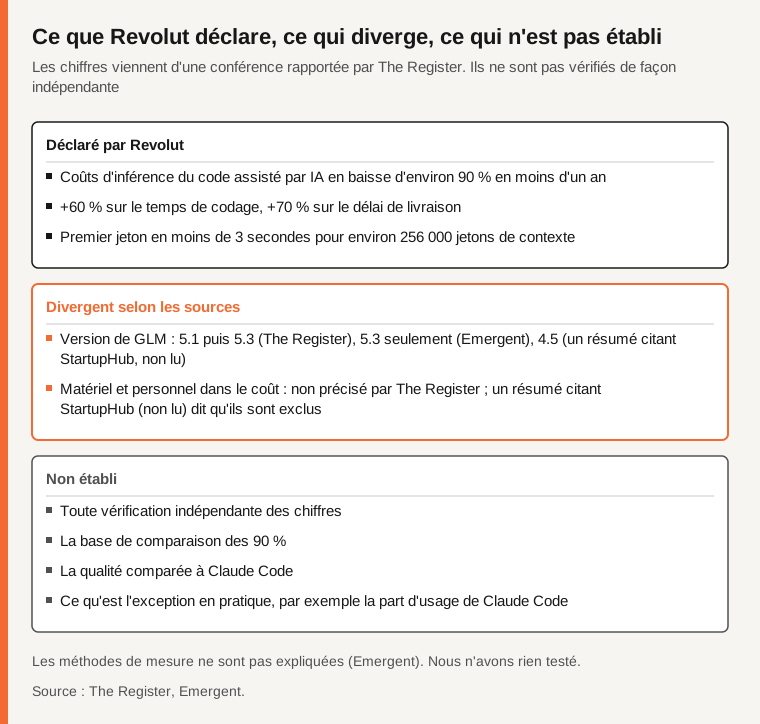
The Register rapporte que l'auto-hébergement de GLM coûte 0,30 $ le million de jetons (entrée et sortie), soit environ un dixième du coût de Codex ou de Claude Code, avec une facturation forfaitaire. Le média ne dit pas si l'amortissement du matériel est inclus. Un résumé citant StartupHub (non lu) dit que les 0,30 $ excluent cloud, personnel et observabilité : l'économie totale pourrait donc être moindre. Emergent note que la base de comparaison n'est pas détaillée.
Revolut déclare aussi un premier jeton en moins de 3 secondes pour environ 256 000 jetons de contexte. Il annonce +60 % sur le temps de codage et +70 % sur le délai de livraison ; selon Abitbol, les gains viennent surtout du débogage et du traitement des tickets Jira et Confluence, pas de la génération de code. Emergent note que les méthodes de mesure ne sont pas expliquées.
Pas un remplacement total
D'après The Register, GLM ne remplace pas entièrement GPT ni Claude. Il est limité au texte et peu adapté au travail d'interface : un routeur envoie donc les requêtes avec images à des modèles comme Gemini, tandis que la génération de code reste sur GLM. Abitbol qualifie les modèles de frontière d'« l'exception ». Ils ne sont pas supprimés, et ce que cela signifie en pratique, par exemple la part d'usage de Claude Code, n'est pas indiqué.
Les réserves
Abitbol reconnaît des inquiétudes de confidentialité et de sécurité sur les modèles ouverts chinois. Selon lui, le principal risque est l'accès via des API hébergées en Chine, et un déploiement sur site ou dans un cloud régional le réduit (The Register). Nous n'ajoutons aucune évaluation.
Source : The Register, Emergent.
Qu'est-ce qui n'est pas établi ?
Le chiffre vérifié et sa base ; l'inclusion du matériel, du personnel et de l'observabilité dans le coût ; la version exacte de GLM ; la qualité comparée à Claude Code, sans test indépendant ; la mesure des +60 % et +70 % ; la réaction d'Anthropic ; si d'autres suivront.
Tableau comparatif
| Point | Ce que disent les sources | Statut |
|---|---|---|
| Défaut pour le code assisté | GLM auto-hébergé ; Claude Code et Codex l'exception | Déclaré par Revolut |
| Coût d'inférence | Environ 90 % de moins en moins d'un an | Déclaré par Revolut |
| Prix de GLM | 0,30 $ le million de jetons, matériel non précisé | Rapporté par The Register |
| Productivité | +60 % temps de codage, +70 % délai de livraison | Déclaré par Revolut |
| Version de GLM | 5.1 puis 5.3, 5.3 seule ou 4.5 selon la source | Divergent |
| Vérification indépendante | Aucune lue | Non établi |
Questions fréquentes
Revolut a-t-il arrêté d'utiliser Claude Code ?
Pas selon The Register : ils restent disponibles comme exception.
Les 90 % sont-ils vérifiés ?
Non. C'est une affirmation de Revolut lors d'une conférence, sans base de comparaison détaillée.
Quel matériel faut-il ?
Revolut indique 56 GPU Nvidia B200 pour GLM-5.3.
Méthode et limites
Nous avons lu The Register par résumé automatique le 4 novembre 2026, plus deux reprises de seconde main. Nous n'avons lu ni la conférence, ni un communiqué de Revolut, ni Cybernews, ni StartupHub, et n'avons vu aucun commentaire d'Anthropic, d'OpenAI ou de Z.ai. Rien n'a été testé.
Sources
- The Register, Tobias Mann, résumé automatique
- Emergent, seconde main, résumé automatique
- Pasquale Pillitteri, seconde main, résumé automatique
Une erreur dans cet article ? Signalez-la · Notre politique de corrections
