Analyse
LeCun et Balestriero rapportent que des JEPA alignent texte et images avec 42 fois moins d'échantillons
Un préprint v1 de Balestriero et LeCun rapporte qu'un encodeur JEPA égale le mot suivant avec 42 fois moins d'échantillons. Résultats des auteurs.
- Modèles
- #JEPA
- #Yann LeCun
- #Randall Balestriero
- #apprentissage de représentations
- #prédiction du mot suivant
- #représentation platonicienne
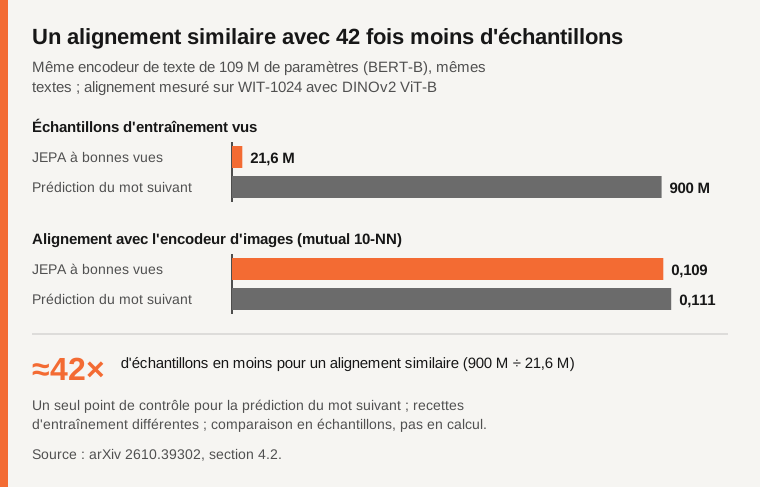
Au 3 novembre 2026, un préprint de Randall Balestriero et Yann LeCun (arXiv 2610.39302, version 1, 29 octobre 2026) rapporte qu'un encodeur de texte entraîné comme un JEPA atteint à peu près le même alignement avec un modèle d'images que la prédiction du mot suivant (0,109 contre 0,111), avec 21,6 millions d'échantillons d'entraînement au lieu de 900 millions, soit environ 42 fois moins. Ce sont des résultats des auteurs, non répliqués de façon indépendante à notre connaissance.
L'essentiel
- Ce que les auteurs prouvent : sous des hypothèses idéalisées, des JEPA entraînés séparément convergent vers la même représentation, à une rotation près.
- Ce que mesure le 42× : des échantillons d'entraînement, à un seul point de contrôle, pour un seul score d'alignement. Ce n'est pas une économie de calcul.
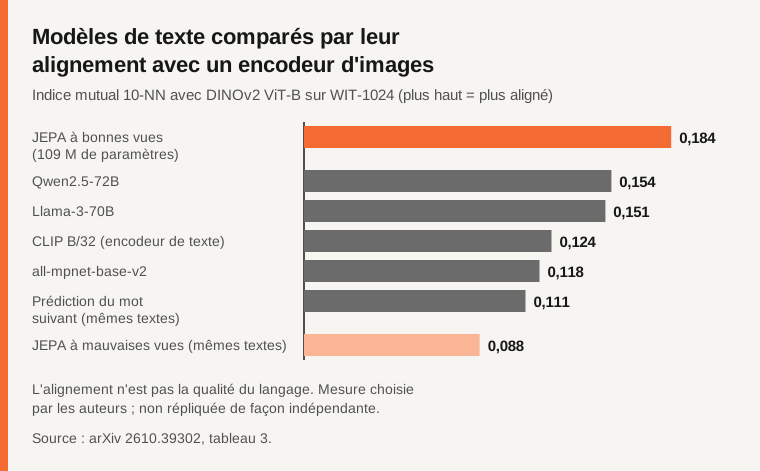
- Ce que montre le tableau 109 M contre 72 Md : un encodeur de texte JEPA de 109 millions de paramètres obtient, sur un indice d'alignement avec les images, un score plus élevé que des modèles de langage de la classe des 70 milliards.
- Ce qui n'est pas établi : que cela améliore la qualité du langage, ou que d'autres équipes obtiennent les mêmes chiffres.
Qu'est-ce que l'hypothèse de représentation platonicienne ?
Cette hypothèse (Huh et al.) dit que des modèles entraînés séparément, même sur des données de nature différente, dérivent vers une image commune du monde. Elle a été observée, pas démontrée. Un JEPA (architecture prédictive à plongement conjoint) entraîne un encodeur de contexte et un encodeur de cible à rapprocher les plongements de deux « vues » liées d'une même chose. Ici, l'« alignement » signifie que les plongements de deux modèles placent les mêmes éléments près des mêmes voisins.
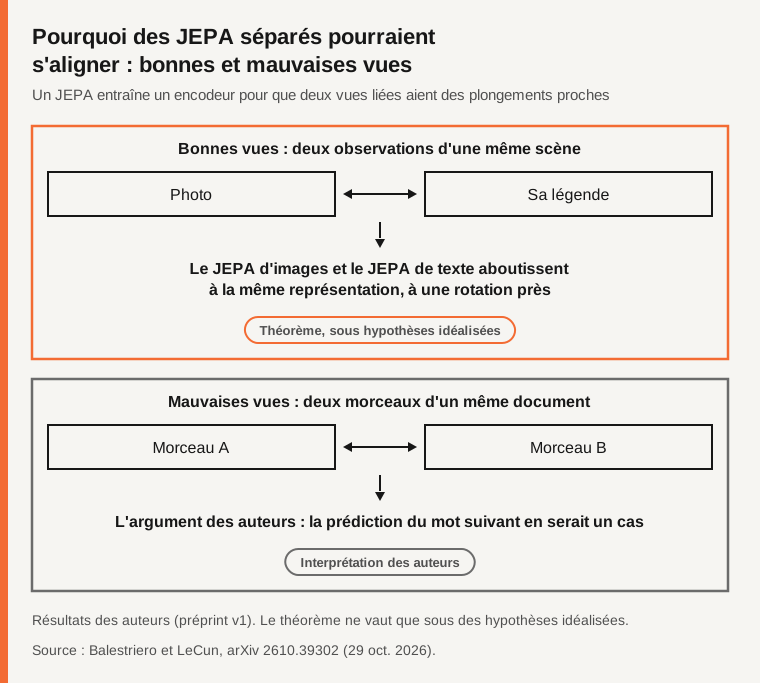
Le théorème principal du préprint dit que si toutes les modalités partagent la même distribution de paires positives, et que les minimiseurs sont uniques à une rotation près, tous les encodeurs coïncident à une rotation près. Environ k paires bien placées suffiraient pour trouver cette rotation.
La distinction qui compte oppose les « bonnes vues » et les « mauvaises vues ». Les bonnes vues sont deux observations d'une même scène, comme une photo et sa légende. Les mauvaises vues sont deux morceaux d'un même document. Les auteurs soutiennent, comme une interprétation qu'ils présentent comme une hypothèse à tester, que la prédiction du mot suivant est un JEPA à mauvaises vues, de sorte que les modèles de langage ne s'aligneraient avec la vision qu'à grande échelle.
Source : Balestriero et LeCun, arXiv 2610.39302.
Le théorème suppose des optimums idéalisés, un monde fini, un prédicteur identité et l'unicité à une rotation près. Il ne couvre pas les JEPA à prédicteur appris.
Que mesure exactement le « 42 fois moins » ?
La comparaison (section 4.2) utilise le même encodeur de texte de 109 millions de paramètres (BERT-B) et les mêmes légendes d'images du web (Recap-DataComp). L'alignement est l'indice mutual 10-NN (10 plus proches voisins mutuels) par rapport à DINOv2 ViT-B sur WIT-1024. Le JEPA à bonnes vues obtient 0,109 après 21,6 millions d'échantillons. La prédiction du mot suivant obtient 0,111 après 900 millions. Le rapport, 900 sur 21,6, vaut environ 42.
Source : arXiv 2610.39302, section 4.2.
Trois réserves tirées du texte. Les deux entraînements utilisent des recettes différentes, avec des taux d'apprentissage et des tailles de lot différents. Il n'y a qu'un seul point de contrôle pour la prédiction du mot suivant, pas une courbe d'apprentissage appariée. Et le décompte est en échantillons, pas en calcul. À échantillons égaux (21,6 millions, avec un encodeur de 33 millions de paramètres), les auteurs rapportent un écart plus grand, 0,108 contre 0,071.
Que donne le comparatif avec les grands modèles de langage ?
Sur le même indice (WIT-1024 avec DINOv2 ViT-B), le tableau 3 des auteurs donne 0,184 pour le JEPA de 109 millions de paramètres, 0,154 pour Qwen2.5-72B et 0,151 pour Llama-3-70B. L'encodeur de texte de CLIP B/32 obtient 0,124, all-mpnet-base-v2 0,118, la prédiction du mot suivant sur les mêmes textes 0,111, et un JEPA à mauvaises vues 0,088.
Source : arXiv 2610.39302, tableau 3.
D'autres mesures vont dans le même sens : un CKA linéaire de 0,507 contre 0,418 pour Qwen2.5-72B, et 0,161 contre 0,108 sur COCO. Mais le JEPA ne gagne pas partout. En recherche d'images sur Flickr (R@1), il obtient 0,478, un peu sous l'encodeur de texte de CLIP (0,489) et all-mpnet (0,481), qui ont été entraînés sur des paires. Le résumé rapporte aussi 64 % de précision top-5 en classification zéro-coup sur ImageNet-100 sans données appariées, contre au plus 56 % pour des modèles de langage jusqu'à 8 milliards de paramètres.
Quelles limites les auteurs reconnaissent-ils ?
Une quatrième graine aléatoire avec un poids SIGReg doublé a donné 0,121, ce qui ramène la moyenne des quatre graines à 0,168, encore au-dessus de tous les modèles de langage du tableau. Le modèle qui a écrit la plupart des légendes voit les images à travers CLIP ViT-L/14. Au moins 43 des 1 024 légendes de WIT figurent dans les textes d'entraînement, même si les retirer change le score de moins de 0,002. Le JEPA à mauvaises vues à 940 millions d'échantillons n'a qu'une seule graine. Trois des 36 exécutions se sont effondrées sans écrêtage des gradients.
Qu'est-ce qui n'est pas établi ?
Que l'alignement avec la vision améliore la qualité du langage ou du raisonnement. Que le résultat tienne avec d'autres recettes, jeux de données ou métriques. La réplication indépendante et l'évaluation par les pairs, que nous n'avons pas vues. Le calcul total, puisque les comparaisons sont en échantillons. Startup Fortune (1er novembre) a relayé les chiffres ; c'est une source de presse unique.
Tableau comparatif
| Point | Ce que disent les sources au 3 novembre 2026 | Source |
|---|---|---|
| Théorème | Des JEPA entraînés séparément coïncident à une rotation près, sous des hypothèses idéalisées | arXiv 2610.39302 |
| 42× | 21,6 M d'échantillons à 0,109 contre 900 M à 0,111 ; un point de contrôle, recettes différentes | arXiv 2610.39302 |
| 109 M contre 72 Md | Mutual 10-NN 0,184 contre 0,154 (Qwen2.5-72B), par rapport à DINOv2 ViT-B | arXiv 2610.39302 |
| Réplication | Aucune rapportée à notre connaissance ; préprint v1 | arXiv, Startup Fortune |
Questions fréquentes
JEPA bat-il les grands modèles de langage ?
Non établi. La mesure est l'alignement avec des encodeurs d'images, pas la qualité du langage.
Le 42× est-il une économie de calcul ?
Non. Il compte des échantillons d'entraînement, à un seul point de contrôle, avec des recettes différentes.
Le résultat a-t-il été reproduit ?
Pas à notre connaissance. Il s'agit de la version 1 d'un préprint.
Méthode et limites
Nous avons lu le préprint le 3 novembre 2026 à travers des résumés automatiques du résumé et de la version HTML, soit environ 100 000 des 255 000 caractères. Les sections 6 et 7, les annexes et la fin de la 5.2 n'ont pas été lues. Nous n'avons réalisé aucun test, n'avons trouvé aucune vérification indépendante et ne donnons aucun conseil d'investissement.
Sources
- Balestriero et LeCun, Proving and Improving the Platonic Representation Hypothesis with JEPAs, arXiv 2610.39302 (29 octobre 2026) (vérifié le 2026-11-03)
- arXiv 2610.39302, version HTML (vérifié le 2026-11-03)
- Startup Fortune (1er novembre 2026), source secondaire (vérifié le 2026-11-03)
Une erreur dans cet article ? Signalez-la · Notre politique de corrections
