Análise
LeCun e Balestriero relatam JEPAs que alinham texto e imagens com 42 vezes menos amostras
Preprint v1 de Balestriero e LeCun relata que JEPA de texto iguala o alinhamento do próximo token com 42 vezes menos amostras. Resultados dos autores.
- Modelos
- #JEPA
- #Yann LeCun
- #Randall Balestriero
- #aprendizado de representações
- #previsão do próximo token
- #representação platônica
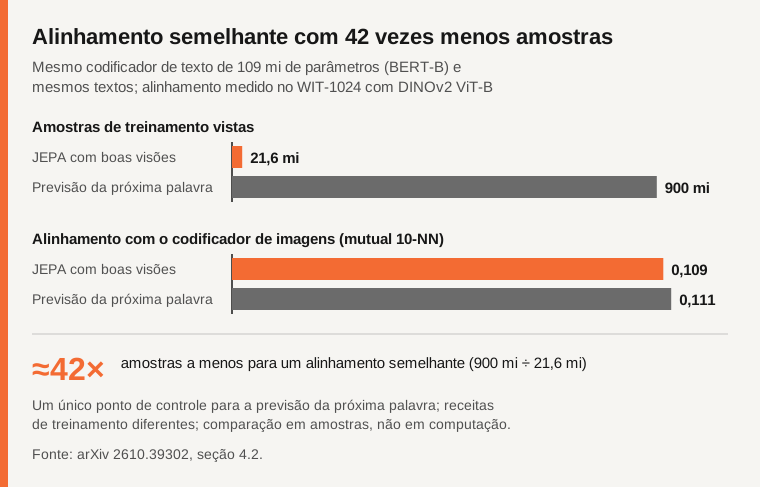
Em 3 de novembro de 2026, um preprint de Randall Balestriero e Yann LeCun (arXiv 2610.39302, versão 1, 29 de outubro de 2026) relata que um codificador de texto treinado como JEPA atinge praticamente o mesmo alinhamento com um modelo de imagens que a previsão do próximo token (0,109 contra 0,111), usando 21,6 milhões de amostras de treinamento em vez de 900 milhões, cerca de 42 vezes menos. São resultados dos autores, não replicados de forma independente, até onde sabemos.
O essencial
- O que os autores provam: sob hipóteses idealizadas, JEPAs treinados separadamente convergem para a mesma representação, a menos de uma rotação.
- O que o 42x mede: amostras de treinamento em um único ponto de controle, para uma única pontuação de alinhamento. Não é uma economia de computação.
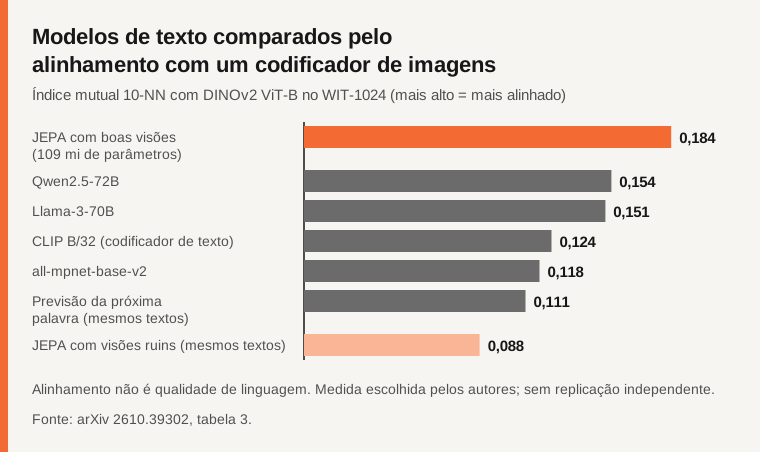
- O que a tabela de 109M contra 72B mostra: um codificador de texto JEPA de 109 milhões de parâmetros obtém, em um índice de alinhamento com imagens, pontuação maior que a de modelos de linguagem da classe de 70 bilhões.
- O que não está estabelecido: que isso melhore a qualidade da linguagem, ou que outras equipes obtenham os mesmos números.
O que é a hipótese da representação platônica?
A hipótese (Huh et al.) afirma que modelos treinados separadamente, mesmo em tipos de dados diferentes, tendem a um mesmo retrato do mundo. Ela foi observada, não provada. Um JEPA (arquitetura preditiva de incorporação conjunta, do inglês joint-embedding predictive architecture) treina um codificador de contexto e um codificador de alvo para aproximar os embeddings de duas "vistas" relacionadas de uma mesma coisa. "Alinhamento" aqui significa que os embeddings de dois modelos colocam os mesmos itens perto dos mesmos vizinhos.
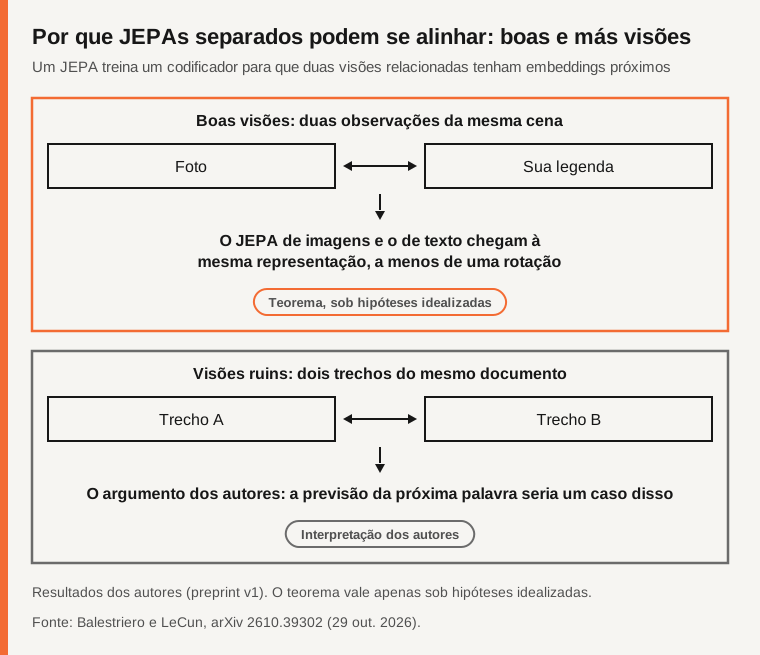
O teorema principal do preprint diz que, se todas as modalidades compartilham a mesma distribuição de pares positivos e os minimizadores são únicos a menos de uma rotação, todos os codificadores coincidem a menos de uma rotação. Cerca de k pares bem posicionados bastariam para encontrar essa rotação.
A distinção que importa é entre "boas vistas" e "más vistas". Boas vistas são duas observações de uma mesma cena, como uma foto e sua legenda. Más vistas são dois trechos de um mesmo documento. Os autores argumentam, como uma interpretação que eles apresentam como hipótese a testar, que a previsão do próximo token é um JEPA com más vistas, de modo que os modelos de linguagem só se alinhariam com a visão em grande escala.
Fonte: Balestriero e LeCun, arXiv 2610.39302.
O teorema supõe ótimos idealizados, um mundo finito, um preditor identidade e unicidade a menos de uma rotação. Ele não cobre JEPAs com preditor aprendido.
O que exatamente mede o "42 vezes menos"?
A comparação (seção 4.2) usa o mesmo codificador de texto de 109 milhões de parâmetros (BERT-B) e as mesmas legendas de imagens da web (Recap-DataComp). O alinhamento é o índice mutual 10-NN em relação ao DINOv2 ViT-B no WIT-1024. O JEPA com boas vistas obtém 0,109 após 21,6 milhões de amostras. A previsão do próximo token obtém 0,111 após 900 milhões. A razão, 900 sobre 21,6, é cerca de 42.
Fonte: arXiv 2610.39302, seção 4.2.
Três ressalvas do texto. As duas execuções usam receitas diferentes, com taxas de aprendizado e tamanhos de lote diferentes. Há um único ponto de controle para a previsão do próximo token, e não uma curva de aprendizado pareada. E a contagem é em amostras, não em computação. Com amostras iguais (21,6 milhões, com um codificador de 33 milhões de parâmetros), os autores relatam uma diferença maior, 0,108 contra 0,071.
Como ele se compara com os grandes modelos de linguagem?
No mesmo índice (WIT-1024 com DINOv2 ViT-B), a tabela 3 dos autores dá 0,184 para o JEPA de 109 milhões de parâmetros, 0,154 para o Qwen2.5-72B e 0,151 para o Llama-3-70B. O codificador de texto do CLIP B/32 obtém 0,124, o all-mpnet-base-v2 0,118, a previsão do próximo token sobre os mesmos textos 0,111 e um JEPA com más vistas 0,088.
Fonte: arXiv 2610.39302, tabela 3.
Outras medidas apontam na mesma direção: CKA linear de 0,507 contra 0,418 para o Qwen2.5-72B, e 0,161 contra 0,108 no COCO. Mas o JEPA não vence em tudo. Na recuperação de imagens do Flickr (R@1), ele obtém 0,478, um pouco abaixo do codificador de texto do CLIP (0,489) e do all-mpnet (0,481), que foram treinados com pares. O resumo também relata 64% de acurácia top-5 em classificação zero-shot no ImageNet-100 sem dados pareados, contra no máximo 56% para modelos de linguagem de até 8 bilhões de parâmetros.
Que limites os autores reconhecem?
Uma quarta semente aleatória com o peso do SIGReg dobrado deu 0,121, o que leva a média das quatro sementes a 0,168, ainda acima de todos os modelos de linguagem da tabela. O modelo que escreveu a maior parte das legendas vê as imagens por meio do CLIP ViT-L/14. Pelo menos 43 das 1 024 legendas do WIT aparecem nos textos de treinamento, embora retirá-las altere a pontuação em menos de 0,002. O JEPA com más vistas a 940 milhões de amostras é uma única semente. Três de 36 execuções colapsaram sem recorte de gradiente.
O que não está estabelecido?
Que o alinhamento com a visão melhore a qualidade da linguagem ou do raciocínio. Que o resultado se mantenha com outras receitas, conjuntos de dados ou métricas. Replicação independente e revisão por pares, que não vimos. A computação total, já que as comparações são em amostras. A Startup Fortune (1º de novembro) repercutiu os números; é uma única fonte da imprensa.
Tabela comparativa
| Ponto | O que as fontes dizem em 3 de nov. de 2026 | Fonte |
|---|---|---|
| Teorema | JEPAs treinados separadamente coincidem a menos de uma rotação, sob hipóteses idealizadas | arXiv 2610.39302 |
| 42x | 21,6M de amostras a 0,109 contra 900M a 0,111; um ponto de controle, receitas diferentes | arXiv 2610.39302 |
| 109M contra 72B | Mutual 10-NN 0,184 contra 0,154 (Qwen2.5-72B), em relação ao DINOv2 ViT-B | arXiv 2610.39302 |
| Replicação | Nenhuma relatada, até onde sabemos; preprint v1 | arXiv, Startup Fortune |
Perguntas frequentes
O JEPA supera os grandes modelos de linguagem?
Não está estabelecido. A medida é o alinhamento com codificadores de imagens, não a qualidade da linguagem.
O 42x é uma economia de computação?
Não. Ele conta amostras de treinamento, em um único ponto de controle, com receitas diferentes.
O resultado foi reproduzido?
Não, até onde sabemos. Esta é a versão 1 de um preprint.
Método e limites
Lemos o preprint em 3 de novembro de 2026 por meio de resumos automáticos do resumo e da versão HTML, cerca de 100 000 de 255 000 caracteres. As seções 6 e 7, os apêndices e o fim da 5.2 não foram lidos. Não executamos testes, não encontramos verificação independente e não damos conselho de investimento.
Fontes
- Balestriero e LeCun, Proving and Improving the Platonic Representation Hypothesis with JEPAs, arXiv 2610.39302 (29 de outubro de 2026) (verificado em 2026-11-03)
- arXiv 2610.39302, versão HTML (verificado em 2026-11-03)
- Startup Fortune (1º de novembro de 2026), fonte secundária (verificado em 2026-11-03)
Encontrou um erro neste artigo? Avise-nos · Nossa política de correções
