Análisis
LeCun y Balestriero informan de que unos JEPA alinean texto e imágenes con 42 veces menos muestras
Un preprint v1 de Balestriero y LeCun informa de un JEPA que iguala la palabra siguiente con 42 veces menos muestras. Resultados de los autores.
- Modelos
- #JEPA
- #Yann LeCun
- #Randall Balestriero
- #aprendizaje de representaciones
- #predicción de la palabra siguiente
- #representación platónica
A 3 de noviembre de 2026, un preprint de Randall Balestriero y Yann LeCun (arXiv 2610.39302, versión 1, 29 de octubre de 2026) informa de que un codificador de texto entrenado como JEPA alcanza casi el mismo alineamiento con un modelo de imágenes que la predicción de la palabra siguiente (0,109 frente a 0,111), con 21,6 millones de muestras de entrenamiento en lugar de 900 millones, unas 42 veces menos. Son resultados de los autores, no replicados de forma independiente que sepamos.
Lo esencial
- Lo que demuestran los autores: bajo supuestos idealizados, unos JEPA entrenados por separado convergen en la misma representación, salvo una rotación.
- Lo que mide el 42×: muestras de entrenamiento, en un solo punto de control, para una sola puntuación de alineamiento. No es un ahorro de cómputo.
- Lo que muestra la tabla de 109 M frente a 72 Md: un codificador de texto JEPA de 109 millones de parámetros obtiene, en un índice de alineamiento con imágenes, una puntuación más alta que modelos de lenguaje de la clase de 70 mil millones.
- Lo que no está establecido: que esto mejore la calidad del lenguaje, o que otros equipos obtengan las mismas cifras.
¿Qué es la hipótesis de la representación platónica?
Esta hipótesis (Huh et al.) sostiene que los modelos entrenados por separado, incluso con datos de distinta naturaleza, derivan hacia una imagen común del mundo. Se ha observado, no demostrado. Un JEPA (arquitectura predictiva de incrustación conjunta) entrena un codificador de contexto y un codificador de destino para acercar las incrustaciones de dos «vistas» relacionadas de una misma cosa. Aquí, «alineamiento» significa que las incrustaciones de dos modelos sitúan los mismos elementos cerca de los mismos vecinos.
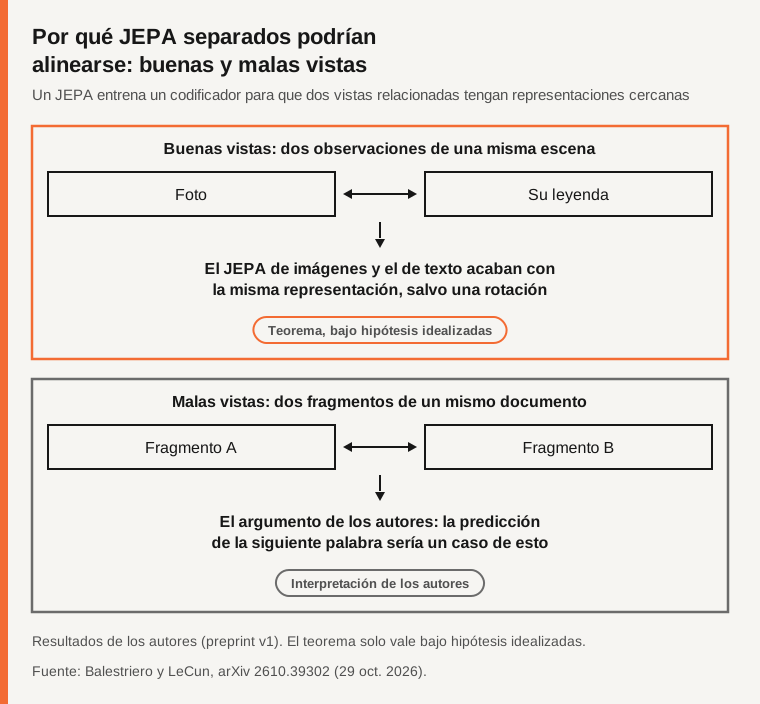
El teorema principal del preprint dice que, si todas las modalidades comparten la misma distribución de pares positivos y los minimizadores son únicos salvo una rotación, todos los codificadores coinciden salvo una rotación. Unos k pares bien colocados bastarían para encontrar esa rotación.
La distinción que importa es entre «buenas vistas» y «malas vistas». Las buenas vistas son dos observaciones de una misma escena, como una foto y su pie de foto. Las malas vistas son dos fragmentos de un mismo documento. Los autores sostienen, como una interpretación que presentan como hipótesis por comprobar, que la predicción de la palabra siguiente es un JEPA con malas vistas, de modo que los modelos de lenguaje solo se alinearían con la visión a gran escala.
Fuente: Balestriero y LeCun, arXiv 2610.39302.
El teorema supone óptimos idealizados, un mundo finito, un predictor identidad y unicidad salvo una rotación. No cubre los JEPA con predictor aprendido.
¿Qué mide exactamente el «42 veces menos»?
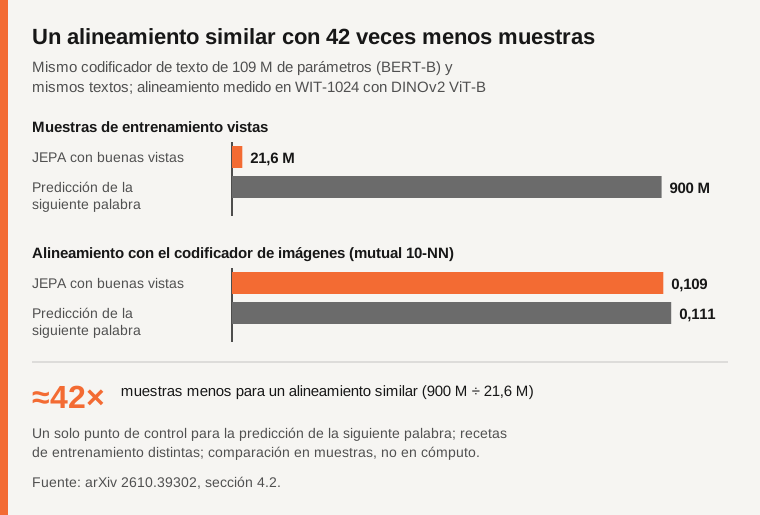
La comparación (sección 4.2) usa el mismo codificador de texto de 109 millones de parámetros (BERT-B) y los mismos pies de foto de imágenes de la web (Recap-DataComp). El alineamiento es el índice mutual 10-NN (10 vecinos más cercanos mutuos) frente a DINOv2 ViT-B en WIT-1024. El JEPA con buenas vistas obtiene 0,109 tras 21,6 millones de muestras. La predicción de la palabra siguiente obtiene 0,111 tras 900 millones. La razón, 900 entre 21,6, es de unas 42.
Fuente: arXiv 2610.39302, sección 4.2.
Tres salvedades del texto. Los dos entrenamientos usan recetas distintas, con tasas de aprendizaje y tamaños de lote diferentes. Hay un solo punto de control para la predicción de la palabra siguiente, no una curva de aprendizaje emparejada. Y el recuento es en muestras, no en cómputo. Con muestras iguales (21,6 millones, con un codificador de 33 millones de parámetros), los autores informan de una brecha mayor, 0,108 frente a 0,071.
¿Qué resultado da la comparación con los grandes modelos de lenguaje?
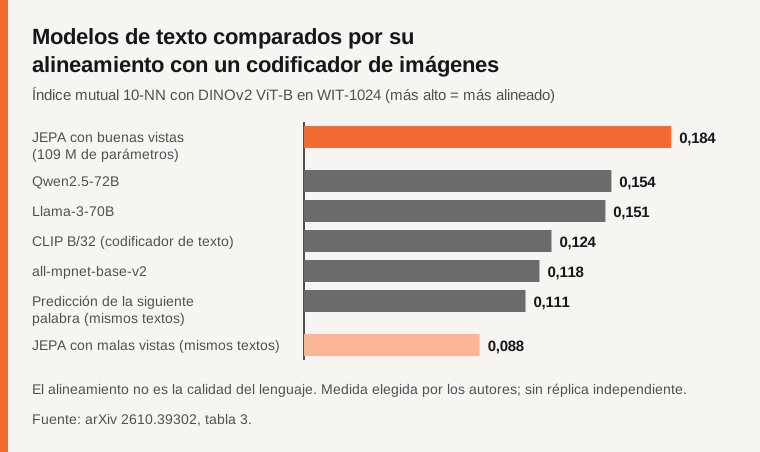
En el mismo índice (WIT-1024 con DINOv2 ViT-B), la tabla 3 de los autores da 0,184 para el JEPA de 109 millones de parámetros, 0,154 para Qwen2.5-72B y 0,151 para Llama-3-70B. El codificador de texto de CLIP B/32 obtiene 0,124, all-mpnet-base-v2 0,118, la predicción de la palabra siguiente sobre los mismos textos 0,111 y un JEPA con malas vistas 0,088.
Fuente: arXiv 2610.39302, tabla 3.
Otras medidas apuntan en la misma dirección: un CKA lineal de 0,507 frente a 0,418 para Qwen2.5-72B, y 0,161 frente a 0,108 en COCO. Pero el JEPA no gana en todo. En la recuperación de imágenes de Flickr (R@1) obtiene 0,478, algo por debajo del codificador de texto de CLIP (0,489) y de all-mpnet (0,481), que se entrenaron con pares. El resumen también informa de un 64 % de precisión top-5 en clasificación de cero disparos en ImageNet-100 sin datos emparejados, frente a un máximo del 56 % de los modelos de lenguaje de hasta 8 mil millones de parámetros.
¿Qué límites reconocen los autores?
Una cuarta semilla aleatoria con el peso de SIGReg duplicado dio 0,121, lo que lleva la media de las cuatro semillas a 0,168, todavía por encima de todos los modelos de lenguaje de la tabla. El modelo que escribió la mayoría de los pies de foto ve las imágenes a través de CLIP ViT-L/14. Al menos 43 de los 1.024 pies de foto de WIT aparecen en los textos de entrenamiento, aunque retirarlos cambia la puntuación en menos de 0,002. El JEPA con malas vistas a 940 millones de muestras tiene una sola semilla. Tres de 36 ejecuciones colapsaron sin recorte de gradientes.
¿Qué no está establecido?
Que el alineamiento con la visión mejore la calidad del lenguaje o del razonamiento. Que el resultado se mantenga con otras recetas, conjuntos de datos o métricas. La replicación independiente y la revisión por pares, que no hemos visto. El cómputo total, ya que las comparaciones son en muestras. Startup Fortune (1 de noviembre) retransmitió las cifras; es una única fuente de prensa.
Tabla comparativa
| Punto | Lo que dicen las fuentes a 3 de noviembre de 2026 | Fuente |
|---|---|---|
| Teorema | Unos JEPA entrenados por separado coinciden salvo una rotación, bajo supuestos idealizados | arXiv 2610.39302 |
| 42× | 21,6 M de muestras a 0,109 frente a 900 M a 0,111; un punto de control, recetas distintas | arXiv 2610.39302 |
| 109 M frente a 72 Md | Mutual 10-NN 0,184 frente a 0,154 (Qwen2.5-72B), frente a DINOv2 ViT-B | arXiv 2610.39302 |
| Replicación | Ninguna informada que sepamos; preprint v1 | arXiv, Startup Fortune |
Preguntas frecuentes
¿Supera JEPA a los grandes modelos de lenguaje?
No está establecido. La medida es el alineamiento con codificadores de imágenes, no la calidad del lenguaje.
¿Es el 42× un ahorro de cómputo?
No. Cuenta muestras de entrenamiento, en un solo punto de control, con recetas distintas.
¿Se ha reproducido el resultado?
Que sepamos, no. Es la versión 1 de un preprint.
Método y límites
Leímos el preprint el 3 de noviembre de 2026 a través de resúmenes automáticos del resumen y de la versión HTML, unos 100.000 de 255.000 caracteres. Las secciones 6 y 7, los apéndices y el final de la 5.2 no se leyeron. No hicimos ninguna prueba, no encontramos ninguna verificación independiente y no damos consejo de inversión.
Fuentes
- Balestriero y LeCun, Proving and Improving the Platonic Representation Hypothesis with JEPAs, arXiv 2610.39302 (29 de octubre de 2026) (verificado el 2026-11-03)
- arXiv 2610.39302, versión HTML (verificado el 2026-11-03)
- Startup Fortune (1 de noviembre de 2026), fuente secundaria (verificado el 2026-11-03)
¿Ha detectado un error en este artículo? Comuníquenoslo · Nuestra política de correcciones
