Analyse
LeCun und Balestriero berichten, dass JEPAs Text und Bilder mit 42-mal weniger Beispielen angleichen
Ein arXiv-Preprint (v1) von Balestriero und LeCun berichtet einen JEPA-Textencoder mit gleicher Bildangleichung bei 42-mal weniger Beispielen.
- Modelle
- #JEPA
- #Yann LeCun
- #Randall Balestriero
- #Repräsentationslernen
- #Next-Token-Vorhersage
- #platonische Repräsentation
Stand 3. November 2026 berichtet ein Preprint von Randall Balestriero und Yann LeCun (arXiv 2610.39302, Version 1, 29. Oktober 2026), dass ein als JEPA trainierter Textencoder ungefähr dieselbe Angleichung an ein Bildmodell erreicht wie die Vorhersage des nächsten Tokens (0,109 gegenüber 0,111), mit 21,6 Millionen Trainingsbeispielen statt 900 Millionen, also etwa 42-mal weniger. Das sind Ergebnisse der Autoren, nach unserer Kenntnis nicht unabhängig repliziert.
Das Wesentliche
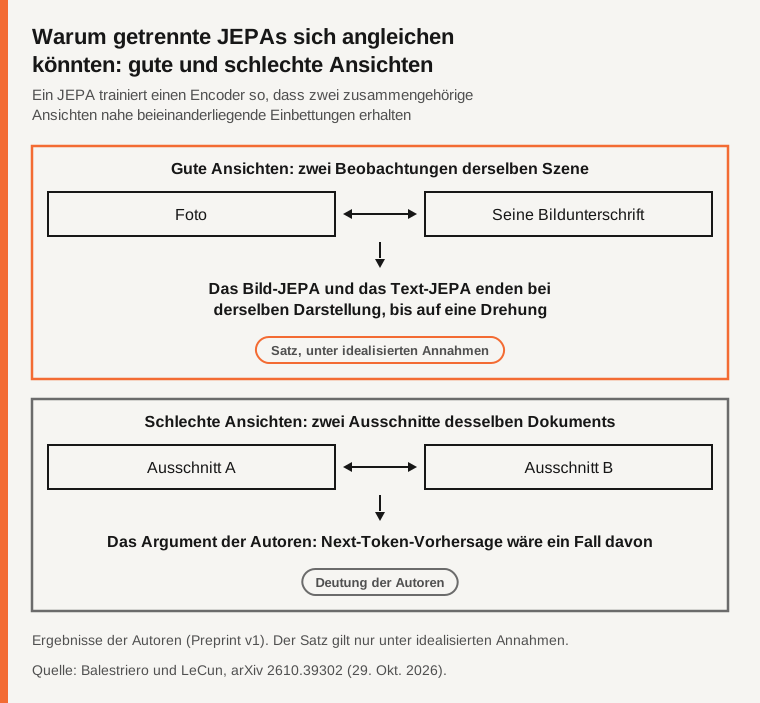
- Was die Autoren beweisen: Unter idealisierten Annahmen konvergieren getrennt trainierte JEPAs bis auf eine Rotation zur selben Repräsentation.
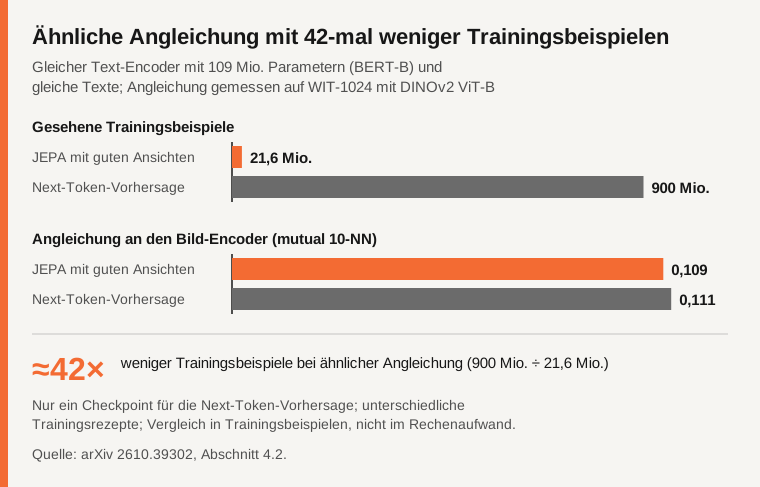
- Was der Faktor 42 misst: Trainingsbeispiele an einem Checkpoint, für einen Angleichungswert. Es ist keine Rechenersparnis.
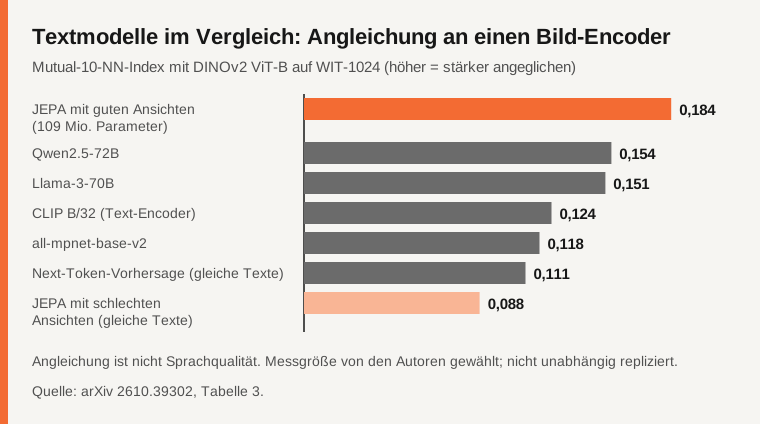
- Was die Tabelle 109M gegenüber 72B zeigt: Ein JEPA-Textencoder mit 109 Millionen Parametern erreicht auf einem Bildangleichungsindex einen höheren Wert als Sprachmodelle der 70-Milliarden-Klasse.
- Was nicht belegt ist: dass dies die Sprachqualität verbessert oder dass andere Teams dieselben Zahlen erhalten.
Was ist die Hypothese der platonischen Repräsentation?
Die Hypothese (Huh et al.) besagt, dass getrennt trainierte Modelle, selbst auf verschiedenen Datenarten, einem gemeinsamen Bild der Welt zustreben. Sie wurde beobachtet, nicht bewiesen. Eine JEPA (joint-embedding predictive architecture, prädiktive Architektur mit gemeinsamem Embedding) trainiert einen Kontextencoder und einen Zielencoder darauf, die Embeddings zweier zusammengehöriger „Sichten“ derselben Sache nahe beieinander zu platzieren. „Angleichung“ bedeutet hier, dass die Embeddings zweier Modelle dieselben Elemente neben dieselben Nachbarn setzen.
Der Haupt-Satz des Preprints besagt: Teilt jede Modalität dieselbe Verteilung positiver Paare und sind die Minimierer bis auf eine Rotation eindeutig, stimmen alle Encoder bis auf eine Rotation überein. Etwa k gut platzierte Paare würden genügen, um diese Rotation zu finden.
Entscheidend ist der Unterschied zwischen „guten Sichten“ und „schlechten Sichten“. Gute Sichten sind zwei Beobachtungen einer Szene, etwa ein Foto und seine Bildunterschrift. Schlechte Sichten sind zwei Teile eines Dokuments. Die Autoren argumentieren, als Interpretation, die sie als zu prüfende Hypothese darstellen, dass die Vorhersage des nächsten Tokens eine JEPA mit schlechten Sichten sei, sodass sich Sprachmodelle erst im großen Maßstab an das Sehen angleichen würden.
Quelle: Balestriero und LeCun, arXiv 2610.39302.
Der Satz setzt idealisierte Optima, eine endliche Welt, einen Identitäts-Prädiktor und Eindeutigkeit bis auf eine Rotation voraus. Er gilt nicht für JEPAs mit gelerntem Prädiktor.
Was misst „42-mal weniger“ genau?
Der Vergleich (Abschnitt 4.2) verwendet denselben Textencoder mit 109 Millionen Parametern (BERT-B) und dieselben Web-Bildunterschriften (Recap-DataComp). Die Angleichung ist der Index mutual 10-NN (gegenseitige 10 nächste Nachbarn) gegenüber DINOv2 ViT-B auf WIT-1024. Die JEPA mit guten Sichten erreicht nach 21,6 Millionen Beispielen 0,109. Die Next-Token-Vorhersage erreicht nach 900 Millionen 0,111. Das Verhältnis, 900 durch 21,6, ist etwa 42.
Quelle: arXiv 2610.39302, Abschnitt 4.2.
Drei Vorbehalte aus dem Text. Die beiden Läufe nutzen unterschiedliche Rezepte, mit verschiedenen Lernraten und Batchgrößen. Für die Next-Token-Vorhersage gibt es nur einen Checkpoint, keine vergleichbare Lernkurve. Und gezählt wird in Beispielen, nicht im Rechenaufwand. Bei gleicher Beispielzahl (21,6 Millionen, mit einem Encoder von 33 Millionen Parametern) berichten die Autoren einen größeren Abstand, 0,108 gegenüber 0,071.
Wie schneidet sie im Vergleich mit großen Sprachmodellen ab?
Auf demselben Index (WIT-1024 mit DINOv2 ViT-B) nennt die Tabelle 3 der Autoren 0,184 für die JEPA mit 109 Millionen Parametern, 0,154 für Qwen2.5-72B und 0,151 für Llama-3-70B. Der Textencoder von CLIP B/32 kommt auf 0,124, all-mpnet-base-v2 auf 0,118, die Next-Token-Vorhersage auf denselben Texten auf 0,111 und eine JEPA mit schlechten Sichten auf 0,088.
Quelle: arXiv 2610.39302, Tabelle 3.
Andere Maße gehen in dieselbe Richtung: lineares CKA von 0,507 gegenüber 0,418 für Qwen2.5-72B und 0,161 gegenüber 0,108 auf COCO. Aber die JEPA gewinnt nicht überall. Bei der Bildsuche auf Flickr (R@1) erreicht sie 0,478, knapp unter dem Textencoder von CLIP (0,489) und all-mpnet (0,481), die auf Paaren trainiert wurden. Die Zusammenfassung nennt außerdem 64 % Top-5-Genauigkeit im Zero-Shot auf ImageNet-100 ohne gepaarte Daten, gegenüber höchstens 56 % für Sprachmodelle bis 8 Milliarden Parameter.
Welche Grenzen räumen die Autoren ein?
Ein vierter Zufalls-Seed mit verdoppeltem SIGReg-Gewicht ergab 0,121, was den Mittelwert über vier Seeds auf 0,168 bringt, weiterhin über jedem Sprachmodell der Tabelle. Das Modell, das die meisten Bildunterschriften schrieb, sieht Bilder über CLIP ViT-L/14. Mindestens 43 der 1.024 WIT-Unterschriften kommen in den Trainingstexten vor, auch wenn ihre Entfernung den Wert um weniger als 0,002 verändert. Die JEPA mit schlechten Sichten bei 940 Millionen Beispielen ist ein einzelner Seed. Drei von 36 Läufen sind ohne Gradient Clipping kollabiert.
Was ist nicht belegt?
Dass die Angleichung an das Sehen die Qualität von Sprache oder Schlussfolgern verbessert. Dass das Ergebnis mit anderen Rezepten, Datensätzen oder Metriken gilt. Unabhängige Replikation und Begutachtung, die wir nicht gesehen haben. Der gesamte Rechenaufwand, da die Vergleiche in Beispielen erfolgen. Startup Fortune (1. November) gab die Zahlen weiter; das ist eine einzige Pressequelle.
Vergleichstabelle
| Punkt | Was die Quellen am 3. Nov. 2026 sagen | Quelle |
|---|---|---|
| Satz | Getrennt trainierte JEPAs stimmen bis auf eine Rotation überein, unter idealisierten Annahmen | arXiv 2610.39302 |
| 42x | 21,6 Mio. Beispiele bei 0,109 gegenüber 900 Mio. bei 0,111; ein Checkpoint, unterschiedliche Rezepte | arXiv 2610.39302 |
| 109M gegenüber 72B | Mutual 10-NN 0,184 gegenüber 0,154 (Qwen2.5-72B), gegenüber DINOv2 ViT-B | arXiv 2610.39302 |
| Replikation | Nach unserer Kenntnis keine gemeldet; Preprint v1 | arXiv, Startup Fortune |
Häufige Fragen
Schlägt JEPA große Sprachmodelle?
Nicht belegt. Gemessen wird die Angleichung an Bildencoder, nicht die Sprachqualität.
Ist der Faktor 42 eine Rechenersparnis?
Nein. Er zählt Trainingsbeispiele, an einem einzigen Checkpoint, mit unterschiedlichen Rezepten.
Wurde das Ergebnis reproduziert?
Nicht nach unserer Kenntnis. Es ist Version 1 eines Preprints.
Methode und Grenzen
Wir haben den Preprint am 3. November 2026 über automatische Zusammenfassungen der Zusammenfassung und der HTML-Version gelesen, etwa 100.000 von 255.000 Zeichen. Die Abschnitte 6 und 7, die Anhänge und das Ende von 5.2 wurden nicht gelesen. Wir haben keine Tests durchgeführt, keine unabhängige Überprüfung gefunden und geben keine Anlageberatung.
Quellen
- Balestriero und LeCun, Proving and Improving the Platonic Representation Hypothesis with JEPAs, arXiv 2610.39302 (29. Oktober 2026) (geprüft am 03.11.2026)
- arXiv 2610.39302, HTML-Version (geprüft am 03.11.2026)
- Startup Fortune (1. November 2026), Sekundärquelle (geprüft am 03.11.2026)
Einen Fehler in diesem Artikel entdeckt? Melden Sie ihn · Unsere Korrekturrichtlinie
