Analisi
LeCun e Balestriero riportano JEPA che allineano testo e immagini con 42 volte meno campioni
Un preprint arXiv v1 di Balestriero e LeCun riporta un encoder di testo JEPA con pari allineamento alle immagini con 42 volte meno campioni.
- Modelli
- #JEPA
- #Yann LeCun
- #Randall Balestriero
- #apprendimento di rappresentazioni
- #previsione del token successivo
- #rappresentazione platonica
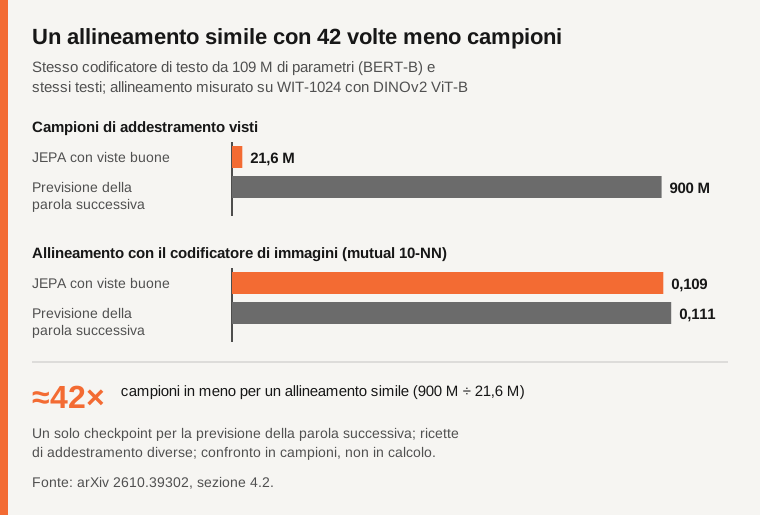
Al 3 novembre 2026 un preprint di Randall Balestriero e Yann LeCun (arXiv 2610.39302, versione 1, 29 ottobre 2026) riporta che un encoder di testo addestrato come JEPA raggiunge circa lo stesso allineamento con un modello di immagini della previsione del token successivo (0,109 contro 0,111), usando 21,6 milioni di campioni di addestramento invece di 900 milioni, circa 42 volte meno. Sono risultati degli autori, non replicati in modo indipendente a nostra conoscenza.
L'essenziale
- Che cosa dimostrano gli autori: in ipotesi idealizzate, JEPA addestrate separatamente convergono alla stessa rappresentazione a meno di una rotazione.
- Che cosa misura il 42x: campioni di addestramento, in un solo checkpoint, per un solo punteggio di allineamento. Non è un risparmio di calcolo.
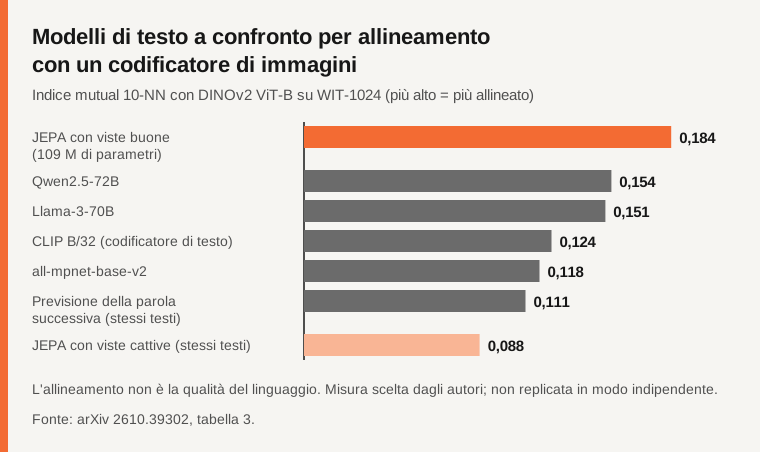
- Che cosa mostra la tabella 109M contro 72B: un encoder di testo JEPA da 109 milioni di parametri ottiene su un indice di allineamento alle immagini un punteggio più alto di modelli linguistici della classe dei 70 miliardi.
- Che cosa non è accertato: che questo migliori la qualità del linguaggio, o che altri gruppi ottengano gli stessi numeri.
Che cos'è l'ipotesi della rappresentazione platonica?
L'ipotesi (Huh et al.) afferma che modelli addestrati separatamente, anche su tipi di dati diversi, tendono verso un'unica immagine condivisa del mondo. È stata osservata, non dimostrata. Una JEPA (joint-embedding predictive architecture, architettura predittiva a embedding congiunto) addestra un encoder di contesto e un encoder di destinazione ad avvicinare gli embedding di due «viste» correlate della stessa cosa. «Allineamento» qui significa che gli embedding di due modelli collocano gli stessi elementi vicino agli stessi vicini.
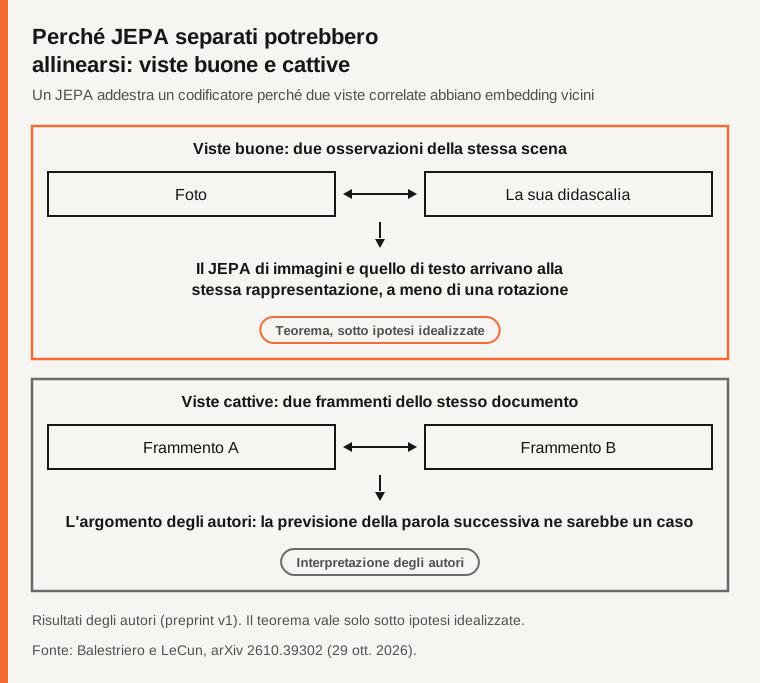
Il teorema principale del preprint afferma che, se ogni modalità condivide la stessa distribuzione di coppie positive e i minimizzatori sono unici a meno di una rotazione, tutti gli encoder coincidono a meno di una rotazione. Circa k coppie ben collocate basterebbero a trovare quella rotazione.
La distinzione che conta è tra «buone viste» e «cattive viste». Le buone viste sono due osservazioni di una stessa scena, come una foto e la sua didascalia. Le cattive viste sono due pezzi di uno stesso documento. Gli autori sostengono, come interpretazione che presentano come ipotesi da verificare, che la previsione del token successivo sia una JEPA con cattive viste, per cui i modelli linguistici si allineerebbero alla visione solo su larga scala.
Fonte: Balestriero e LeCun, arXiv 2610.39302.
Il teorema presuppone ottimi idealizzati, un mondo finito, un predittore identità e l'unicità a meno di una rotazione. Non copre le JEPA con un predittore appreso.
Che cosa misura esattamente «42 volte meno»?
Il confronto (sezione 4.2) usa lo stesso encoder di testo da 109 milioni di parametri (BERT-B) e le stesse didascalie di immagini dal web (Recap-DataComp). L'allineamento è l'indice mutual 10-NN (10 vicini più prossimi reciproci) rispetto a DINOv2 ViT-B su WIT-1024. La JEPA con buone viste ottiene 0,109 dopo 21,6 milioni di campioni. La previsione del token successivo ottiene 0,111 dopo 900 milioni. Il rapporto, 900 su 21,6, è circa 42.
Fonte: arXiv 2610.39302, sezione 4.2.
Tre avvertenze dal testo. Le due esecuzioni usano ricette diverse, con learning rate e dimensioni del batch differenti. C'è un solo checkpoint per la previsione del token successivo, non una curva di apprendimento confrontabile. E il conteggio è in campioni, non in calcolo. A parità di campioni (21,6 milioni, con un encoder da 33 milioni di parametri), gli autori riportano un divario maggiore, 0,108 contro 0,071.
Come si confronta con i grandi modelli linguistici?
Sullo stesso indice (WIT-1024 con DINOv2 ViT-B), la tabella 3 degli autori dà 0,184 per la JEPA da 109 milioni di parametri, 0,154 per Qwen2.5-72B e 0,151 per Llama-3-70B. L'encoder di testo di CLIP B/32 ottiene 0,124, all-mpnet-base-v2 0,118, la previsione del token successivo sugli stessi testi 0,111 e una JEPA con cattive viste 0,088.
Fonte: arXiv 2610.39302, tabella 3.
Altre misure vanno nella stessa direzione: CKA lineare di 0,507 contro 0,418 per Qwen2.5-72B, e 0,161 contro 0,108 su COCO. Ma la JEPA non vince ovunque. Nel recupero di immagini su Flickr (R@1) ottiene 0,478, poco sotto l'encoder di testo di CLIP (0,489) e all-mpnet (0,481), addestrati su coppie. L'abstract riporta anche il 64 % di accuratezza top-5 zero-shot su ImageNet-100 senza dati accoppiati, contro al massimo il 56 % per modelli linguistici fino a 8 miliardi di parametri.
Quali limiti riconoscono gli autori?
Un quarto seed casuale con un peso SIGReg raddoppiato ha dato 0,121, il che porta la media su quattro seed a 0,168, ancora sopra ogni modello linguistico della tabella. Il modello che ha scritto la maggior parte delle didascalie vede le immagini attraverso CLIP ViT-L/14. Almeno 43 delle 1.024 didascalie di WIT compaiono nei testi di addestramento, anche se rimuoverle cambia il punteggio per meno di 0,002. La JEPA con cattive viste a 940 milioni di campioni è un solo seed. Tre esecuzioni su 36 sono collassate senza gradient clipping.
Che cosa non è accertato?
Che l'allineamento con la visione migliori la qualità del linguaggio o del ragionamento. Che il risultato valga con altre ricette, dataset o metriche. La replicazione indipendente e la revisione tra pari, che non abbiamo visto. Il calcolo totale, poiché i confronti sono in campioni. Startup Fortune (1º novembre) ha ripreso le cifre; è una sola fonte di stampa.
Tabella di confronto
| Punto | Cosa dicono le fonti al 3 nov. 2026 | Fonte |
|---|---|---|
| Teorema | JEPA addestrate separatamente coincidono a meno di una rotazione, in ipotesi idealizzate | arXiv 2610.39302 |
| 42x | 21,6M di campioni a 0,109 contro 900M a 0,111; un solo checkpoint, ricette diverse | arXiv 2610.39302 |
| 109M contro 72B | Mutual 10-NN 0,184 contro 0,154 (Qwen2.5-72B), rispetto a DINOv2 ViT-B | arXiv 2610.39302 |
| Replicazione | Nessuna riportata a nostra conoscenza; preprint v1 | arXiv, Startup Fortune |
Domande frequenti
JEPA batte i grandi modelli linguistici?
Non accertato. La misura è l'allineamento con encoder di immagini, non la qualità del linguaggio.
Il 42x è un risparmio di calcolo?
No. Conta campioni di addestramento, in un solo checkpoint, con ricette diverse.
Il risultato è stato riprodotto?
Non a nostra conoscenza. È la versione 1 di un preprint.
Metodo e limiti
Abbiamo letto il preprint il 3 novembre 2026 tramite riassunti automatici dell'abstract e della versione HTML, circa 100.000 caratteri su 255.000. Le sezioni 6 e 7, le appendici e la fine della 5.2 non sono state lette. Non abbiamo eseguito test, non abbiamo trovato verifiche indipendenti e non offriamo consulenza d'investimento.
Fonti
- Balestriero e LeCun, Proving and Improving the Platonic Representation Hypothesis with JEPAs, arXiv 2610.39302 (29 ottobre 2026) (verificato il 2026-11-03)
- arXiv 2610.39302, versione HTML (verificato il 2026-11-03)
- Startup Fortune (1º novembre 2026), fonte secondaria (verificato il 2026-11-03)
Avete notato un errore in questo articolo? Segnalatelo · La nostra politica sulle correzioni
