Análise
A Revolut faz do GLM auto-hospedado sua escolha padrão para código assistido por IA e diz que os custos caíram cerca de 90%, com Claude Code e Codex agora a exceção, segundo uma palestra relatada pelo The Register
A Revolut diz que o GLM auto-hospedado é seu padrão para código com IA, o Claude Code a exceção, e que os custos caíram cerca de 90%. Não verificado.
Em 3 de novembro de 2026, o The Register (Tobias Mann) relatou uma palestra de David Abitbol, responsável por operações e infraestrutura da Revolut, na conferência AI Engineer, em Nova York, em outubro de 2026. Segundo o relato, a Revolut fez dos modelos auto-hospedados sua escolha padrão para código assistido por IA, em vez de serviços comerciais como o Claude. Os números são da própria Revolut e não foram verificados de forma independente. Lemos as fontes apenas por resumos automáticos. Isto não é aconselhamento de investimento nem jurídico.
O essencial
- O que a Revolut diz: o GLM da Z.ai (Zhipu) auto-hospedado é o padrão para cerca de 2.000 engenheiros; Claude Code e Codex são a exceção (The Register).
- A afirmação: os custos de inferência do código assistido por IA caíram cerca de 90% em menos de um ano, ou seja, 10 vezes (The Register).
- Não é uma remoção: Claude Code e Codex continuam disponíveis; um roteador envia algumas requisições a outros modelos.
- Não estabelecido: a base de comparação, se o hardware entra na conta, a versão do GLM e qualquer verificação independente.
O que a Revolut diz ter mudado
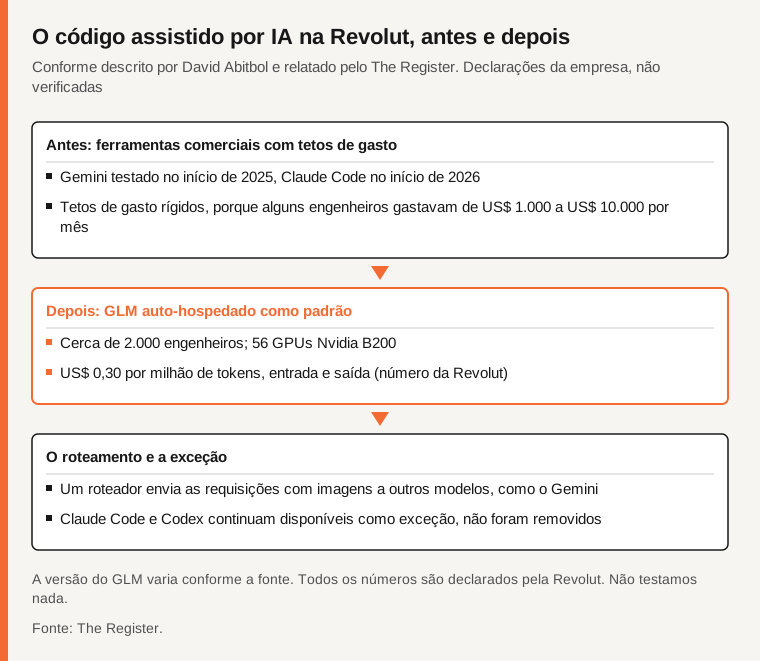
Segundo o The Register, a Revolut testou o Gemini no início de 2025 e o Claude Code no início de 2026. As ferramentas foram lançadas com tetos de gasto rígidos, porque alguns engenheiros gastavam entre US$ 1.000 e US$ 10.000 por mês (Abitbol, via The Register). A Revolut passou então ao GLM da Z.ai, primeiro o GLM-5.1, depois o GLM-5.3. O Emergent menciona só o GLM-5.3, e um resumo que cita a StartupHub, que não lemos, fala em GLM 4.5; por isso não ligamos o custo a uma versão. Para o estado dos modelos abertos, incluindo o GLM-5.3, veja nosso panorama de outubro.
Para o GLM-5.3, o The Register indica 56 GPUs Nvidia B200 (sete sistemas DGX B200), cerca de 754 bilhões de parâmetros (cerca de 40 bilhões ativos por token) e cerca de 380 GB de memória de GPU para os pesos. Os ganhos vieram de ajustes, da quantização NVFP4 e da separação entre prefill e decode, não de mais GPUs.
Fonte: The Register.
Quanto, e em comparação com quê?
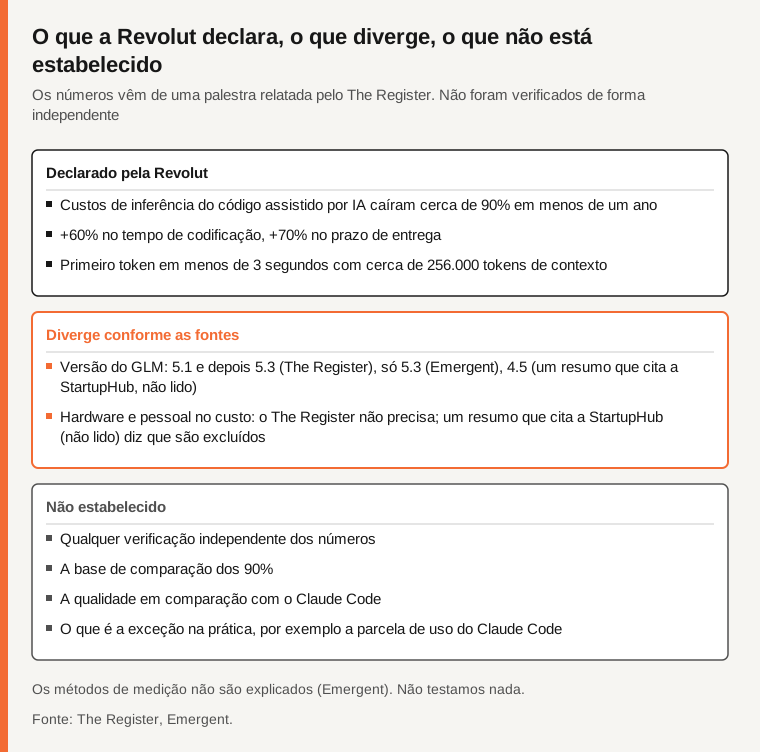
O The Register informa que auto-hospedar o GLM custa US$ 0,30 por milhão de tokens (entrada e saída), cerca de um décimo do Codex ou do Claude Code, com cobrança fixa. Não diz se a amortização do hardware está incluída. Um resumo que cita a StartupHub (não lido) afirma que os US$ 0,30 excluem nuvem, pessoal e observabilidade, então a economia total pode ser menor. O Emergent observa que a base de comparação não é detalhada.
A Revolut declara ainda um primeiro token em menos de 3 segundos com cerca de 256.000 tokens de contexto. Informa +60% no tempo de codificação e +70% no prazo de entrega; segundo Abitbol, os ganhos vêm sobretudo da depuração e do tratamento de tickets do Jira e do Confluence, não da geração de código. O Emergent observa que os métodos de medição não são explicados.
Não é uma substituição total
Segundo o The Register, o GLM não substitui por completo o GPT nem o Claude. Ele se limita a texto e é pouco adequado ao trabalho de interface; por isso um roteador envia as requisições com imagens a modelos como o Gemini, enquanto a geração de código continua no GLM. Abitbol chama os modelos de fronteira de “a exceção”. Eles não foram removidos, e o que isso significa na prática, por exemplo a parcela de uso do Claude Code, não é informado.
As ressalvas
Abitbol reconhece preocupações de privacidade e segurança com os modelos abertos chineses. Na visão dele, o principal risco é o acesso por APIs hospedadas na China, e a implantação local ou em uma nuvem regional o reduz (The Register). Não acrescentamos avaliação própria.
Fonte: The Register, Emergent.
O que não está estabelecido?
O número verificado e sua base; se hardware, pessoal e observabilidade entram no custo; a versão exata do GLM; a qualidade em comparação com o Claude Code, sem teste independente; como os +60% e +70% foram medidos; a reação da Anthropic; se outros farão o mesmo.
Tabela comparativa
| Ponto | O que dizem as fontes | Situação |
|---|---|---|
| Padrão para código com IA | GLM auto-hospedado; Claude Code e Codex a exceção | Declarado pela Revolut |
| Custo de inferência | Cerca de 90% menor em menos de um ano | Declarado pela Revolut |
| Preço do GLM | US$ 0,30 por milhão de tokens, hardware não especificado | Relatado pelo The Register |
| Produtividade | +60% tempo de codificação, +70% prazo de entrega | Declarado pela Revolut |
| Versão do GLM | 5.1 depois 5.3, só 5.3 ou 4.5, conforme a fonte | Divergente |
| Verificação independente | Nenhuma lida | Não estabelecido |
Perguntas frequentes
A Revolut parou de usar o Claude Code?
Não, segundo o The Register: continuam disponíveis como exceção.
Os 90% foram verificados?
Não. É uma afirmação da Revolut em uma palestra, sem base de comparação detalhada.
Que hardware é preciso?
A Revolut indica 56 GPUs Nvidia B200 para o GLM-5.3.
Método e limites
Lemos o The Register por resumo automático em 4 de novembro de 2026, além de dois textos de segunda mão. Não lemos a palestra, nenhum comunicado da Revolut, a Cybernews nem a StartupHub, e não vimos comentário da Anthropic, da OpenAI ou da Z.ai. Nada foi testado.
Fontes
- The Register, Tobias Mann, lido em um resumo automático
- Emergent, de segunda mão, lido em um resumo automático
- Pasquale Pillitteri, de segunda mão, lido em um resumo automático
Encontrou um erro neste artigo? Avise-nos · Nossa política de correções
