Análisis
Revolut hace de GLM autoalojado su opción por defecto para el código asistido por IA y dice que los costes bajaron un 90 % aproximadamente, con Claude Code y Codex como excepción, según una charla recogida por The Register
Revolut dice que GLM autoalojado es su opción por defecto para el código con IA, Claude Code la excepción, y que los costes bajaron un 90 %. Sin verificar.
El 3 de noviembre de 2026, The Register (Tobias Mann) recogió una charla de David Abitbol, responsable de operaciones e infraestructura de Revolut, en la conferencia AI Engineer de Nueva York en octubre de 2026. Según esa crónica, Revolut ha hecho de los modelos autoalojados su opción por defecto para el código asistido por IA, en lugar de servicios comerciales como Claude. Las cifras son de Revolut y no están verificadas de forma independiente. Solo leímos las fuentes mediante resúmenes automáticos. Esto no es asesoramiento de inversión ni jurídico.
Lo esencial
- Lo que dice Revolut: GLM de Z.ai (Zhipu) autoalojado es la opción por defecto para unos 2000 ingenieros; Claude Code y Codex son la excepción (The Register).
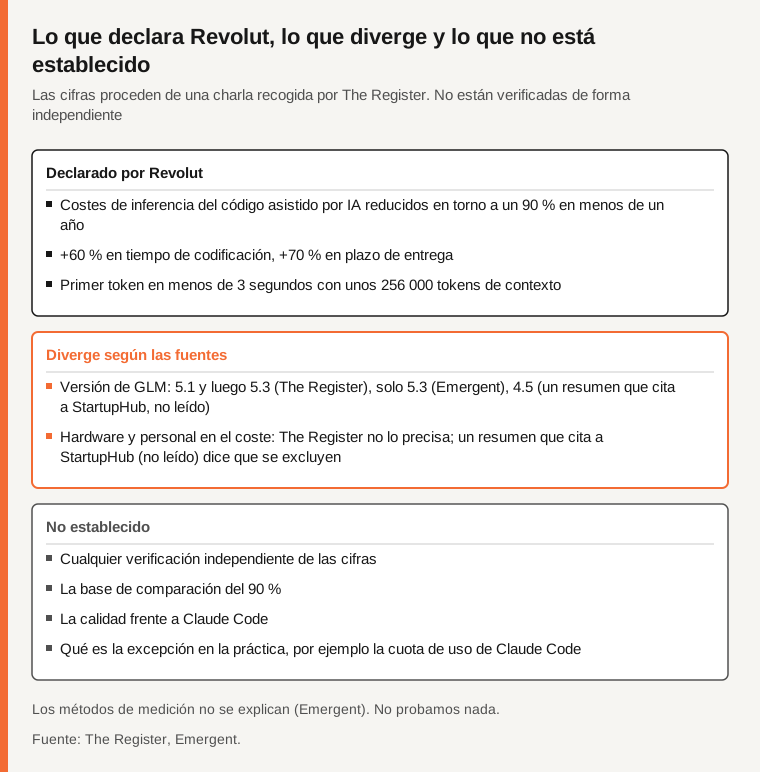
- La afirmación: los costes de inferencia del código asistido por IA bajaron en torno a un 90 % en menos de un año, es decir, 10 veces (The Register).
- No es una supresión: Claude Code y Codex siguen disponibles; un enrutador envía algunas solicitudes a otros modelos.
- No establecido: la base de comparación, si se incluye el hardware, la versión de GLM y cualquier verificación independiente.
Lo que Revolut dice haber cambiado
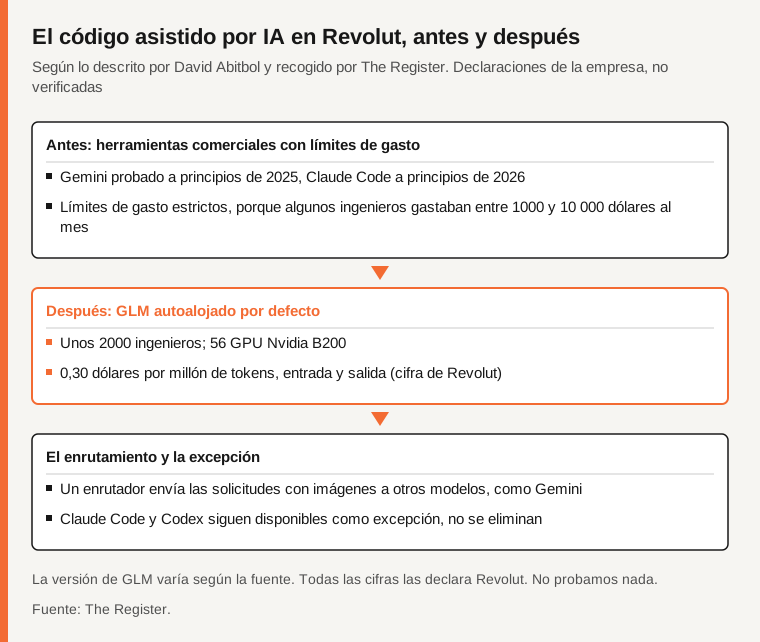
Según The Register, Revolut probó Gemini a principios de 2025 y Claude Code a principios de 2026. Las herramientas se lanzaron con límites de gasto estrictos, porque algunos ingenieros gastaban entre 1000 y 10 000 dólares al mes (Abitbol, vía The Register). Después Revolut pasó a GLM de Z.ai, primero GLM-5.1 y luego GLM-5.3. Emergent solo menciona GLM-5.3, y un resumen que cita a StartupHub, que no leímos, habla de GLM 4.5, así que no atamos el coste a una versión. Para ver el estado de los modelos abiertos, incluido GLM-5.3, consulte nuestro repaso de octubre.
Para GLM-5.3, The Register indica 56 GPU Nvidia B200 (siete sistemas DGX B200), unos 754 000 millones de parámetros (unos 40 000 millones activos por token) y unos 380 GB de memoria de GPU para los pesos. Las mejoras vinieron del ajuste, la cuantización NVFP4 y la separación prefill/decode, no de más GPU.
Fuente: The Register.
¿Cuánto, y respecto a qué?
The Register informa de que autoalojar GLM cuesta 0,30 dólares por millón de tokens (entrada y salida), alrededor de una décima parte de Codex o Claude Code, con facturación fija. No dice si se incluye la amortización del hardware. Un resumen que cita a StartupHub (no leído) afirma que los 0,30 dólares excluyen nube, personal y observabilidad, por lo que el ahorro total podría ser menor. Emergent señala que la base de comparación no está detallada.
Revolut declara además un primer token en menos de 3 segundos con unos 256 000 tokens de contexto. Anuncia +60 % en tiempo de codificación y +70 % en plazo de entrega; según Abitbol, las mejoras vienen sobre todo de la depuración y del tratamiento de tickets de Jira y Confluence, no de la generación de código. Emergent señala que no se explican los métodos de medición.
No es un reemplazo total
Según The Register, GLM no sustituye por completo a GPT ni a Claude. Se limita al texto y es poco adecuado para el trabajo de interfaz, así que un enrutador envía las solicitudes con imágenes a modelos como Gemini, mientras que la generación de código sigue en GLM. Abitbol llama a los modelos de frontera «la excepción». No se eliminan, y lo que eso significa en la práctica, por ejemplo la cuota de uso de Claude Code, no se indica.
Las reservas
Abitbol reconoce inquietudes de privacidad y seguridad sobre los modelos abiertos chinos. En su opinión, el riesgo principal es el acceso mediante API alojadas en China, y el despliegue en local o en una nube regional lo reduce (The Register). No añadimos ninguna valoración propia.
Fuente: The Register, Emergent.
¿Qué no está establecido?
La cifra verificada y su base; si el hardware, el personal y la observabilidad entran en el coste; la versión exacta de GLM; la calidad frente a Claude Code, sin prueba independiente; cómo se midieron el +60 % y el +70 %; la reacción de Anthropic; si otros harán lo mismo.
Tabla comparativa
| Punto | Lo que dicen las fuentes | Estado |
|---|---|---|
| Opción por defecto para el código con IA | GLM autoalojado; Claude Code y Codex la excepción | Declarado por Revolut |
| Coste de inferencia | En torno a un 90 % menos en menos de un año | Declarado por Revolut |
| Precio de GLM | 0,30 dólares por millón de tokens, hardware sin precisar | Informado por The Register |
| Productividad | +60 % tiempo de codificación, +70 % plazo de entrega | Declarado por Revolut |
| Versión de GLM | 5.1 y luego 5.3, solo 5.3 o 4.5, según la fuente | Divergente |
| Verificación independiente | Ninguna leída | No establecido |
Preguntas frecuentes
¿Dejó Revolut de usar Claude Code?
No según The Register: siguen disponibles como excepción.
¿Están verificados los 90 %?
No. Es una afirmación de Revolut en una charla, sin base de comparación detallada.
¿Qué hardware hace falta?
Revolut indica 56 GPU Nvidia B200 para GLM-5.3.
Método y límites
Leímos The Register mediante un resumen automático el 4 de noviembre de 2026, más dos textos de segunda mano. No leímos la charla, ningún comunicado de Revolut, Cybernews ni StartupHub, y no vimos ningún comentario de Anthropic, OpenAI o Z.ai. No probamos nada.
Fuentes
- The Register, Tobias Mann, resumen automático
- Emergent, de segunda mano, resumen automático
- Pasquale Pillitteri, de segunda mano, resumen automático
¿Ha detectado un error en este artículo? Comuníquenoslo · Nuestra política de correcciones
