Analisi
Revolut rende GLM in self-hosting la sua scelta predefinita per il codice assistito dall'IA e dichiara costi in calo del 90% circa, con Claude Code e Codex ora l'eccezione, secondo un intervento riportato da The Register
Revolut dice che GLM in self-hosting è la sua scelta predefinita per il codice con IA, Claude Code l'eccezione, e costi in calo del 90%. Non verificato.
Il 3 novembre 2026 The Register (Tobias Mann) ha riportato l'intervento di David Abitbol, responsabile di operazioni e infrastruttura di Revolut, alla conferenza AI Engineer di New York nell'ottobre 2026. Secondo il resoconto, Revolut ha reso i modelli in self-hosting la sua scelta predefinita per il codice assistito dall'IA, al posto di servizi commerciali come Claude. Le cifre sono di Revolut e non sono verificate in modo indipendente. Abbiamo letto le fonti solo tramite riassunti automatici. Questo non è un consiglio di investimento né legale.
L'essenziale
- Che cosa dice Revolut: GLM di Z.ai (Zhipu) in self-hosting è la scelta predefinita per circa 2.000 ingegneri; Claude Code e Codex sono l'eccezione (The Register).
- L'affermazione: i costi di inferenza del codice assistito dall'IA sono calati di circa il 90% in meno di un anno, cioè 10 volte (The Register).
- Non una rimozione: Claude Code e Codex restano disponibili; un router invia alcune richieste ad altri modelli.
- Non accertato: la base di confronto, se l'hardware è incluso, la versione di GLM e qualsiasi verifica indipendente.
Che cosa Revolut dice di aver cambiato
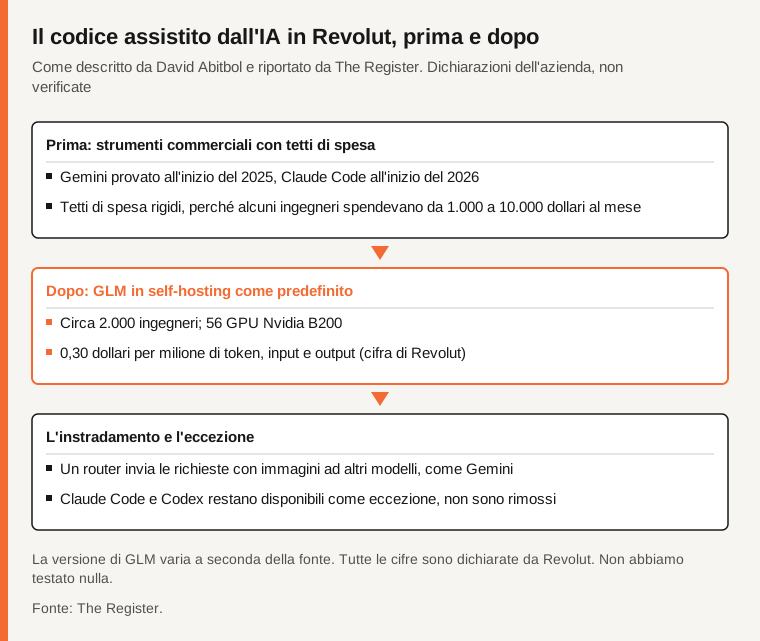
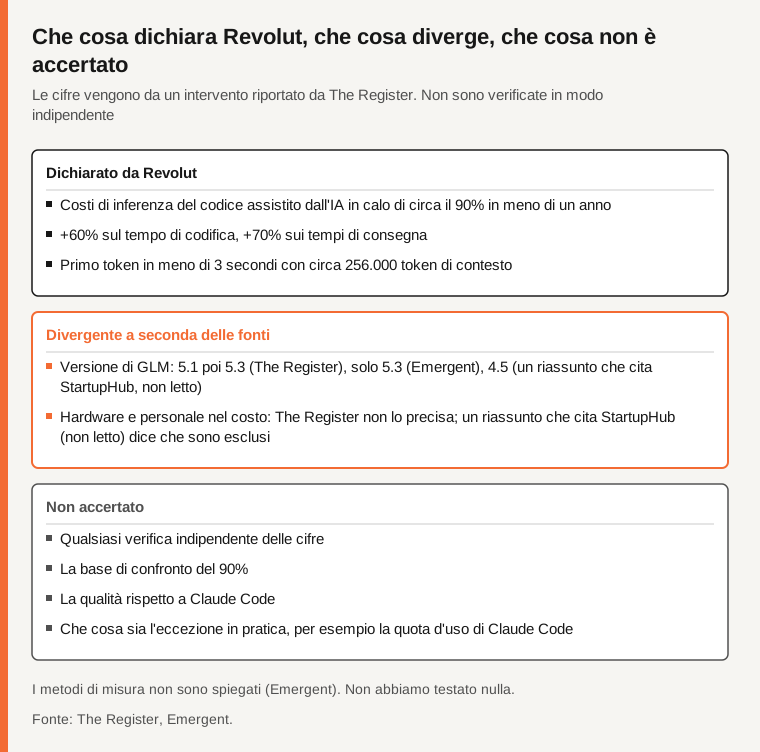
Secondo The Register, Revolut ha provato Gemini all'inizio del 2025 e Claude Code all'inizio del 2026. Gli strumenti sono stati lanciati con tetti di spesa rigidi, perché alcuni ingegneri spendevano tra 1.000 e 10.000 dollari al mese (Abitbol, via The Register). Revolut è poi passata a GLM di Z.ai, prima GLM-5.1, poi GLM-5.3. Emergent cita solo GLM-5.3, e un riassunto che cita StartupHub, che non abbiamo letto, parla di GLM 4.5: non leghiamo quindi il costo a una versione. Per lo stato dei modelli aperti, GLM-5.3 compreso, vedi il nostro quadro di ottobre.
Per GLM-5.3, The Register indica 56 GPU Nvidia B200 (sette sistemi DGX B200), circa 754 miliardi di parametri (circa 40 miliardi attivi per token) e circa 380 GB di memoria GPU per i pesi. I miglioramenti sono venuti da messa a punto, quantizzazione NVFP4 e separazione prefill/decode, non da altre GPU.
Fonte: The Register.
Quanto, e rispetto a che cosa?
The Register riporta che il self-hosting di GLM costa 0,30 dollari per milione di token (input e output), circa un decimo di Codex o Claude Code, con fatturazione forfettaria. Non dice se l'ammortamento dell'hardware è incluso. Un riassunto che cita StartupHub (non letto) afferma che gli 0,30 dollari escludono cloud, personale e osservabilità, quindi il risparmio totale potrebbe essere minore. Emergent nota che la base di confronto non è dettagliata.
Revolut dichiara inoltre un primo token in meno di 3 secondi con circa 256.000 token di contesto. Indica +60% sul tempo di codifica e +70% sui tempi di consegna; secondo Abitbol i guadagni vengono soprattutto dal debug e dalla gestione dei ticket Jira e Confluence, non dalla generazione di codice. Emergent nota che i metodi di misura non sono spiegati.
Non una sostituzione totale
Secondo The Register, GLM non sostituisce del tutto GPT né Claude. È limitato al testo e poco adatto al lavoro sull'interfaccia, quindi un router invia le richieste con immagini a modelli come Gemini, mentre la generazione di codice resta su GLM. Abitbol chiama i modelli di frontiera «l'eccezione». Non sono rimossi, e che cosa questo significhi in pratica, per esempio la quota d'uso di Claude Code, non è indicato.
Le riserve
Abitbol riconosce preoccupazioni di riservatezza e sicurezza sui modelli aperti cinesi. A suo giudizio il rischio principale è l'accesso tramite API ospitate in Cina, e un'installazione in sede o in un cloud regionale lo riduce (The Register). Non aggiungiamo alcuna valutazione nostra.
Fonte: The Register, Emergent.
Che cosa non è accertato?
La cifra verificata e la sua base; se hardware, personale e osservabilità rientrano nel costo; la versione esatta di GLM; la qualità rispetto a Claude Code, senza test indipendenti; come sono stati misurati il +60% e il +70%; la reazione di Anthropic; se altri faranno lo stesso.
Tabella comparativa
| Punto | Che cosa dicono le fonti | Stato |
|---|---|---|
| Scelta predefinita per il codice con IA | GLM in self-hosting; Claude Code e Codex l'eccezione | Dichiarato da Revolut |
| Costo di inferenza | Circa il 90% in meno in meno di un anno | Dichiarato da Revolut |
| Prezzo di GLM | 0,30 dollari per milione di token, hardware non precisato | Riportato da The Register |
| Produttività | +60% tempo di codifica, +70% tempi di consegna | Dichiarato da Revolut |
| Versione di GLM | 5.1 poi 5.3, solo 5.3 o 4.5, a seconda della fonte | Divergente |
| Verifica indipendente | Nessuna letta | Non accertato |
Domande frequenti
Revolut ha smesso di usare Claude Code?
Non secondo The Register: restano disponibili come eccezione.
Il 90% è verificato?
No. È un'affermazione di Revolut in un intervento, senza base di confronto dettagliata.
Che hardware serve?
Revolut indica 56 GPU Nvidia B200 per GLM-5.3.
Metodo e limiti
Abbiamo letto The Register tramite riassunto automatico il 4 novembre 2026, più due testi di seconda mano. Non abbiamo letto l'intervento, alcun comunicato di Revolut, Cybernews né StartupHub, e non abbiamo visto commenti di Anthropic, OpenAI o Z.ai. Nulla è stato testato.
Fonti
- The Register, Tobias Mann, riassunto automatico
- Emergent, di seconda mano, riassunto automatico
- Pasquale Pillitteri, di seconda mano, riassunto automatico
Avete notato un errore in questo articolo? Segnalatelo · La nostra politica sulle correzioni
