Analyse
Revolut macht selbst gehostetes GLM zum Standard für KI-gestütztes Programmieren und nennt um rund 90 % gesunkene Kosten, Claude Code und Codex sind nun die Ausnahme, laut einem Vortrag, über den The Register berichtet
Revolut sagt, selbst gehostetes GLM sei der Standard fürs KI-Programmieren, Claude Code die Ausnahme, die Kosten seien um etwa 90 % gesunken. Ungeprüft.
Am 3. November 2026 berichtete The Register (Tobias Mann) über einen Vortrag von David Abitbol, Leiter für Betrieb und Infrastruktur bei Revolut, auf der Konferenz AI Engineer in New York im Oktober 2026. Laut dem Bericht hat Revolut selbst gehostete Modelle zum Standard für KI-gestütztes Programmieren gemacht, statt kommerzieller Dienste wie Claude. Die Zahlen stammen von Revolut und sind nicht unabhängig überprüft. Wir haben die Quellen nur über automatische Zusammenfassungen gelesen. Dies ist weder Anlage- noch Rechtsberatung.
Das Wichtigste
- Was Revolut sagt: Selbst gehostetes GLM von Z.ai (Zhipu) ist der Standard für etwa 2.000 Ingenieure; Claude Code und Codex sind die Ausnahme (The Register).
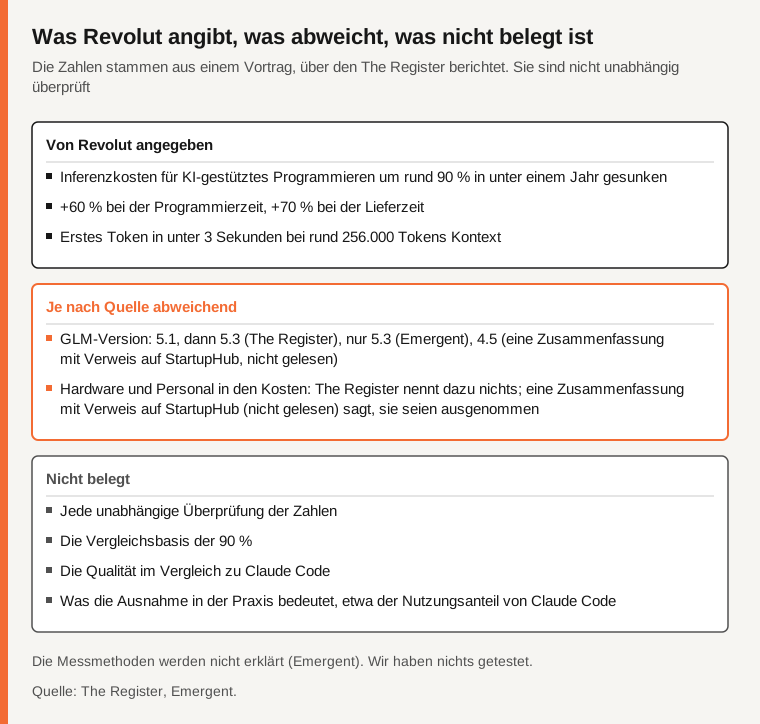
- Die Behauptung: Die Inferenzkosten für KI-gestütztes Programmieren sanken in unter einem Jahr um rund 90 %, also auf ein Zehntel (The Register).
- Keine Abschaffung: Claude Code und Codex bleiben verfügbar; ein Router leitet manche Anfragen an andere Modelle.
- Nicht belegt: die Vergleichsbasis, ob Hardware eingerechnet ist, die GLM-Version und jede unabhängige Prüfung.
Was Revolut nach eigener Aussage geändert hat
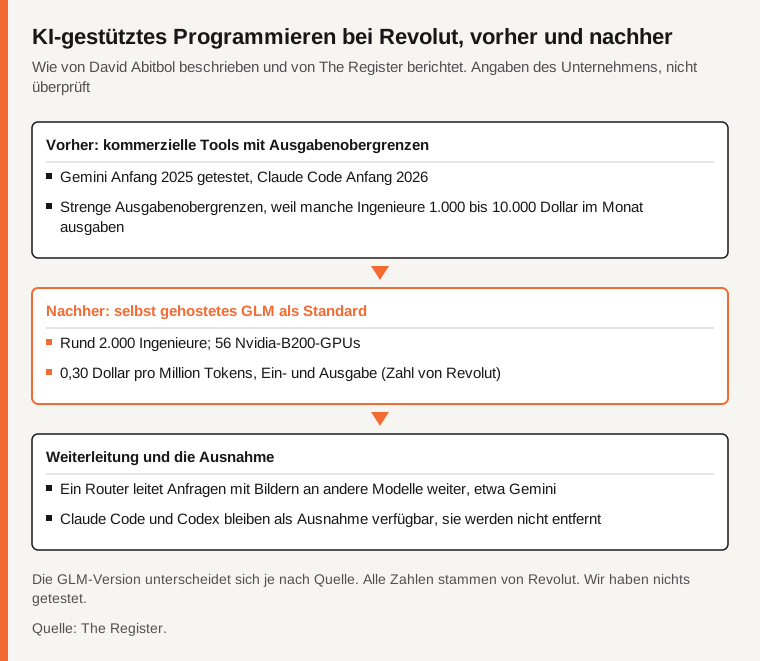
Laut The Register testete Revolut Gemini Anfang 2025 und Claude Code Anfang 2026. Die Tools wurden mit strengen Ausgabenobergrenzen gestartet, weil manche Ingenieure zwischen 1.000 und 10.000 Dollar im Monat ausgaben (Abitbol, laut The Register). Danach wechselte Revolut zu GLM von Z.ai, zuerst GLM-5.1, dann GLM-5.3. Emergent nennt nur GLM-5.3, und eine Zusammenfassung mit Verweis auf StartupHub, das wir nicht gelesen haben, spricht von GLM 4.5; wir verknüpfen die Kosten daher nicht mit einer Version. Zum Stand offener Modelle, GLM-5.3 eingeschlossen, siehe unseren Überblick vom Oktober.
Für GLM-5.3 nennt The Register 56 Nvidia-B200-GPUs (sieben DGX-B200-Systeme), rund 754 Milliarden Parameter (rund 40 Milliarden aktiv pro Token) und rund 380 GB GPU-Speicher für die Gewichte. Die Verbesserungen kamen von Feinabstimmung, NVFP4-Quantisierung und der Trennung von Prefill und Decode, nicht von zusätzlichen GPUs.
Quelle: The Register.
Wie viel, und im Vergleich zu was?
The Register berichtet, dass das Selbst-Hosting von GLM 0,30 Dollar pro Million Tokens (Ein- und Ausgabe) kostet, rund ein Zehntel von Codex oder Claude Code, bei pauschaler Abrechnung. Ob die Abschreibung der Hardware eingerechnet ist, sagt der Bericht nicht. Eine Zusammenfassung mit Verweis auf StartupHub (nicht gelesen) sagt, die 0,30 Dollar schlössen Cloud, Personal und Observability aus, die Gesamtersparnis könnte also kleiner sein. Emergent merkt an, die Vergleichsbasis sei nicht näher beschrieben.
Revolut gibt außerdem ein erstes Token in unter 3 Sekunden bei rund 256.000 Tokens Kontext an. Es nennt +60 % bei der Programmierzeit und +70 % bei der Lieferzeit; laut Abitbol stammen die Gewinne vor allem aus dem Debuggen und der Bearbeitung von Jira- und Confluence-Tickets, nicht aus der Codegenerierung. Emergent merkt an, die Messmethoden würden nicht erklärt.
Kein vollständiger Ersatz
Laut The Register ersetzt GLM weder GPT noch Claude vollständig. Es ist auf Text beschränkt und für Oberflächenarbeit wenig geeignet, daher leitet ein Router Anfragen mit Bildern an Modelle wie Gemini weiter, während die Codegenerierung auf GLM bleibt. Abitbol nennt die Spitzenmodelle „die Ausnahme“. Sie werden nicht entfernt, und was das praktisch bedeutet, etwa der Nutzungsanteil von Claude Code, wird nicht genannt.
Die Vorbehalte
Abitbol räumt Bedenken zu Datenschutz und Sicherheit bei chinesischen offenen Modellen ein. Das Hauptrisiko sei seiner Ansicht nach der Zugriff über in China gehostete APIs, und ein Betrieb vor Ort oder in einer regionalen Cloud verringere es (The Register). Wir fügen keine eigene Bewertung hinzu.
Quelle: The Register, Emergent.
Was ist nicht belegt?
Die geprüfte Zahl und ihre Basis; ob Hardware, Personal und Observability in den Kosten stecken; die genaue GLM-Version; die Qualität im Vergleich zu Claude Code, ohne unabhängigen Test; wie die +60 % und +70 % gemessen wurden; die Reaktion von Anthropic; ob andere folgen.
Vergleichstabelle
| Punkt | Was die Quellen sagen | Status |
|---|---|---|
| Standard für KI-Programmieren | Selbst gehostetes GLM; Claude Code und Codex die Ausnahme | Von Revolut angegeben |
| Inferenzkosten | Rund 90 % weniger in unter einem Jahr | Von Revolut angegeben |
| Preis von GLM | 0,30 Dollar pro Million Tokens, Hardware nicht präzisiert | Von The Register berichtet |
| Produktivität | +60 % Programmierzeit, +70 % Lieferzeit | Von Revolut angegeben |
| GLM-Version | 5.1 dann 5.3, nur 5.3 oder 4.5, je nach Quelle | Abweichend |
| Unabhängige Prüfung | Keine gelesen | Nicht belegt |
Häufige Fragen
Hat Revolut aufgehört, Claude Code zu nutzen?
Laut The Register nicht: Beide bleiben als Ausnahme verfügbar.
Sind die 90 % geprüft?
Nein. Es ist eine Aussage von Revolut aus einem Vortrag, ohne ausführliche Vergleichsbasis.
Welche Hardware braucht man?
Revolut nennt 56 Nvidia-B200-GPUs für GLM-5.3.
Methode und Grenzen
Wir haben The Register am 4. November 2026 über eine automatische Zusammenfassung gelesen, dazu zwei Texte aus zweiter Hand. Nicht gelesen haben wir den Vortrag, eine Mitteilung von Revolut, Cybernews oder StartupHub, und wir sahen keinen Kommentar von Anthropic, OpenAI oder Z.ai. Nichts wurde getestet.
Quellen
- The Register, Tobias Mann, per automatischer Zusammenfassung gelesen
- Emergent, aus zweiter Hand, per automatischer Zusammenfassung gelesen
- Pasquale Pillitteri, aus zweiter Hand, per automatischer Zusammenfassung gelesen
Einen Fehler in diesem Artikel entdeckt? Melden Sie ihn · Unsere Korrekturrichtlinie
