Analyse
Meituan stellt LongCat-2.5 Preview vor, ein Agentenmodell mit 1,6 Billionen Parametern und noch unveröffentlichten Gewichten
Meituan kündigt LongCat-2.5 an, ein Mixture-of-Experts-Modell mit rund 1,6 Billionen Parametern. Gewichte geplant, nicht veröffentlicht; keine Benchmarks.
Meituan hat LongCat-2.5 angekündigt, ein multimodales Mixture-of-Experts-Modell mit insgesamt rund 1,6 Billionen Parametern, ausgelegt auf lang laufende Arbeit von KI-Agenten. Veröffentlichungen der Gewichte werden als geplant beschrieben, wir fanden aber weder ein Repository noch ein Datum oder eine Lizenz. Benchmarks sind nicht veröffentlicht.
Das Wesentliche
- Was Meituan ankündigt: ein Mixture-of-Experts-Modell mit insgesamt rund 1,6 Billionen Parametern und rund 48 Milliarden aktiven pro Token, das Text und Bilder verarbeitet.
- Die Gewichte: laut TechNode, das sich auf IT Home beruft, sollen sie später folgen; eine Tracking-Seite schreibt, sie seien nicht veröffentlicht und das Modell nur über eine API erreichbar.
- Nicht veröffentlicht: Benchmarks, Lizenz, Veröffentlichungsdatum der Gewichte, offizielle Preise.
- Das Datum: Die Quellen weichen ab, zwischen einer seit dem 25. September 2026 gelisteten Preview und einer auf den 2. November 2026 datierten Ankündigung.
Was kündigt Meituan an?
Laut TechNode (2. November 2026), das IT Home weitergibt, ist LongCat-2.5 ein Mixture-of-Experts-Modell mit insgesamt rund 1,6 Billionen Parametern und rund 48 Milliarden aktiven pro Token. Nach unserer gerundeten Rechnung sind das etwa 3 % der Gesamtzahl (48 / 1.600). zavino.co merkt an, dass eine in manchen Schlagzeilen gesehene Zahl von „16 Billionen“ falsch ist.
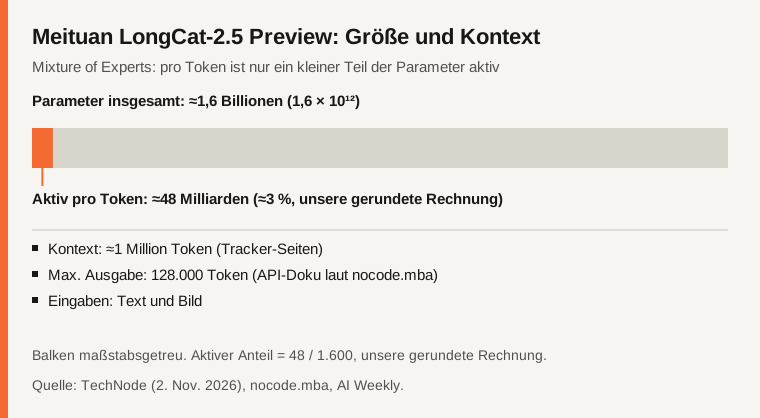
Quelle: TechNode (2. November 2026), nocode.mba, AI Weekly.
Tracking-Seiten nennen einen Kontext von rund 1 Million Token (ZenMux führt 1,05 Millionen) und eine maximale Ausgabe von 128.000 Token laut nocode.mba, das die API-Dokumentation von Meituan zitiert. TechNode nennt keines von beiden.
Wofür ist es laut Meituan gedacht?
TechNode zufolge zielt das Modell auf Aufgaben, die eine anhaltende Ausführung durch KI-Agenten erfordern, besonders bei komplexen Codebasen und vollständigen Softwareprojekten. Das Training kombiniert erweiterte Sequenzen langer Aufgaben, Reinforcement Learning im großen Maßstab und Fehler, auf die echte Agenten stießen und die in reproduzierbare Trainingsaufgaben umgewandelt wurden.
Das Modell verarbeitet visuelle und textuelle Eingaben in einem einheitlichen Token-Rahmen. Genannte Einsatzbereiche sind visuelles Coding, kreatives Design und 3D-Aufgaben. Die Ausgaben sind nicht näher bestimmt.
Der Zugang läuft über Meituans Online-Chat-Dienst und seine API-Plattform. Die Tracking-Seite nocode.mba listet auf dieser API eine „LongCat-2.5-Preview“ mit Endpunkten im OpenAI- und im Anthropic-Format. Die Kompatibilität mit Claude Code, Hermes, OpenClaw, OpenCode und Kilo Code nennen nocode.mba und ZenMux, nicht TechNode.
Wie steht es um die Veröffentlichung der Gewichte?
TechNode schreibt unter Berufung auf IT Home, Veröffentlichungen auf GitHub und Hugging Face seien als Nächstes geplant, ohne Datum und ohne Lizenz. Die Seite nocode.mba schreibt, die Gewichte seien nicht veröffentlicht und das Modell nur über die API erreichbar. Eine Websuche fand kein LongCat-2.5-Repository. Laut mehreren Artikeln wurde der Vorgänger LongCat-2.0 am 30. Juni 2026 mit offenen Gewichten veröffentlicht.
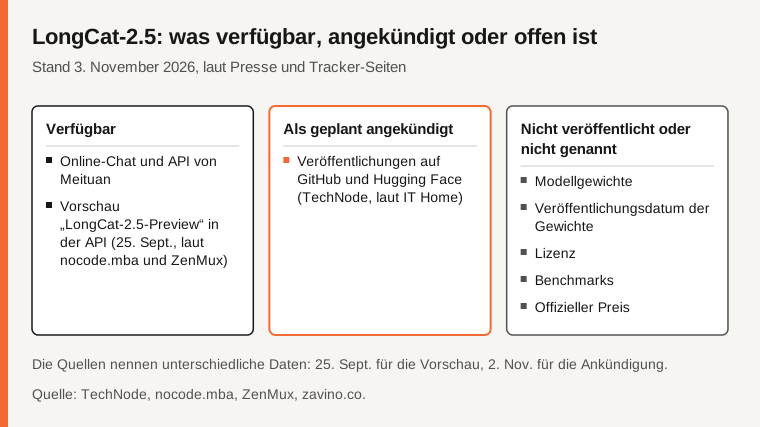
Quelle: TechNode, nocode.mba, ZenMux, zavino.co.
Welches Datum gilt?
Die Quellen weichen ab, und wir entscheiden das nicht. nocode.mba und ZenMux listen die „LongCat-2.5-Preview“ seit dem 25. September 2026 auf Meituans API. TechNode datiert die Ankündigung von „LongCat-2.5“, dem multimodalen Modell, auf den 2. November 2026.
Was ist nicht belegt?
Das Veröffentlichungsdatum und die Lizenz der Gewichte; die Kontextgröße laut Meituan; die offiziellen Preise; die multimodalen Ausgaben; die Leistung; und welches Datum gilt.
Vergleichstabelle
| Punkt | Was die Quellen Stand 3. Nov. 2026 sagen | Quelle |
|---|---|---|
| Architektur | Mixture of Experts, insgesamt rund 1,6 Bio., rund 48 Mrd. aktiv pro Token | TechNode, AI Weekly |
| Eingaben | Text und Bild, einheitlicher Token-Rahmen | TechNode |
| Kontext | Rund 1 Million Token (1,05 Mio. bei ZenMux); maximale Ausgabe 128.000 | nocode.mba, ZenMux |
| Gewichte | GitHub und Hugging Face als Nächstes geplant; laut einer Tracking-Seite nicht veröffentlicht | TechNode, nocode.mba |
| Benchmarks | Keine von Meituan veröffentlicht | nocode.mba, zavino.co, AI Weekly |
| Preis | ZenMux zeigt 0,30 $ pro Million Eingabe-Token und rund 1,18 $ für die Ausgabe, mit Rabatt angezeigt; von Meituan nicht bestätigt | ZenMux |
Häufig gestellte Fragen
Ist LongCat-2.5 Open Source?
Bisher nicht. Gewichte werden als geplant beschrieben, aber keine sind veröffentlicht, ohne Datum und ohne Lizenz.
Wie viele Parameter hat LongCat-2.5?
Insgesamt rund 1,6 Billionen und rund 48 Milliarden aktiv pro Token, laut TechNode und AI Weekly.
Hat LongCat-2.5 Benchmarks?
Meituan hat für diese Preview keine veröffentlicht; die Aussagen beruhen auf seinen eigenen Ergebnissen.
Methode und Grenzen
Meituans Beiträge auf X ließen sich nicht öffnen. Wir haben die Seiten über automatische Zusammenfassungen gelesen, nichts getestet und keinen unabhängigen Benchmark gefunden. Dies ist keine Anlageberatung.
Quellen
- TechNode, „Meituan launches LongCat-2.5 multimodal AI model for extended coding tasks“ (2. November 2026), unter Berufung auf IT Home (geprüft am 03.11.2026)
- AI Weekly (2.-3. November 2026) (geprüft am 03.11.2026)
- nocode.mba, Release-Tracker, Sekundärquelle (geprüft am 03.11.2026)
- ZenMux, Modellseite, Aggregator (geprüft am 03.11.2026)
- zavino.co, Sekundärquelle (geprüft am 03.11.2026)
Einen Fehler in diesem Artikel entdeckt? Melden Sie ihn · Unsere Korrekturrichtlinie
