Analisi
Un avvocato generale della CGUE afferma che le risposte di un chatbot che riprendono articoli di stampa possono violare i diritti degli editori, nella prima causa sull'IA generativa
Per l'avvocato generale Szpunar, un chatbot che riprende articoli di stampa può, in certe circostanze, violare diritti degli editori. Non vincolante.
Il 3 novembre 2026 l'avvocato generale Maciej Szpunar ha consigliato alla Corte di giustizia dell'UE di dire che i chatbot che recuperano e riutilizzano in tempo reale pubblicazioni di stampa online per rispondere agli utenti possono, in certe circostanze, violare i diritti degli editori di giornali. La Corte descrive la causa come la prima sull'IA generativa a giungere davanti a sé. Le conclusioni non vincolano la Corte, che deciderà più avanti. Abbiamo letto il comunicato della Corte, non il testo integrale delle conclusioni.
L'essenziale
- La causa: C-250/25 Like Company, un operatore ungherese di portali web, contro Google per le risposte del suo chatbot Gemini, su rinvio di un tribunale di Budapest.
- L'idea centrale: le risposte di un chatbot possono, in certe circostanze, violare il diritto dell'editore di giornali. Contano due fattori: come si è avuto accesso alla pubblicazione e se la risposta ne riprende in modo riconoscibile la forma di espressione.
- L'addestramento: le due questioni sull'addestramento sono irricevibili, a suo avviso. Di passaggio, suggerisce che l'addestramento sia, di regola, liberamente consentito dall'eccezione per il text and data mining.
- Stato: le conclusioni non sono vincolanti. I giudici iniziano la deliberazione e la sentenza arriverà in una data successiva, che la Corte non indica.
Per una causa di quotidiani sulla ricerca con IA, si veda il nostro articolo sul New York Times e Brave.
Che cosa dice l'avvocato generale?
Szpunar consiglia alla Corte di dire che il recupero e il riutilizzo in tempo reale di pubblicazioni di stampa online da parte di chatbot di IA, per generare risposte agli utenti, possono in certe circostanze violare i diritti degli editori di giornali. La causa riguarda Alphabet (Google Ireland), che fornisce Google Gemini, un chatbot di IA generativa basato su grandi modelli linguistici (LLM). Gemini usa la generazione aumentata dal recupero (Retrieval-Augmented Generation) per raccogliere informazioni dal web in tempo reale.
Like Company si è rivolta al tribunale regionale di Budapest. Sostiene che i suoi articoli siano protetti dal diritto connesso dell'editore di giornali (articolo 15, paragrafo 1, della direttiva (UE) 2019/790) e afferma che Google li ha riprodotti e messi a disposizione del pubblico tramite Gemini più volte tra il 13 giugno 2023 e il 31 maggio 2024. Il giudice ungherese ha posto quattro questioni: due sull'addestramento di un LLM e due sulle risposte del chatbot.
Il diritto non tutela i semplici fatti, solo la loro forma di espressione specifica. Il suo scopo è proteggere l'investimento nella pubblicazione, non dare un monopolio sulle notizie.
Quali criteri valgono per le risposte di un chatbot?
Per il diritto di riproduzione, le conclusioni indicano due fattori. Primo: il chatbot ha avuto accesso alla pubblicazione in modo illecito, in particolare aggirando misure tecniche efficaci, come un paywall, destinate a limitare l'accesso o il web scraping? Secondo: la risposta si limita a riferire fatti contenuti nella pubblicazione, oppure ne riprende la forma di espressione in modo riconoscibile, al punto che l'utente, leggendo la risposta, è del tutto dispensato dall'accedere alla pubblicazione originale?
Quanto al diritto di messa a disposizione del pubblico, di regola è violato quando la forma di espressione della pubblicazione è sistematicamente riconoscibile nelle risposte del chatbot a richieste correlate degli utenti.
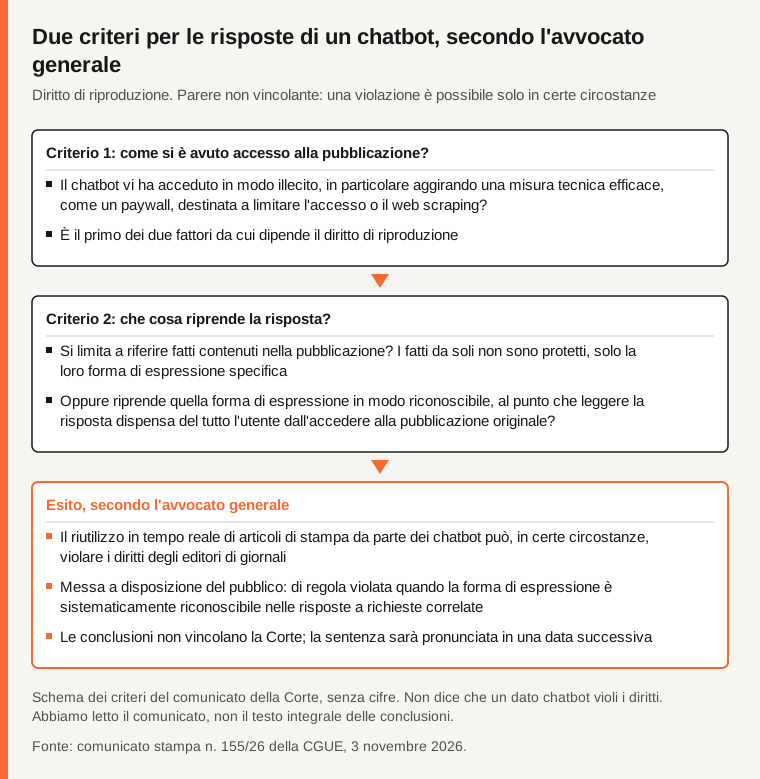
Fonte: comunicato della CGUE n. 155/26.
Il fornitore del chatbot online è responsabile di questi possibili atti quando sono inerenti al suo modello di business, o quando non ha adottato misure adeguate per contrastarli in modo credibile ed efficace.
E l'addestramento?
L'avvocato generale consiglia di dichiarare irricevibili le due questioni sull'addestramento. Non vi è prova che gli articoli siano serviti ad addestrare gli LLM di Gemini, quindi le questioni sono ipotetiche, dice. Per completezza, suggerisce che l'uso di opere protette per addestrare un LLM sia, di regola, liberamente consentito dall'eccezione per il text and data mining (articolo 4 della direttiva). Alcuni media lo riassumono dicendo che l'addestramento è permesso. È una semplificazione: il comunicato della Corte tratta le questioni sull'addestramento come irricevibili e presenta quell'osservazione come un complemento.
Che cosa risponde Google?
Non abbiamo letto alcuna dichiarazione di Google. The Next Web e Dataconomy, letti tramite riassunti automatici, riportano la sua posizione: Gemini non memorizza gli articoli, gli eventuali output contestati rientrerebbero nelle eccezioni per le copie temporanee e per il text and data mining, e Google contesta l'applicabilità del diritto ungherese, poiché Gemini non è stato addestrato in Ungheria. The Next Web, che attribuisce le sue informazioni a Reuters, colloca nell'aprile 2025 il rinvio del tribunale di Budapest.
Che cosa non è accertato?
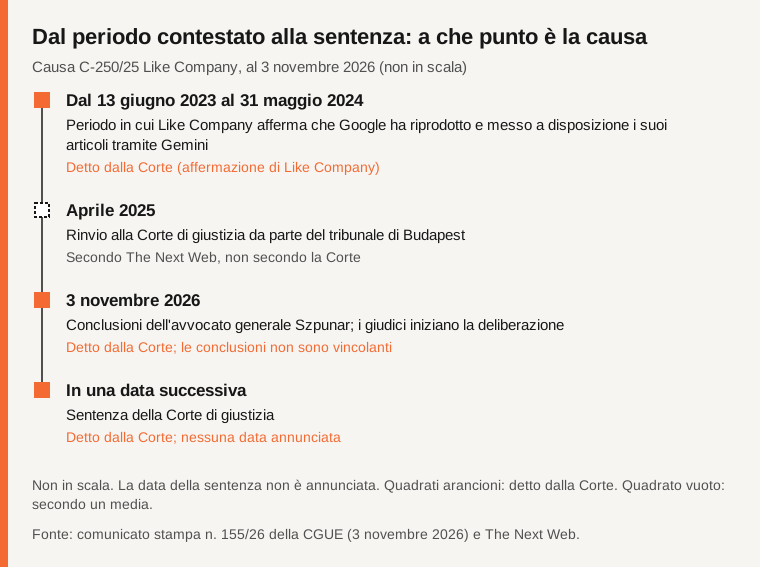
Fonte: comunicato della CGUE n. 155/26, The Next Web.
Se la Corte seguirà il suo avvocato generale: i media dicono che i giudici lo fanno per lo più, un'affermazione generale che non documentano. Quando deciderà: la Corte non indica alcuna data. Se una risposta di Gemini abbia davvero violato diritti: un rinvio pregiudiziale non è la decisione della controversia nazionale, e il giudice ungherese deciderà dopo la sentenza della Corte. Non abbiamo letto nemmeno il testo integrale delle conclusioni, né reazioni di Like Company, né dichiarazioni di Google.
Tabella comparativa
| Punto | Che cosa dicono le fonti | Fonte |
|---|---|---|
| Conclusioni | Il recupero e il riutilizzo in tempo reale da parte dei chatbot possono, in certe circostanze, violare i diritti degli editori di giornali | CGUE |
| La causa | La prima causa sull'IA generativa a giungere alla Corte di giustizia, nelle parole della Corte | CGUE |
| Diritto di riproduzione | Dipende dall'accesso lecito (paywall) e dalla distinzione tra fatti e forma di espressione riconoscibile | CGUE |
| Messa a disposizione | Di regola violato se la forma di espressione è sistematicamente riconoscibile | CGUE |
| Responsabilità | Il fornitore risponde se inerente al suo modello di business o senza misure credibili ed efficaci | CGUE |
| Addestramento | Due questioni irricevibili; osservazione: l'addestramento è di regola liberamente consentito dal text and data mining | CGUE |
| Forza vincolante | Nessuna; sentenza in una data successiva, senza data | CGUE |
| Posizione di Google | Non memorizza gli articoli; si applicano eccezioni; contesta il diritto ungherese | The Next Web, Dataconomy |
| Rinvio | Aprile 2025 | The Next Web |
Domande frequenti
Il chatbot è stato condannato?
No. L'avvocato generale non è la Corte e le sue conclusioni non la vincolano. Anche dopo la sentenza, spetta al giudice ungherese decidere la controversia.
Un chatbot può riassumere le notizie?
Il comunicato dice che il diritto non tutela i semplici fatti, solo la loro forma di espressione specifica. Se una risposta superi il limite dipende dai due fattori sopra. Non abbiamo provato alcun chatbot.
Quando deciderà la Corte?
La Corte non indica una data. Precisa che la sentenza sarà pronunciata in una data successiva.
Metodo e limiti
Abbiamo letto per intero il comunicato della Corte, come testo estratto da un PDF a cui mancano alcune parole, ma non il testo integrale delle conclusioni. The Next Web e Dataconomy sono stati letti tramite riassunti automatici. Non abbiamo letto alcuna reazione di Like Company né alcuna dichiarazione di Google; la posizione di Google viene dai media. Non c'è ancora una sentenza e non abbiamo provato alcun chatbot. Questo non è un consiglio legale né di investimento.
Fonti
- Comunicato della CGUE n. 155/26, Opinion of Advocate General Szpunar in Case C-250/25 Like Company (3 novembre 2026), letto per intero (testo estratto dal PDF)
- The Next Web, letto tramite un riassunto automatico
- Dataconomy (3 novembre), letto tramite un riassunto automatico
Avete notato un errore in questo articolo? Segnalatelo · La nostra politica sulle correzioni
