Análisis
Un abogado general del TJUE afirma que las respuestas de un chatbot que reutilizan artículos de prensa pueden infringir los derechos de los editores, en el primer caso de IA generativa
Para el abogado general Szpunar, un chatbot que reutiliza artículos de prensa puede, en ciertas circunstancias, infringir derechos. No vinculante.
El 3 de noviembre de 2026, el abogado general Maciej Szpunar aconsejó al Tribunal de Justicia de la UE que los chatbots que recuperan y reutilizan en tiempo real publicaciones de prensa en línea para responder a los usuarios pueden, en ciertas circunstancias, infringir los derechos de los editores de prensa. El Tribunal presenta el asunto como el primer caso de IA generativa que le llega. Las conclusiones no vinculan al Tribunal, que resolverá más adelante. Leímos el comunicado del Tribunal, no el texto íntegro de las conclusiones.
Lo esencial
- El asunto: C-250/25 Like Company, un operador húngaro de portales web, contra Google por las respuestas de su chatbot Gemini, remitido por un tribunal de Budapest.
- La idea central: las respuestas de un chatbot pueden, en ciertas circunstancias, infringir el derecho del editor de prensa. Cuentan dos factores: cómo se accedió a la publicación y si la respuesta reutiliza de forma reconocible su forma de expresión.
- El entrenamiento: las dos preguntas sobre el entrenamiento son inadmisibles, según él. De pasada, sugiere que el entrenamiento está, por regla general, libremente permitido por la excepción de minería de textos y datos.
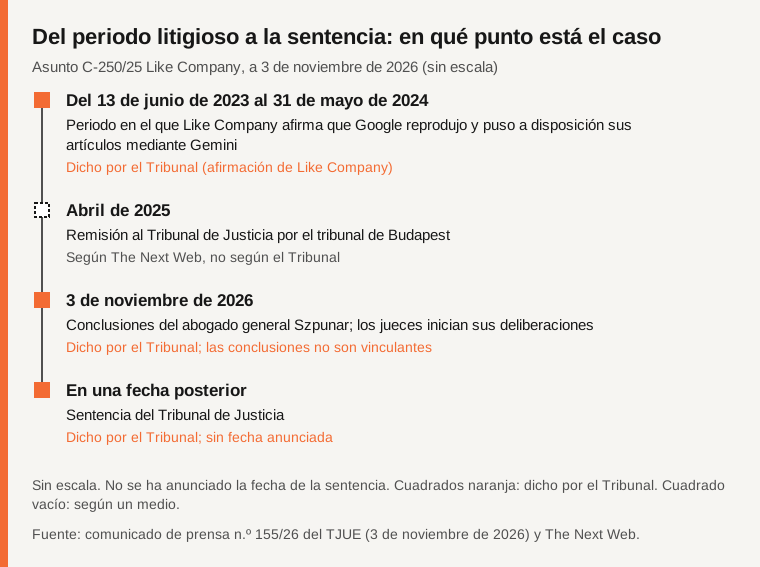
- Estado: las conclusiones no son vinculantes. Los jueces inician sus deliberaciones y la sentencia llegará en una fecha posterior, que el Tribunal no da.
Para una demanda de periódicos sobre la búsqueda con IA, véase nuestro artículo sobre el New York Times y Brave.
¿Qué dice el abogado general?
Szpunar aconseja al Tribunal que declare que la recuperación y la reutilización en tiempo real de publicaciones de prensa en línea por chatbots de IA, para generar respuestas a los usuarios, pueden en ciertas circunstancias infringir los derechos de los editores de prensa. El asunto afecta a Alphabet (Google Ireland), que ofrece Google Gemini, un chatbot de IA generativa basado en grandes modelos de lenguaje (LLM). Gemini recurre a la generación aumentada por recuperación (Retrieval-Augmented Generation) para recopilar información de la web en tiempo real.
Like Company acudió al tribunal regional de Budapest. Sostiene que sus artículos están protegidos por el derecho afín del editor de prensa (artículo 15, apartado 1, de la Directiva (UE) 2019/790) y afirma que Google los reprodujo y los puso a disposición del público a través de Gemini varias veces entre el 13 de junio de 2023 y el 31 de mayo de 2024. El juez húngaro planteó cuatro preguntas: dos sobre el entrenamiento de un LLM y dos sobre las respuestas del chatbot.
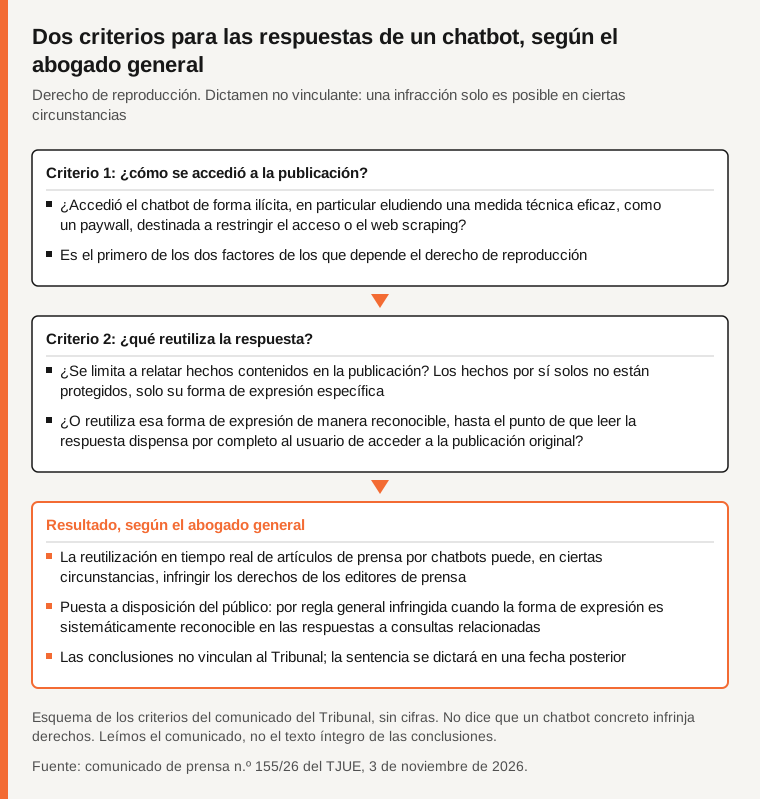
El derecho no protege los simples hechos, solo su forma de expresión específica. Su finalidad es proteger la inversión en la publicación, no dar un monopolio sobre la actualidad.
¿Qué criterios se aplican a las respuestas de un chatbot?
Para el derecho de reproducción, las conclusiones señalan dos factores. Primero, ¿accedió el chatbot a la publicación de forma ilícita, en particular eludiendo medidas técnicas eficaces, como un paywall, destinadas a restringir el acceso o el web scraping? Segundo, ¿se limita la respuesta a relatar hechos contenidos en la publicación, o reutiliza su forma de expresión de manera reconocible, hasta el punto de que el usuario, al leer la respuesta, queda totalmente dispensado de acceder a la publicación original?
En cuanto al derecho de puesta a disposición del público, por regla general se infringe cuando la forma de expresión de la publicación es sistemáticamente reconocible en las respuestas del chatbot a consultas relacionadas de los usuarios.
Fuente: comunicado del TJUE n.º 155/26.
El proveedor del chatbot en línea es responsable de estos posibles actos cuando son inherentes a su modelo de negocio, o cuando no ha implantado medidas adecuadas para combatirlos de forma creíble y eficaz.
¿Y el entrenamiento?
El abogado general aconseja declarar inadmisibles las dos preguntas sobre el entrenamiento. No hay pruebas de que los artículos se usaran para entrenar los LLM de Gemini, por lo que las preguntas son hipotéticas, dice. Para ser completo, sugiere que el uso de obras protegidas para entrenar un LLM está, por regla general, libremente permitido por la excepción de minería de textos y datos (artículo 4 de la directiva). Algunos medios lo resumen como que el entrenamiento está permitido. Es una simplificación: el comunicado del Tribunal trata las preguntas sobre el entrenamiento como inadmisibles y presenta esa observación como un complemento.
¿Qué responde Google?
No leímos ninguna declaración de Google. The Next Web y Dataconomy, leídos mediante resúmenes automáticos, recogen su posición: Gemini no memoriza los artículos, las salidas eventualmente controvertidas entrarían en las excepciones de copias temporales y de minería de textos y datos, y Google discute que se aplique el derecho húngaro, ya que Gemini no se entrenó en Hungría. The Next Web, que atribuye su información a Reuters, sitúa en abril de 2025 la remisión del tribunal de Budapest.
¿Qué no está establecido?
Fuente: comunicado del TJUE n.º 155/26, The Next Web.
Si el Tribunal seguirá a su abogado general: los medios dicen que los jueces suelen hacerlo, una afirmación general que no citan. Cuándo resolverá: el Tribunal no da fecha. Si alguna respuesta de Gemini infringió realmente derechos: una cuestión prejudicial no es la sentencia del litigio nacional, y el tribunal húngaro decidirá después de la sentencia del Tribunal. Tampoco leímos el texto íntegro de las conclusiones, ninguna reacción de Like Company ni ninguna declaración de Google.
Tabla comparativa
| Punto | Lo que dicen las fuentes | Fuente |
|---|---|---|
| Conclusiones | La recuperación y la reutilización en tiempo real por chatbots pueden, en ciertas circunstancias, infringir los derechos de los editores de prensa | TJUE |
| El asunto | El primer caso de IA generativa que llega al Tribunal de Justicia, en palabras del Tribunal | TJUE |
| Derecho de reproducción | Depende del acceso lícito (paywall) y de la diferencia entre hechos y forma de expresión reconocible | TJUE |
| Puesta a disposición | Por regla general infringido si la forma de expresión es sistemáticamente reconocible | TJUE |
| Responsabilidad | El proveedor responde si es inherente a su modelo de negocio o sin medidas creíbles y eficaces | TJUE |
| Entrenamiento | Dos preguntas inadmisibles; observación: el entrenamiento está por regla general libremente permitido por la minería de textos y datos | TJUE |
| Fuerza vinculante | Ninguna; sentencia en una fecha posterior, sin fecha | TJUE |
| Posición de Google | No memoriza los artículos; se aplican excepciones; discute el derecho húngaro | The Next Web, Dataconomy |
| Remisión | Abril de 2025 | The Next Web |
Preguntas frecuentes
¿Se ha condenado al chatbot?
No. El abogado general no es el Tribunal, y sus conclusiones no lo vinculan. Incluso tras la sentencia, corresponde al tribunal húngaro resolver el litigio.
¿Puede un chatbot resumir la actualidad?
El comunicado dice que el derecho no protege los simples hechos, solo su forma de expresión específica. Que una respuesta cruce la línea depende de los dos factores anteriores. No probamos ningún chatbot.
¿Cuándo resolverá el Tribunal?
El Tribunal no da fecha. Indica que la sentencia se dictará en una fecha posterior.
Método y límites
Leímos el comunicado del Tribunal completo, como texto extraído de un PDF al que le faltan algunas palabras, pero no el texto íntegro de las conclusiones. The Next Web y Dataconomy se leyeron mediante resúmenes automáticos. No leímos ninguna reacción de Like Company ni ninguna declaración de Google; la posición de Google procede de los medios. Aún no hay sentencia y no probamos ningún chatbot. Esto no es asesoramiento jurídico ni de inversión.
Fuentes
- Comunicado del TJUE n.º 155/26, Opinion of Advocate General Szpunar in Case C-250/25 Like Company (3 de noviembre de 2026), leído completo (texto extraído del PDF)
- The Next Web, leído mediante un resumen automático
- Dataconomy (3 de noviembre), leído mediante un resumen automático
¿Ha detectado un error en este artículo? Comuníquenoslo · Nuestra política de correcciones
