Analyse
EuGH-Generalanwalt sagt, Chatbot-Antworten, die Presseartikel übernehmen, können Verlegerrechte verletzen, im ersten Fall zu generativer KI
Laut Generalanwalt Szpunar kann ein Chatbot, der Presseartikel übernimmt, unter bestimmten Umständen Verlegerrechte verletzen. Nicht bindend.
Am 3. November 2026 hat Generalanwalt Maciej Szpunar dem Gerichtshof der EU geraten, dass Chatbots, die Presseveröffentlichungen im Netz in Echtzeit abrufen und wiederverwenden, um Nutzern zu antworten, unter bestimmten Umständen die Rechte von Presseverlegern verletzen können. Der Gerichtshof nennt es den ersten Fall zu generativer KI, der bei ihm ankommt. Die Schlussanträge binden den Gerichtshof nicht; er entscheidet später. Wir haben die Pressemitteilung des Gerichtshofs gelesen, nicht den vollen Wortlaut der Schlussanträge.
Das Wichtigste
- Der Fall: Rechtssache C-250/25 Like Company, ein ungarischer Betreiber von Webportalen, gegen Google wegen der Antworten des Chatbots Gemini, vorgelegt von einem Gericht in Budapest.
- Die Kernthese: Chatbot-Antworten können unter bestimmten Umständen das Recht des Presseverlegers verletzen. Zwei Faktoren zählen: wie auf die Veröffentlichung zugegriffen wurde und ob die Antwort ihre Ausdrucksform erkennbar übernimmt.
- Das Training: Die beiden Fragen zum Training sind seiner Ansicht nach unzulässig. Nebenbei regt er an, dass das Training in der Regel durch die Ausnahme für Text und Data Mining frei erlaubt ist.
- Stand: Die Schlussanträge sind nicht bindend. Die Richter beginnen ihre Beratungen, und das Urteil ergeht zu einem späteren Zeitpunkt, den der Gerichtshof nicht nennt.
Zu einer Klage von Zeitungen wegen KI-Suche siehe unseren Artikel zu New York Times und Brave.
Was sagt der Generalanwalt?
Szpunar rät dem Gerichtshof zu der Aussage, dass das Abrufen und Wiederverwenden von Presseveröffentlichungen im Netz in Echtzeit durch KI-Chatbots, um Antworten für Nutzer zu erzeugen, unter bestimmten Umständen die Rechte von Presseverlegern verletzen kann. Es geht um Alphabet (Google Ireland), das Google Gemini anbietet, einen Chatbot für generative KI auf Basis großer Sprachmodelle (LLM). Gemini nutzt Retrieval-Augmented Generation, um Informationen aus dem Web in Echtzeit zu sammeln.
Like Company hat das Hauptstadtgericht Budapest angerufen. Sie beruft sich auf den Schutz ihrer Artikel durch das Leistungsschutzrecht des Presseverlegers (Artikel 15 Absatz 1 der Richtlinie (EU) 2019/790) und sagt, Google habe sie zwischen dem 13. Juni 2023 und dem 31. Mai 2024 mehrfach über Gemini vervielfältigt und öffentlich zugänglich gemacht. Das ungarische Gericht hat vier Fragen gestellt: zwei zum Training eines LLM und zwei zu den Antworten des Chatbots.
Das Recht schützt keine bloßen Tatsachen, sondern nur deren spezifische Ausdrucksform. Sein Zweck ist der Schutz der Investition in die Veröffentlichung, nicht ein Monopol auf Nachrichten.
Welche Kriterien gelten für Chatbot-Antworten?
Für das Vervielfältigungsrecht nennen die Schlussanträge zwei Faktoren. Erstens: Hat der Chatbot rechtswidrig auf die Veröffentlichung zugegriffen, insbesondere durch Umgehung wirksamer technischer Maßnahmen wie einer Paywall, die den Zugang oder das Web-Scraping beschränken sollen? Zweitens: Gibt die Antwort nur Tatsachen aus der Veröffentlichung wieder, oder übernimmt sie deren Ausdrucksform erkennbar, so dass der Nutzer beim Lesen der Antwort vollständig davon entbunden ist, auf die ursprüngliche Veröffentlichung zuzugreifen?
Das Recht der öffentlichen Zugänglichmachung wird in der Regel verletzt, wenn die Ausdrucksform der Veröffentlichung in den Antworten des Chatbots auf verwandte Nutzeranfragen systematisch erkennbar ist.
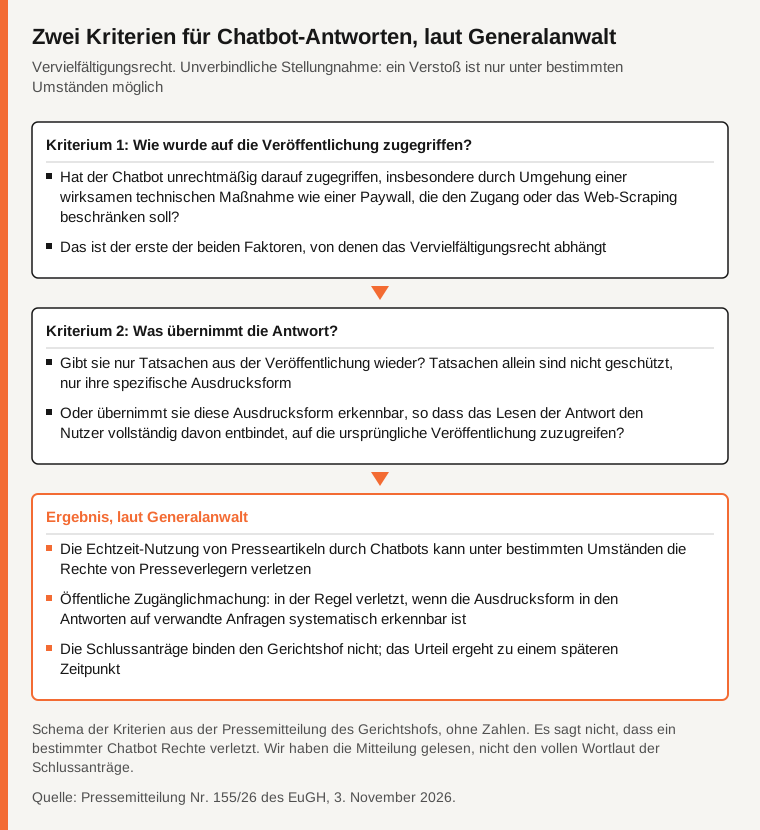
Quelle: Pressemitteilung Nr. 155/26 des EuGH.
Der Anbieter des Online-Chatbots haftet für diese möglichen Handlungen, wenn sie seinem Geschäftsmodell innewohnen oder wenn er keine geeigneten Maßnahmen getroffen hat, um sie glaubwürdig und wirksam zu bekämpfen.
Und das Training?
Der Generalanwalt rät, die beiden Fragen zum Training für unzulässig zu erklären. Es gebe keinen Beleg dafür, dass die Artikel zum Training der LLM von Gemini dienten, die Fragen seien daher hypothetisch. Der Vollständigkeit halber regt er an, dass die Nutzung geschützter Werke zum Training eines LLM in der Regel durch die Ausnahme für Text und Data Mining (Artikel 4 der Richtlinie) frei erlaubt ist. Manche Medien fassen das als Training ist erlaubt zusammen. Das ist eine Vereinfachung: Die Mitteilung des Gerichtshofs behandelt die Fragen zum Training als unzulässig und stellt diese Bemerkung als Ergänzung dar.
Was sagt Google?
Wir haben keine Erklärung von Google gelesen. The Next Web und Dataconomy, per automatischer Zusammenfassung gelesen, geben die Position wieder: Gemini speichere die Artikel nicht, etwaige strittige Ausgaben fielen unter die Ausnahmen für vorübergehende Vervielfältigungen und für Text und Data Mining, und Google bestreitet die Anwendbarkeit des ungarischen Rechts, da Gemini nicht in Ungarn trainiert wurde. The Next Web, das seine Angaben Reuters zuschreibt, datiert die Vorlage des Budapester Gerichts auf April 2025.
Was ist nicht belegt?
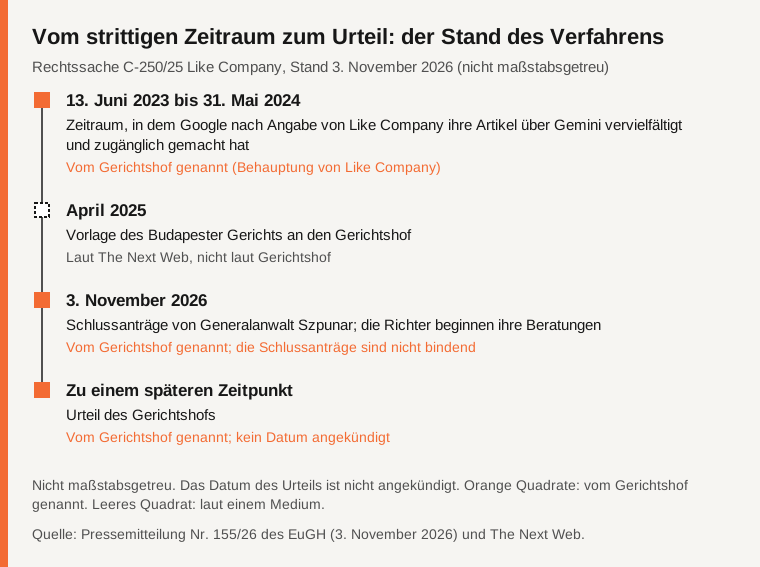
Quelle: Pressemitteilung Nr. 155/26 des EuGH, The Next Web.
Ob der Gerichtshof seinem Generalanwalt folgt: Die Medien sagen, die Richter täten das meistens, eine allgemeine Aussage, die sie nicht belegen. Wann er entscheidet: Der Gerichtshof nennt kein Datum. Ob eine Antwort von Gemini tatsächlich Rechte verletzt hat: Ein Vorabentscheidungsersuchen ist nicht das Urteil im nationalen Streit, und das ungarische Gericht entscheidet nach dem Urteil des Gerichtshofs. Auch den vollen Wortlaut der Schlussanträge, eine Reaktion von Like Company und eine Erklärung von Google haben wir nicht gelesen.
Vergleichstabelle
| Punkt | Was die Quellen sagen | Quelle |
|---|---|---|
| Schlussanträge | Abruf und Wiederverwendung in Echtzeit durch Chatbots können unter bestimmten Umständen Rechte von Presseverlegern verletzen | EuGH |
| Der Fall | Der erste Fall zu generativer KI, der beim Gerichtshof ankommt, in den Worten des Gerichtshofs | EuGH |
| Vervielfältigungsrecht | Hängt vom rechtmäßigen Zugang (Paywall) und von Tatsachen gegenüber erkennbarer Ausdrucksform ab | EuGH |
| Zugänglichmachung | In der Regel verletzt, wenn die Ausdrucksform systematisch erkennbar ist | EuGH |
| Haftung | Anbieter haftet, wenn es seinem Geschäftsmodell innewohnt oder glaubwürdige, wirksame Maßnahmen fehlen | EuGH |
| Training | Zwei Fragen unzulässig; Bemerkung: Training ist in der Regel durch Text und Data Mining frei erlaubt | EuGH |
| Bindungswirkung | Keine; Urteil zu einem späteren Zeitpunkt, ohne Datum | EuGH |
| Position von Google | Speichert die Artikel nicht; Ausnahmen greifen; bestreitet ungarisches Recht | The Next Web, Dataconomy |
| Vorlage | April 2025 | The Next Web |
Häufige Fragen
Wurde der Chatbot verurteilt?
Nein. Der Generalanwalt ist nicht der Gerichtshof, und seine Schlussanträge binden ihn nicht. Auch nach dem Urteil muss das ungarische Gericht den Streit entscheiden.
Kann ein Chatbot Nachrichten zusammenfassen?
Die Mitteilung sagt, das Recht schütze keine bloßen Tatsachen, nur deren spezifische Ausdrucksform. Ob eine Antwort die Grenze überschreitet, hängt von den beiden Faktoren oben ab. Wir haben keinen Chatbot getestet.
Wann entscheidet der Gerichtshof?
Der Gerichtshof nennt kein Datum. Er gibt an, das Urteil werde zu einem späteren Zeitpunkt ergehen.
Methode und Grenzen
Wir haben die Pressemitteilung des Gerichtshofs vollständig gelesen, als aus einem PDF extrahierten Text, in dem einige Wörter fehlen, aber nicht den vollen Wortlaut der Schlussanträge. The Next Web und Dataconomy wurden per automatischer Zusammenfassung gelesen. Wir haben keine Reaktion von Like Company und keine Erklärung von Google gelesen; Googles Position stammt von den Medien. Es gibt noch kein Urteil, und wir haben keinen Chatbot getestet. Dies ist weder Rechts- noch Anlageberatung.
Quellen
- Pressemitteilung Nr. 155/26 des EuGH, Opinion of Advocate General Szpunar in Case C-250/25 Like Company (3. November 2026), vollständig gelesen (aus dem PDF extrahierter Text)
- The Next Web, per automatischer Zusammenfassung gelesen
- Dataconomy (3. November), per automatischer Zusammenfassung gelesen
Einen Fehler in diesem Artikel entdeckt? Melden Sie ihn · Unsere Korrekturrichtlinie
