Análise
Advogado-geral do TJUE afirma que respostas de chatbots que reutilizam artigos de imprensa podem violar os direitos dos editores, no primeiro caso de IA generativa
Para o advogado-geral Szpunar, um chatbot que reutiliza artigos de imprensa pode, em certas circunstâncias, violar direitos de editores. Não é vinculante.
Em 3 de novembro de 2026, o advogado-geral Maciej Szpunar aconselhou o Tribunal de Justiça da UE de que os chatbots que recuperam e reutilizam em tempo real publicações de imprensa online para responder aos usuários podem, em certas circunstâncias, violar os direitos dos editores de imprensa. O Tribunal descreve o caso como o primeiro de IA generativa a chegar até ele. As conclusões não vinculam o Tribunal, que decidirá mais tarde. Lemos o comunicado do Tribunal, não o texto integral das conclusões.
O essencial
- O caso: C-250/25 Like Company, uma operadora húngara de portais web, contra o Google por causa das respostas do seu chatbot Gemini, por reenvio de um tribunal de Budapeste.
- A ideia central: as respostas de um chatbot podem, em certas circunstâncias, violar o direito do editor de imprensa. Dois fatores contam: como a publicação foi acessada e se a resposta reutiliza de forma reconhecível a sua forma de expressão.
- O treinamento: as duas perguntas sobre o treinamento são inadmissíveis, na opinião dele. De passagem, sugere que o treinamento é, em regra, livremente permitido pela exceção de mineração de textos e dados.
- Situação: as conclusões não são vinculantes. Os juízes iniciam as deliberações e o acórdão virá em data posterior, que o Tribunal não indica.
Para uma ação de jornais sobre busca com IA, veja nosso artigo sobre o New York Times e a Brave.
O que diz o advogado-geral?
Szpunar aconselha o Tribunal a dizer que a recuperação e a reutilização em tempo real de publicações de imprensa online por chatbots de IA, para gerar respostas aos usuários, podem em certas circunstâncias violar os direitos dos editores de imprensa. O caso envolve a Alphabet (Google Ireland), que oferece o Google Gemini, um chatbot de IA generativa baseado em grandes modelos de linguagem (LLM). O Gemini usa a geração aumentada por recuperação (Retrieval-Augmented Generation) para coletar informações da web em tempo real.
A Like Company recorreu ao tribunal regional de Budapeste. Alega que seus artigos são protegidos pelo direito conexo do editor de imprensa (artigo 15, n.º 1, da Diretiva (UE) 2019/790) e afirma que o Google os reproduziu e os colocou à disposição do público por meio do Gemini várias vezes entre 13 de junho de 2023 e 31 de maio de 2024. O juiz húngaro fez quatro perguntas: duas sobre o treinamento de um LLM e duas sobre as respostas do chatbot.
O direito não protege os simples fatos, apenas a sua forma de expressão específica. Seu objetivo é proteger o investimento na publicação, não dar um monopólio sobre as notícias.
Que critérios valem para as respostas de um chatbot?
Para o direito de reprodução, as conclusões apontam dois fatores. Primeiro: o chatbot acessou a publicação de forma ilícita, em particular contornando medidas técnicas eficazes, como um paywall, destinadas a restringir o acesso ou o web scraping? Segundo: a resposta se limita a relatar fatos contidos na publicação, ou reutiliza a sua forma de expressão de maneira reconhecível, a ponto de o usuário, ao ler a resposta, ficar totalmente dispensado de acessar a publicação original?
Quanto ao direito de colocação à disposição do público, em regra ele é violado quando a forma de expressão da publicação é sistematicamente reconhecível nas respostas do chatbot a consultas relacionadas dos usuários.
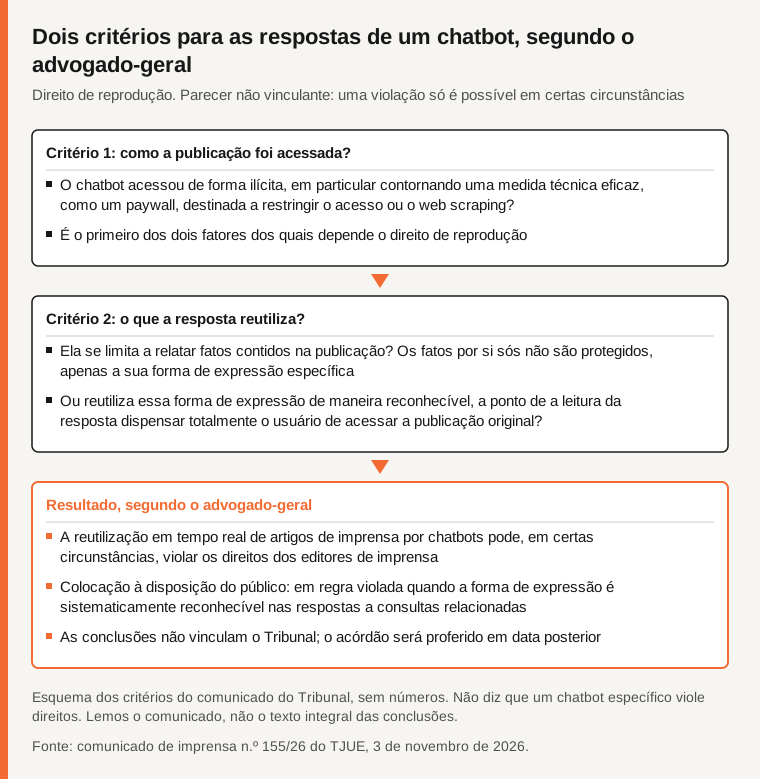
Fonte: comunicado do TJUE n.º 155/26.
O fornecedor do chatbot online é responsável por esses possíveis atos quando eles são inerentes ao seu modelo de negócio, ou quando não adotou medidas adequadas para combatê-los de forma crível e eficaz.
E o treinamento?
O advogado-geral aconselha declarar inadmissíveis as duas perguntas sobre o treinamento. Não há prova de que os artigos tenham servido para treinar os LLM do Gemini, de modo que as perguntas são hipotéticas, diz. Para ser completo, sugere que o uso de obras protegidas para treinar um LLM é, em regra, livremente permitido pela exceção de mineração de textos e dados (artigo 4.º da diretiva). Alguns veículos resumem isso como o treinamento é permitido. É uma simplificação: o comunicado do Tribunal trata as perguntas sobre o treinamento como inadmissíveis e apresenta essa observação como um complemento.
O que responde o Google?
Não lemos nenhuma declaração do Google. O The Next Web e o Dataconomy, lidos por resumos automáticos, relatam a posição: o Gemini não memoriza os artigos, as saídas eventualmente contestadas se enquadrariam nas exceções para cópias temporárias e para mineração de textos e dados, e o Google contesta a aplicação do direito húngaro, já que o Gemini não foi treinado na Hungria. O The Next Web, que atribui suas informações à Reuters, situa em abril de 2025 o reenvio do tribunal de Budapeste.
O que não está estabelecido?
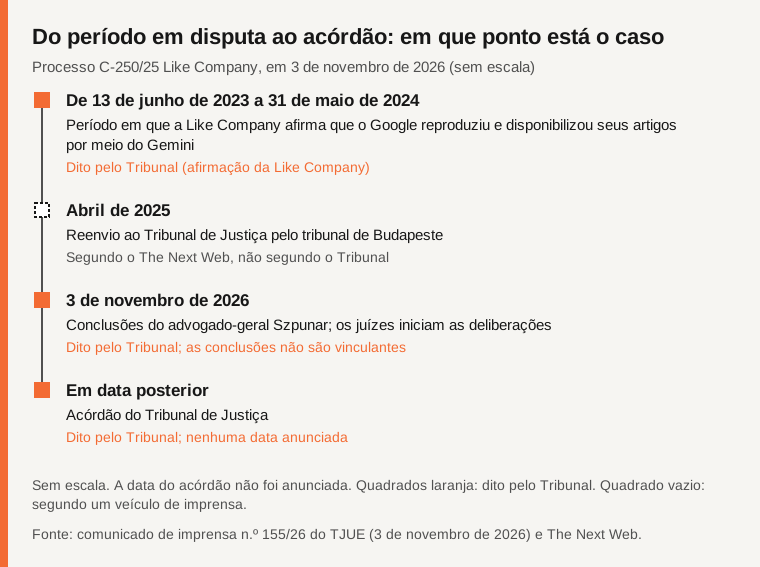
Fonte: comunicado do TJUE n.º 155/26, The Next Web.
Se o Tribunal seguirá o seu advogado-geral: os veículos dizem que os juízes o fazem na maioria das vezes, uma afirmação geral que não citam. Quando decidirá: o Tribunal não indica data. Se alguma resposta do Gemini realmente violou direitos: um reenvio prejudicial não é o julgamento do litígio nacional, e o tribunal húngaro decidirá depois do acórdão do Tribunal. Também não lemos o texto integral das conclusões, nenhuma reação da Like Company nem nenhuma declaração do Google.
Tabela comparativa
| Ponto | O que dizem as fontes | Fonte |
|---|---|---|
| Conclusões | A recuperação e a reutilização em tempo real por chatbots podem, em certas circunstâncias, violar os direitos dos editores de imprensa | TJUE |
| O caso | O primeiro caso de IA generativa a chegar ao Tribunal de Justiça, nas palavras do Tribunal | TJUE |
| Direito de reprodução | Depende do acesso lícito (paywall) e da diferença entre fatos e forma de expressão reconhecível | TJUE |
| Colocação à disposição | Em regra violado quando a forma de expressão é sistematicamente reconhecível | TJUE |
| Responsabilidade | O fornecedor responde se for inerente ao seu modelo de negócio ou sem medidas críveis e eficazes | TJUE |
| Treinamento | Duas perguntas inadmissíveis; observação: o treinamento é em regra livremente permitido pela mineração de textos e dados | TJUE |
| Força vinculante | Nenhuma; acórdão em data posterior, sem data | TJUE |
| Posição do Google | Não memoriza os artigos; aplicam-se exceções; contesta o direito húngaro | The Next Web, Dataconomy |
| Reenvio | Abril de 2025 | The Next Web |
Perguntas frequentes
O chatbot foi condenado?
Não. O advogado-geral não é o Tribunal, e suas conclusões não o vinculam. Mesmo depois do acórdão, cabe ao tribunal húngaro decidir o litígio.
Um chatbot pode resumir as notícias?
O comunicado diz que o direito não protege os simples fatos, apenas a sua forma de expressão específica. Se uma resposta ultrapassa o limite depende dos dois fatores acima. Não testamos nenhum chatbot.
Quando o Tribunal decidirá?
O Tribunal não indica data. Diz que o acórdão será proferido em data posterior.
Método e limites
Lemos o comunicado do Tribunal por inteiro, como texto extraído de um PDF ao qual faltam algumas palavras, mas não o texto integral das conclusões. O The Next Web e o Dataconomy foram lidos por resumos automáticos. Não lemos nenhuma reação da Like Company nem nenhuma declaração do Google; a posição do Google vem dos veículos. Ainda não há acórdão e não testamos nenhum chatbot. Isto não é aconselhamento jurídico nem de investimento.
Fontes
- Comunicado do TJUE n.º 155/26, Opinion of Advocate General Szpunar in Case C-250/25 Like Company (3 de novembro de 2026), lido por inteiro (texto extraído do PDF)
- The Next Web, lido por um resumo automático
- Dataconomy (3 de novembro), lido por um resumo automático
Encontrou um erro neste artigo? Avise-nos · Nossa política de correções
